这是什么
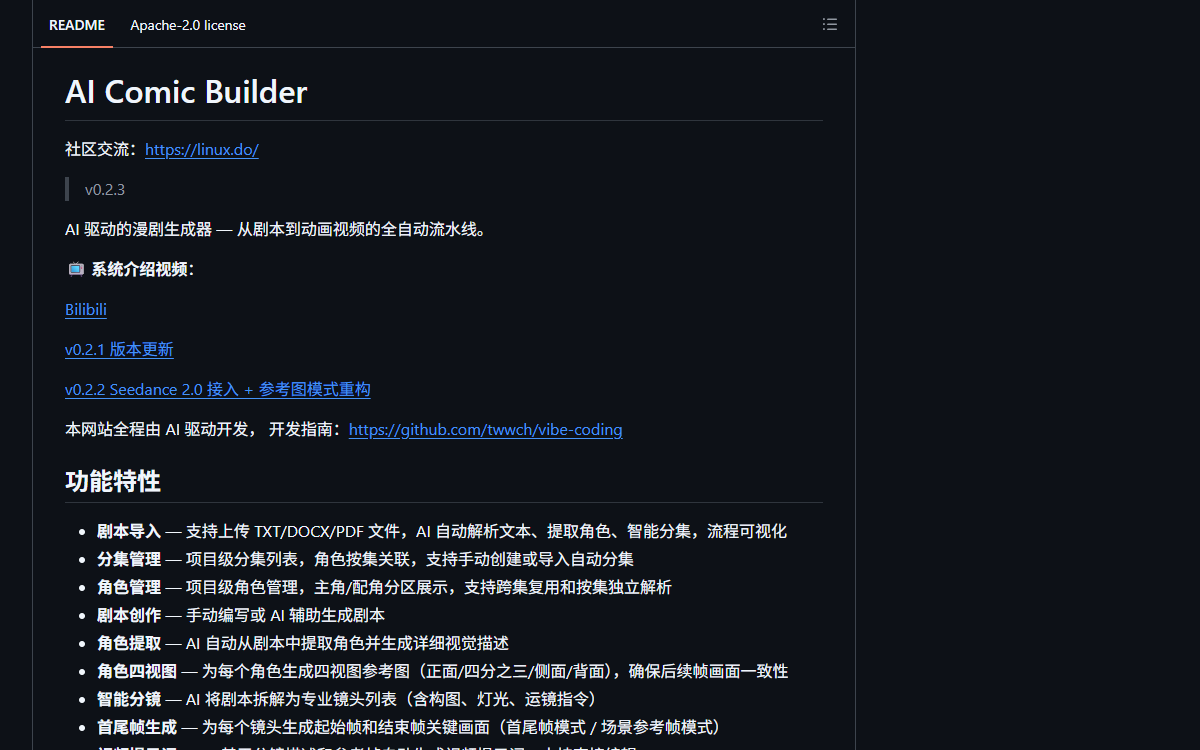
一个可自托管的 Next.js 应用,让剧本到成片全程不用离开浏览器:解析剧本、提取角色、为每个角色生成四视图参考图、把故事拆成镜头、为每个镜头生成首帧与尾帧、写出视频提示词、生成片段,再拼接并烧入字幕。文本、图像、视频模型都可替换——OpenAI、Gemini、Kling、Seedance、Veo——每个阶段都能单独触发或批量执行。它跑在 SQLite 上,用 FFmpeg 处理视频,以 Docker 镜像分发。
谁做的拥有这个仓库的组织。但「代码是谁写的」在这里比通常更难说清:417 次提交里有 409 次带的是一个没有关联 GitHub 账号的邮箱,所以 GitHub 只把 8 次提交记在三个名字名下。已发布的 Docker 镜像属于第四个账号 twwch,而 README 把 twwch/vibe-coding 称作这个代码库的开发指南。
制作过程
8 个阶段- 01
七周、十六个 release,然后安静
仓库创建于 2026-03-11,第一次提交就在当天,v0.0.1 于 2026-03-12 打标签。此后七周里发了十六个 release——从 v0.0.2 到 v0.2.6,没有一个是预发布——3 月提交 292 次、4 月 125 次。而最后一次提交的日期是 2026-04-27,之后再没有任何东西落地。这不等于用户散了:1,883 星、320 fork、7 watcher,而且 pull request 一直开到 2026-05-28、06-21、06-24、07-08、07-29。这些全都出现在最后一次提交之后,而没有一个被合并——要么一直开着,要么直接关闭。12 个 issue 还开着。fork 与星标之比约为六比一,说明不少人是打算真的跑它,而不只是收藏。
- 02
几乎没人的提交算数
这个仓库是「该读 git 作者,而不是读贡献者图」的一个论据。417 次提交里有 409 次来自同一个名字 chenhao,用的是一个没有关联 GitHub 账号的邮箱。于是 GitHub 只记了 8 次提交、分属三个账号——LingyiChen-AI 5 次、dandandujie 2 次、mishiqian 1 次——一个 417 次提交的项目,贡献者列表上只有三个人。Docker 镜像发布在第四个账号
twwch名下,而 README 把twwch/vibe-coding称为这个「全程由 AI 驱动开发」的代码库的开发指南。代码都在,缺的是任何一个能把其中大部分连接起来的身份。 - 03
232 次提交写明了共同作者
超过一半的历史——417 次里的 232 次——带着一条写明模型的共同作者尾注:其中 141 次是 Claude Opus 4.6 (1M context),91 次是 Claude Sonnet 4.6。这比多数项目提供的 AI 参与记录都更精确,因为它是逐次提交的,而不是 README 里的一句话。把它和 README 自称「全程由 AI 驱动」以及那个开发指南链接放在一起,画面就是:一个主要由 agent 写出、由陌生人部分审查、并在七周内发布了十六次的代码库。
- 04
它到底做什么
流水线依次是:剧本输入、剧本解析、角色提取、角色四视图、分镜、逐镜头的参考帧或首尾帧生成、逐镜头的视频提示词、逐镜头的视频生成,最后拼接并烧字幕。决定成品能不能立住的是其中两步。先为角色生成正面、四分之三、侧面、背面四视图,等于给后面每一张图一个固定参照——这是「同一个角色在不同镜头里长得不一样」的常规解法。先生成每个镜头的首帧和尾帧、再在两端之间插值,则把视频生成这个昂贵、缓慢、最难控制的部分,变成两端已定、只剩中间交给运气的东西。数据模型也相应地小:项目持有角色,角色持有参考图,镜头持有提示词、关键帧和视频,另有一个后台任务队列负责执行。
- 05
提示词以 agent 的形式发布,而不是以代码
最有意思的目录是
agents/。九个流水线步骤——剧本解析、角色提取、分镜拆分,以及几个提示词生成环节——被导出了三份:给阿里百炼的九个 zip 加一份 21 KB 的 template.yml、给 Coze 的九个 workflow 归档、给 Dify 的九个.dify.yml。也就是说这套提示词流水线并不锁死在应用里:一个已经在用 Coze 或 Dify 的工作室,可以把同样九步导入过去跑。有用户想要可编辑的系统提示词——好让负责人把剧本分给助手,而不必交出提示词本身——维护者的回答是他正在对接百炼的 agent 接口,正是为了这个目的。 - 06
陌生人做掉了生产化的工作
如果维护者在四月停下了,社区没有。此后到来的 pull request 不是改错别字:有人用 Better Auth 加上邮箱密码账号与 Stripe Checkout 加客户门户的订阅计费、五张新表、四语言定价页、路由保护,以及一个把匿名用户数据迁移到新账号的迁移脚本;有人加上注册、登录与会话级访问控制、认证限流、更严的素材归属校验,以及生产用 Docker Compose 和 GHCR 构建流程;有人按现有供应商协议加了四种 HappyHorse 1.0 模型、覆盖三种 API 格式;还有人重建了任务处理,让十一个处理器里十个具备含取消的完整生命周期,加了一个针对七种转场类型的确定性推荐器,并带来十九个测试。这些一个都没有被合并。
- 07
一个陌生人审出了一个泄漏的密钥
这些未合并的 pull request 里,有一份值得一读的代码审查。2026-07-01,一位审查者过了一遍转场推荐的改动,并用中文指出
scripts/test-ai-sdk-shot-split.mjs第 6 行硬编码了 API Key 回退值。他的论点是:这个值在 diff 里被截断了,但在 git 历史里是完整的;base URL 看起来指向一个真实的代理密钥,而不是占位符;正确的修法是删掉回退、让变量未设置时直接报错,轮换密钥,并且改写历史而不是追加一个删除它的提交。他对整份改动的结论是一条严重问题、四条警告、五条建议,并且把完整审查连同一份中文版一起发在了行内。这个 pull request 现在还开着。 - 08
issue 里说的是什么
追踪器里主要是安装问题与模型行为问题,这对一个自托管流水线来说在意料之中。反复出现的「启动不了、Drizzle 迁移与已存在的 schema 冲突」——README 说用
drizzle-kit push初始化,而一个社区 PR 把这条建议改成了drizzle-kit migrate,因为先 push 会让迁移表为空,下一次启动就会重放每一条语句。角色提取因 JSON 未闭合失败,得到的回复是建议配一个好点的模型。场景帧生成了却不显示,卡住下一步。以及一批「当时还不存在的模型」的请求——Happy Horse、Grok video、GPT Image 2——其中几个后来真的被社区在上面那些未合并的 PR 里实现了。还有一段纯粹是客服负载:飞书群人满了,于是开了二群。