这是什么
一大批 Claude Code 技能,把一次会话变成形似一个工程组织的东西:一位会重新审视产品的 CEO、一位把架构钉死的工程经理、一位清除「AI 味」的设计师、一位专门找生产环境 bug 的评审、一位会真的驱动浏览器的 QA 负责人、一位跑 OWASP 与 STRIDE 审计的安全官,以及一位负责把 PR 发出去的发布工程师。二十三个专家角色加八个强力工具,全是斜杠命令、全是 Markdown,安装方式是往 Claude Code 里粘一段指令。仓库里还带着它背后的那套机器——一套会报出每次运行花了多少钱的评测装置、一条每周基准通道,以及一个被裁掉了二百二十七个文件的测试套件。
谁做的411 次提交里 370 次出自他。README 把他介绍为 Y Combinator 的总裁兼 CEO,并描述了他之前的一段经历——在 Palantir 最早的工程师与设计师之一、Posterous 的联合创始人、以及 YC 内部社交网络 Bookface 的建造者。本记录里的生产力数字是他本人给出的,并且附了方法论文档与复现脚本,而不是一句断言。
制作过程
8 个阶段- 01
生产力主张是带着方法论来的
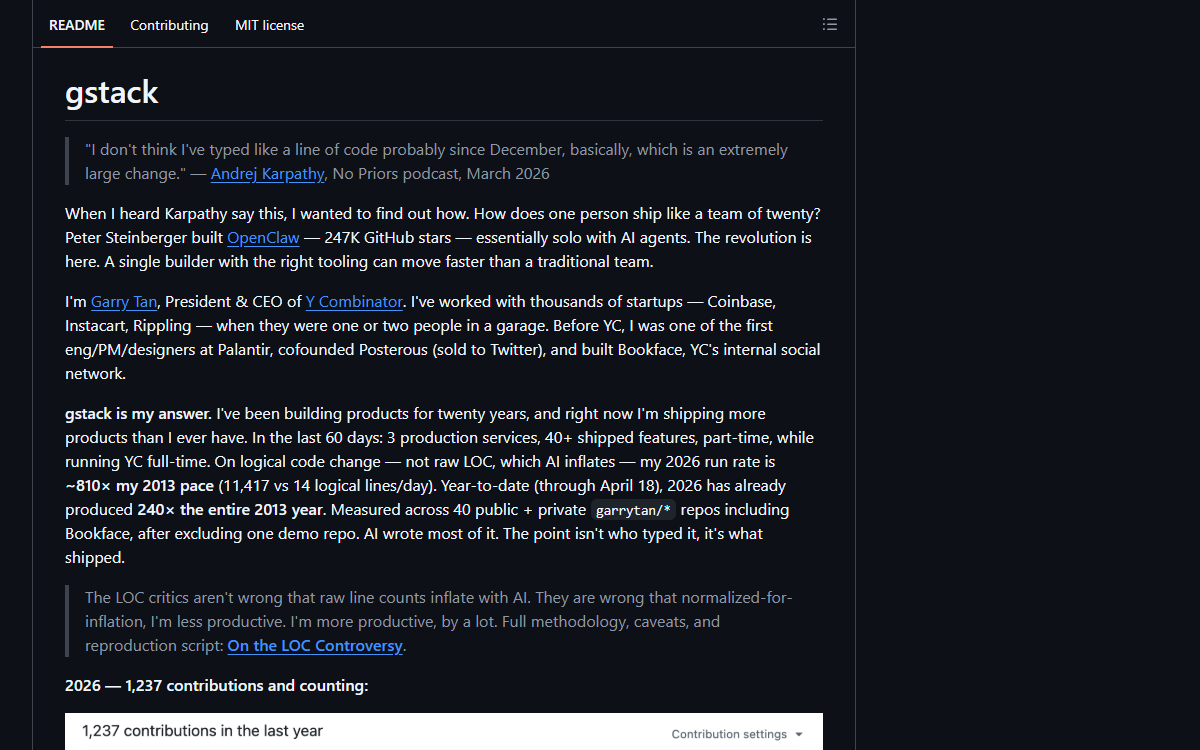
README 开篇讲的不是这个工具做什么,而是 Andrej Karpathy 的一句引用——他说他大概从十二月起就没敲过一行代码——以及作者想回答这个问题的尝试。他报告了六十天里三个生产服务、四十多个已上线功能,还是在全职经营 Y Combinator 的同时兼职做的;然后他做了更难的那件事:把指标写清楚。不是原始行数——他同意 AI 会把它吹大——而是逻辑代码变更量,据此他报告 2026 年的速率约为他自己 2013 年的 810 倍,每天 11,417 行逻辑代码对 14 行;统计范围是他名下 40 个公开与私有仓库(含 Bookface),排除了一个演示仓库。主张链接着一份给出方法、注意事项与复现脚本的文档,而 README 在回应之前先承认了批评者真正说到点子上的那部分:他们说原始行数会膨胀是对的,说归一化之后他产出更少则是错的。旁边放着两张截图:2026 年的贡献图,以及 2013 年他做 Bookface 时的贡献图,配文是——同一个人,不同的时代,差别在工具。
- 02
二十三个专家,写成 Markdown
这套工具定义的是角色而不是功能。一位重新审视产品的 CEO、一位把架构钉死的工程经理、一位清除 README 所谓「AI 味」的设计师、一位评审、一位会驱动真实浏览器的 QA 负责人、一位跑 OWASP 与 STRIDE 审计的安全官、一位发布工程师。二十三个这样的角色加八个强力工具,每一个都是用 Markdown 写的斜杠命令,MIT 许可。安装说明里点了大约三十七个命令的名字,其中有一句值得单独拎出来:它让 Claude Code 所有网页浏览都走 gstack 自己的浏览技能,永远不要用内置的浏览器集成。这是一个工具包在就「浏览器归谁」表态——而这件事重要,是因为它的浏览与 QA 技能明确是设计来驱动用户已经登录的那些会话的。
- 03
88% 的提交写明了共同作者,而且不只有一家厂商
411 次提交里有 361 次带共同作者尾注——88%,落在本档案这一路记下来的区间里;而考虑到这个仓库的体量,惊人的是条数而不是比例。分布才是一个开发者工具链有意思的地方:Claude Opus 4.6 一百零五次、百万上下文的 Opus 4.6 八十五次、百万上下文的 Opus 4.7 六十次、Fable 5 三十次、百万上下文的 Opus 4.8 二十一次、普通 Opus 4.7 十八次、Sonnet 4.6 与 Haiku 4.5 各一次;旁边还有 Cursor 六次、OpenAI 的 Codex 五次、以及一次 Hermes Agent。人类共同作者也一路留名。于是一个人的提交历史记录下了一套在不同厂商之间移动、而不是定居于某一家的工作方法,而且移动得足以让比例被数出来。
- 04
bug 报告会给出文件与行号
十三万四千星、九百四十个未关闭 issue,追踪器本来很容易变成噪音。而其中要紧的那些读起来像一份内部工程日志。有一条报告说某个近期版本把部署技能改成只以「被标记为必需」的那个检查来把守 CI;在一个没有声明任何必需检查的仓库上,工具把「没有必需检查」读成了「没什么可等的」,于是跳过等待,可以越过红色或仍在运行的 CI 直接合并。报告给出了改动前后的两条命令、文件与行号、引入这次收窄的提交,以及一句观察:变更日志里根本没提这次收窄。另一条是关于一个固定的快照上限挡住了全仓库审计的容量报告,它开篇就声明这不是在声称安全漏洞、也不是在请求绕过任何东西,然后钉住版本、提交与失败运行的日期。精确、有边界,并且明确说出自己没有在声称什么。
- 05
测试套件被裁掉了二百二十七个文件
最近有一条 pull request 借用另一个项目的测试审计方法,删掉了那些不保护任何用户可见之物的测试。发现很具体:大约每十个免费测试文件里有四个根本不碰产品代码,因为它们只是把录下来的对话回放给评测打分器,而其中几个打分器已经没有调用方了。前后对照表就在 PR 里:受跟踪的测试文件从 1,184 降到 957,测试的 TypeScript 行数从 274,208 降到 227,713,helper 行数从 51,390 降到 39,427,fixtures 从 16 MB 降到 9 MB。而授权这次删除的计划,本身是走这套工具自己的规划命令跑出来的——先 CEO 评审、再开发者体验评审、设计评审跳过——维护者原样批准。一个用自己那套评审流程删掉自己测试的工具,做的事比不断堆功能有意思。
- 06
CI 会报出这次运行花了多少钱
在一个已合并的 pull request 上,自动评测评论报告:123 项自动通过对 123 项最终结果、零失败、107 个用例实际执行、16 个复用缓存、3 个用例需要多次尝试,还给出 profile 与 judge 数量、106 个行为被推迟到定时覆盖(并明确注明推迟的检查不获得任何通过信用)——以及单独一行:本次总成本 68.32 美元。按 pull request 给评测运行标价是罕见的,而它改变了「一个测试值多少」这件事的性质:一份你能看见账单的套件,就是一份有人能决定去缩减的套件——而紧接着的测试审计正是这么做的。同一个仓库还跑着一条每周自动基准通道,并在红灯车道需要分诊时自动开 issue——写本记录时它正是红的。
- 07
安装器就是一段你粘给 agent 的话
这里没有通常意义上的安装脚本。README 让你打开 Claude Code,粘一段指令:把这个仓库浅克隆进 skills 目录、跑 setup、再往你的项目指令里加一节列出全部可用命令并把所有浏览重定向到 gstack。agent 把工具包安装进它自己。这是一种与包管理器真正不同的分发模型,而它把自己的前提条件也说得干脆——某个 JavaScript 运行时的版本、Git,以及安全审计命令所需要的、带四个编译标志的特定运行时构建加一套原生工具链。README 还说明了缺这些东西时会怎样:setup 会把其余的都装好、清掉过期的助手,而安全命令会报出它没有运行、以及为什么。大声地拒绝是正确行为,而且并不常见。
- 08
九百四十个未关闭 issue,零个 release
版本号已经到 1.91.8,而仓库里没有一个 release、也没有一个 tag:版本在提交信息里推进,所以没有任何已发布的产物能让版本号指过去。十二个人贡献过,其中一个人写了 411 次提交里的 370 次。九百四十个 issue 对着两万个 fork 敞着——这是一个得到远超其处理能力的关注度的项目的算术。而对整个仓库的一个公道描述是:它的大部分机器都朝内——评测装置、测试审计、CI 闸门与那些评审命令,主要瞄准的都是开发 gstack 本身。读者无法从中得知的是:那些安装了它的项目会怎样——这恰恰是本档案最想回答的问题,也正是星标数替任何人都回答不了的那一个。
相关档案
全部档案 →第 035 号
Nexus Agents
一个不自己做活的 agent 层:任务只从一个入口进来,真正有分叉的决定交给多角色投票,每一次工具调用都写进一条哈希链式的审计日志,而改动「管规则的那部分代码」必须由仓库所有者本人批准。
第 061 号
DeepSeek Harness
DeepSeek 的 agent 运行框架:模型适配器、工具注册表、会话日志、乃至 agent loop 本身,全都是插件——换掉它们靠的是改配置文件,而不是分叉源码。
第 060 号
VibeGame
用一句话描述一个游戏,一队 agent 就分头开工——架构师做计划、程序员实现、审计员拿代码对计划、而必须有一个「玩家」真的把它玩过,任务才算验收。