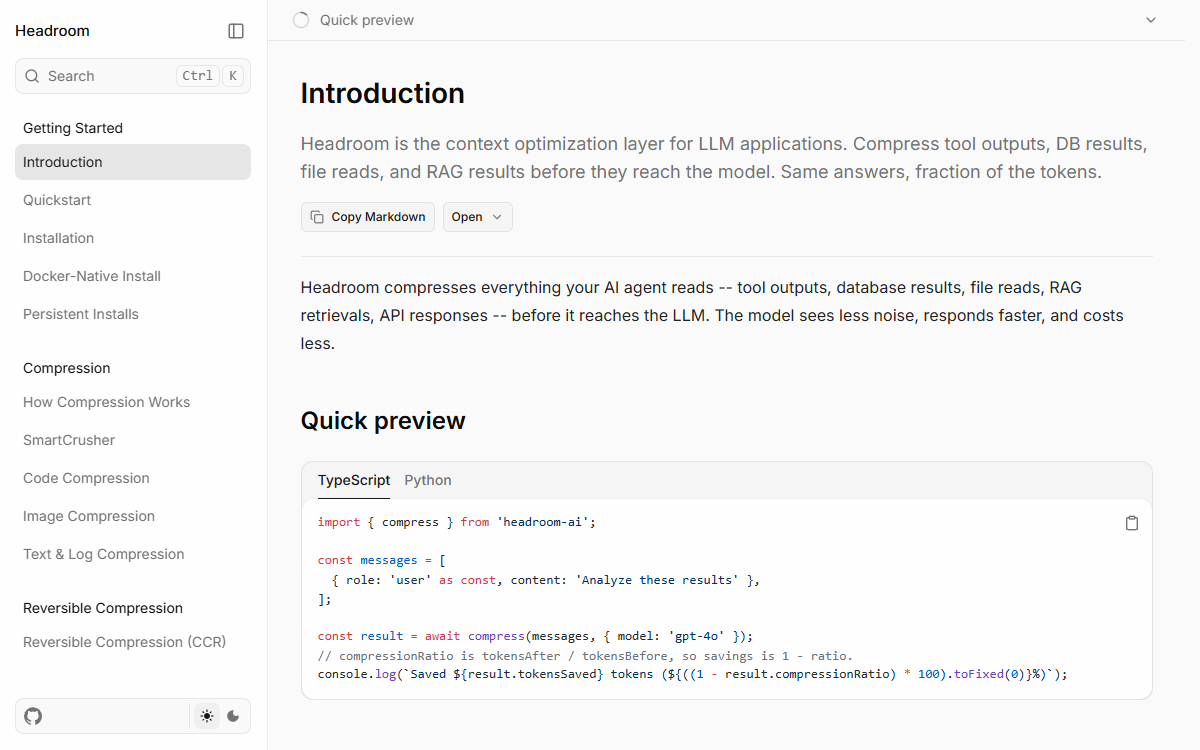
这是什么
Headroom 是给 agent 发给模型的那部分流量做压缩的一层。它有三种形态——库,整个 API 就是 Python 或 TypeScript 里的一个 compress() 调用;FastAPI 代理,任何 OpenAI 兼容的客户端把地址指过来就行;以及一个 MCP server,对外提供 headroom_compress、headroom_retrieve 与 headroom_stats——再加一条包装命令,负责起代理并替十五种具名的编码 agent 配好。里面是一个 ContentRouter 判断每一块内容是什么,再把它交给唯一一个压缩器:数组型 JSON 记录交给 SmartCrusher,另有搜索压缩器、日志压缩器、diff 压缩器、HTML 抽取器、表格与配置压缩器、文本压缩器,以及一个按需开启、基于 ModernBERT、名叫 Kompress 的模型专门处理散文。最重的那几个跑在通过 PyO3 装载的 Rust 扩展里,Kompress 走 ONNX Runtime。只有最新的内容块会被压缩,更早的轮次逐字节原样转发,好让服务商的前缀缓存活下来;而每一次压缩都可逆——原文会写进本地存储,模型可以取回。
谁做的仓库属于 headroomlabs-ai——一个组织账号而不是个人账号:提交邮箱用的是 headroomlabs.ai 域名,README 除了开源内核之外还在卖带支持或全托管的部署。单一提交最多的是 chopratejas(Tejas Chopra),在抽样到的 3,000 次提交里占 1,234 次;其次是 JerrettDavis 的 373 次、abhay-codes07 的 169 次、gglucass 的 139 次与 rodboev 的 102 次,dependabot 另有 76 次。贡献者名单列了五十个账号,3,000 次提交里有 2,984 次关联到了 GitHub 账号。
它是怎么搭起来的
组成 · 6一层放在 agent 和它所对话的对象之间的压缩。库、两个 SDK 和代理共用同一条请求生命周期,里面跑一条很短的顺序流水线:按需开启的工具结果拦截器、一个只做前缀漂移检测的环节,然后是真正改写内容的 ContentRouter。其余的一切都从三个后果里长出来。第一,压缩不许打扰服务商的缓存,所以只压最新的内容块,更早的轮次逐字节原样转发——默认模式叫 cache 就是这个原因。第二,压缩必须可逆,所以原文进本地按哈希索引的存储,模型拿到一个取回工具。第三,压错比不压更糟,所以每个 transform 都 fail open,护栏按节省档位可配,而最重的几个压缩器被搬进 Rust 扩展,Python 里留着参照实现,靠录制下来的夹具去比对。
- headroom/
- Python 包,33 个顶层文件加约三十个子包,共 472 KB。
transforms/装压缩本身——39 个文件,领头的是 370 KB 的content_router.py,另有 112 KB 的代码压缩器、99 KB 的 Kompress 封装和 64 KB 的 SmartCrusher。proxy/是 FastAPI 应用背后的 123 个文件,含 564 KB 的handlers/openai.py、311 KB 的handlers/anthropic.py、191 KB 的helpers.py与 97 KB 的流式 handler。cache/管前缀稳定与缓存 TTL,ccr/是 Compress-Cache-Retrieve 存储和它的 MCP server,providers/一种被包装的 agent 一片,cli/是各个命令——其中一个wrap.py有 359 KB——此外还有evals/、memory/、image/、pricing/、telemetry/、tokenizers/、integrations/、learn/与install/。 - crates/
- 五个 Rust crate。
headroom-core装 Rust 实现——SmartCrusher、日志/搜索/diff/代码压缩器、live-zone 分派器、内容检测、分词器注册表与 CCR 后端。headroom-proxy是 Rust 代理,带原生 Bedrock SigV4 与 Vertex 路由、一个 SSE 状态机和一个缓存稳定化模块。headroom-py是以headroom._core暴露给 Python 的 PyO3 扩展,而headroom-parity与headroom-simulators的存在是为了比对和伪造两侧。 - tests/ 与 tests/parity/
- 666 个文件。
tests/parity/下的 231 个是录制下来的夹具——cache aligner、CCR、代码感知压缩、内容检测、diff、Kompress、日志压缩、SmartCrusher、文本压缩、分词器,以及 Codex 与 OpenAI 的契约——由名字以record_开头的脚本重新生成。另有tests/fixtures/fidelity_golden/放着一个生成器、一份基线和 16 KB 的用例,tests/gateway/用假服务商和假网关跑契约与不变量测试。 - benchmarks/ 与 headroom/evals/
- 度量面:31 个脚本、626 KB,包括那个 proof 表生成器和它入库的结果文件、46 KB 的延迟基准、最坏情况与对抗性基准、一个 i18n 压缩评测、一个文本质量评测、缓存击穿与前缀缓存追踪,以及 Claude 会话对比;外加一个 26 文件的 eval 套件,含数据集、对抗网格、记忆评测与报告卡。
- docs/、wiki/ 与 REALIGNMENT/
- 不是一层文档,而是三层。
docs/content/docs/有 54 个 MDX 页面,领头的是 70 KB 的代理页、35 KB 的配置页、一份 API 参考和一份 limitations;wiki/有 35 个页面外加三份带日期的方案文档;REALIGNMENT/则是那份十四篇的内部审计,从 26 KB 的 bug 清单一路到按阶段拆分的方案和一个索引。 - .github/workflows/、scripts/ 与 sbom/
- 发布与评审机器:23 个 workflow,其中
release.yml有 50 KB、ci.yml有 28 KB,另有docker.yml、rust.yml、eval.yml、security.yml和一个 PR 健康检查;脚本负责生成 changelog、同步版本、管 pull request 治理、跑发布冒烟测试、校验 ruff 与工具哈希,以及录制那批 parity 夹具;另有一个入库的 SBOM 目录,8.5 MB,装着 CycloneDX 与 SPDX 清单和漏洞扫描结果。
取舍,以及它替代了什么
只压 live zone,绝不丢历史 替代 给整段对话打分,删掉旧轮次来塞进窗口
那一整套 realignment 文档把「丢掉」这个模型直接称作错的思维模型,并把五个缓存杀手 bug 追到它头上;它开出的方子是删掉 context manager、打分、相关性和滚动窗口那几级,只压最新的内容块。架构文档记下了结果:那一级被移除、流水线里不再有任何丢弃或打分逻辑、那些类也从 Python 包里消失了——而 TypeScript SDK 仍然导出对应的字段名。
把 CacheAligner 做成永不改写提示词的检测器 替代 把易变内容抽出来挪到消息末尾
更早那份架构文档把「挪走」的版本写得很细,连一个带日期的系统提示词改前改后都有。现在的文档说这一级从不修改、移动或改写内容,默认关闭,并且在代理里被硬关掉,存在的意义是发布前缀稳定性指标。行为留了下来,改写被拿走了——这是这次改动里更有意思的一半。
默认用 cache 模式 替代 用把原始 token 删得最狠的 token 模式
两种模式在文档里是并排写的:cache 只压一轮里最新的增量、把更早的轮次逐字节原样转发,于是多轮对话中途服务商的前缀缓存不会被作废;token 模式可能重新压更早的轮次,拿缓存稳定性去换节省。默认值来自项目自己的一个观察:在多轮负载上,大部分成本节省就住在前缀缓存里。
默认开启可逆压缩,并给出退出口 替代 一条没有取回路径的有损流水线
CCR 把任何被压过的东西的原文写进本地按哈希索引的存储,并注入一个取回工具让模型能要回来,而且默认开着;标记与工具可以用
--no-ccr关掉,另有一个不带标记、格式原生的无损模式藏在--lossless后面。默认落在有损那一侧,而出口就写在它旁边,不是埋起来的。把输出 token 的节省报成一个估计值 替代 给出一个看上去像实测的单一数字
README 说明了原因:模型本来会写什么从来没被观察到,所以这个数字是反事实的,于是它带着置信区间打印出来,并标上 estimated。想要实测数字的话,另有把一成对话留作对照组的办法,文档写明设置之后仪表盘上那张卡会从 estimated 变成 measured。
依据docs/content/docs/architecture.mdx(8,593 字符)、wiki/ARCHITECTURE.md(37,720 字符)、REALIGNMENT/00-overview.md、plugins/headroom-oauth2/SPEC.md、README.md(约 33 KB)、完整的 2,489 个文件树及其体积、含 231 个 parity 夹具与保真度金样本的 666 个测试文件,以及 31 个基准脚本。
制作过程
6 个阶段- 01
一个九个月大的仓库和 74,192 个星,而材料里没有任何东西解释它
仓库建于 2026-01-07,样本里最新一次提交是 2026-10-01;中间的样本收录了 3,000 次提交,而 pull request 的编号已经过了 #3896。2026-10-01 的 GitHub API 报告:74,192 个星、5,734 个 fork、219 个 watcher、529 个未关闭 issue、85 MB 仓库体积、Apache-2.0 许可。材料里没有任何东西解释这个数字是怎么来的。它能显示的是围着它的那一整套机器:一个文档站、一个 Discord、一个 PyPI 包、一个只发 TypeScript SDK 的 npm 包、一个发在 HuggingFace 上的模型、一个 Docker 镜像、一个挂着 Trendshift「#1 Repository Of The Day」徽章的 README、一份 533 KB 的 changelog,以及一段把两个节省百分比放在最前面、而不是先讲这工具干什么的简介。唯一跟星数摆在一起显得反常的计数是 watcher:219 个,对着 5,734 个 fork。
- 02
一个路由、每种内容一个压缩器,以及一批没有交代方法的节省数字
三个入口喂同一条流水线:Python 与 TypeScript 的
compress();一个 FastAPI 代理,按服务商分开的 handler 各自跑同一条流水线再转发;以及给 LangChain、Vercel AI SDK、Agno、Strands、LiteLLM 和 MCP 用的适配层。每个请求都跑一条很短的顺序流水线——一个按需开启的工具结果拦截器,一个只报告前缀漂移的 CacheAligner,然后是干了几乎全部活儿的 ContentRouter。它判断每一块的类型,分派给唯一一个压缩器,而项目自己的架构文档在每个压缩器旁边都印了一个「typical savings」:数组型 JSON 用 SmartCrusher 是 70–90%,搜索结果 80–95%,构建与测试日志 85–95%,diff 40–80%,HTML 70–90%,表格 60–90%,结构化配置 40–70%,纯文本 30–60%。这些数字是项目自述的;文档把它们标为「typical」而不是实测,并且没有给出任何语料、运行过程或方法。所有 transform 都 fail open:出错时内容原样返回,请求照样发出去。 - 03
Proof 那张表交代了方法,Accuracy 那张表带着作者自己写下的保留意见
README 里有一节 Proof,由四个场景组成,而且跟上面那张表不同,它说明了数字怎么来的:真实的 MCP server 输出格式、服务商的分词器、仓库自带的
compress(),固定随机种子并离线,命令是uv run python benchmarks/index_proof_table.py --seed 20260902。代码搜索 17,199 → 13,597 token(21%),SRE 事故排查 55,957 → 24,340(57%),代码库探索 58,801 → 33,895(42%),GitHub issue 分诊 46,067 → 32,429(30%)——每一个数字都是项目自述的。同一节还说:节省幅度跟着重复度走,重复的 JSON 数组和日志行在benchmarks/bench_latency.py里能过 90%,散文和本来就很密的内容几乎压不动,而在一个 10K token 的 JSON 搜索结果上压缩耗时的中位数是 0.21 ms。精度数字来自python -m headroom.evals suite --tier 1,每个基准 N=100,然后这一节开始反驳自己那张表:「At N=100 a delta of ±0.03 falls inside the confidence interval, so TruthfulQA shows no detectable difference rather than an improvement.」 - 04
issue 区里记下来的保真度问题
这套压缩有写在案上的失败,最清楚的一条是 #3880,标题是「Severity: silent data loss」:Kompress 会把单行 JSON 工具输出里的整条记录删掉,留下的仍是合法 JSON,「so no parser, log line or model can tell」。报告者描述了自己部署里的后果——一个 agent 反复且笃定地告诉用户某个数据集合不存在,而它存在——并点名当时唯一的缓解办法
HEADROOM_DISABLE_KOMPRESS=1,而那会把散文压缩也一起关掉。修法是凡是带记录结构的 JSON 都不再进那个散文模型,所有能走到它的路径都堵上;顺带把一段反复走同一批字节的扫描器换成一次线性遍历:在一个 58.8 KB、括号密集的块上,3.43 秒变成 0.011 秒,并用 4,000 个随机字符串跟旧实现逐一对过。另两条较小的报告是同一个主题:#3881 发现有一处代码拿词数去和 token 数比,于是一个原样未动的代码块看起来像省了 55%;#3893 发现外部压缩器返回的 passthrough 被当成了结果采纳,那一块于是未经压缩就发了出去。 - 05
作者自己的审计:错的思维模型,以及大约两万五千行要删掉
一个叫
REALIGNMENT的目录装了十四份文档、193 KB 的项目自我诊断,而执行摘要开门第一句就是指控:Headroom「is built on the wrong mental model」,也就是把压缩理解成「从对话历史里挑东西丢掉」。IntelligentContextManager 会把整个 messages 数组分词、给每条消息打分、一路删旧消息直到预算够用,而它被接进 Rust 代理时frozen_message_count: 0是硬编码的,「so every compression event drops messages from index 0, busting the Anthropic prompt cache for every customer that triggers it」。审计列出这个模型带来的五个顶级缓存杀手 bug、约一万行架构上的过度建设、被它称为虚假的 Bedrock 与 Vertex 对齐、算出来却从没注入到发出请求里的 CCR 标记,以及上游会看到的X-Headroom-*请求头泄漏。方案分九个阶段、四十个 pull request、大约十三周。同一批材料也记下了结果:context manager 那一级被删掉,打分相关的类从 Python 包里消失了,而 TypeScript SDK 仍然导出那些字段名——「wired to nothing」。 - 06
发版节奏、那套评审机器,以及靠录制夹具对齐的两种语言
样本里的二十个 release 从 2026-06-16 的 v0.26.0 到 2026-09-26 的 v0.39.1,八月那一周就能看出节奏:20 日 0.36.0,21 日 0.36.1、0.36.2、0.36.3,22 日 0.36.4、0.36.5。按月提交数是 135、68、165、676、334、433、581、324、276、8。旁边是一整套评审机器:二十三个 workflow 文件,包括 28 KB 的
ci.yml、50 KB 的release.yml,以及eval.yml、rust.yml、security.yml和一个pr-health.yml,另有生成 changelog、同步版本、管 pull request 治理的脚本。机器人会在必填小节留空的 pull request 下面留言提醒;维护者会对着一个精确的 head commit 做评审,报出本地跑过多少个针对性测试,旁边是 ruff、mypy 与 diff 检查,并说明他已经授权了那些需要维护者放行的托管 workflow。两种语言靠录制下来的夹具保持一致——tests/parity/下 231 个文件,覆盖 cache aligner、CCR、代码感知压缩、内容检测、diff、Kompress、日志压缩、SmartCrusher、文本压缩、分词器以及 Codex 与 OpenAI 的契约——而共同作者尾注本身也是一段记录:1,168 条里约 466 条写的是一个 Claude 模型名,129 条写 Copilot。
相关档案
全部档案 →第 095 号
HarnessRouter
HarnessRouter 的自托管、Apache-2.0 版本:把十六种现成的 agent CLI——Codex、Claude Code、Hermes、DeepSeek Harness 以及另外十二种——放到同一个兼容 OpenAI Responses 的 API 后面,会话、流式进度、文件、取消与结构化失败都在里面;它实现的那套 Unified Harness Protocol,以及用来度量它的 conformance 套件,也一并放在这个仓库里。
第 078 号
OpenChatCut
一个本地优先的视频剪辑器,剪辑方式是跟它说话:内置 agent 与外部 Codex、Claude Code 会话调用的是界面自己在用的同一套剪辑工具,于是每一处改动都落在一条真实的多轨时间线上——是片段、转场、字幕、特效或音频,仍然能拖、能撤销、能导出。工程与素材留在本机,预览与最终渲染都出自 Remotion。
第 070 号
delegate-skills
一个技能包,给每一种编码 agent CLI 各配一份委派技能:编排方写好自足的任务书,另一条 CLI 去改真实工作树,而审查与提交留给人。