这是什么
一个把文档变成可推演世界的模拟引擎。上传种子材料——一份新闻综述、一份政策草案、一部小说的前八十回——它把实体和实体间的关系抽成图谱,为每个实体生成人设,然后让几百个智能体在两个模拟社交平台上互相发帖、回复。拿回来的是预测报告加上那个世界本身,之后还可以继续向它提问。智能体带着长期记忆,整套东西跑在你自己的机器上,用你指定的模型。
谁做的学生,主页把中科大(USTC)和北邮(BUPT)列为所在机构,地点写上海。他九个公开仓库里有两个星数都在四万以上,都是中文项目,主题也都是同一件事:读取舆情并向前推演。媒体报道称盛大集团创始人陈天桥邀请他加入盛大,随后盛大向这个项目投资三千万元人民币——而仓库 README 里就挂着盛大的 logo。
制作过程
8 个阶段- 01
它做什么,以及这里的「模拟」指什么
流水线分五步。种子材料先变成一份时序知识图谱,实体与实体间的关系被抽出来,并且记录下事情发生的时间。接着每个实体生成人设——背景、记忆、行为模式、社会位置。这些人设成为两个社交平台模拟里的智能体,一个仿 X,一个仿 Reddit,模拟跑可配置的轮数,智能体之间发帖、回复、引用。之后一个 report agent 在跑完的世界里工作,产出预测报告;同一个环境保持开放,可以继续提问:可以问任何智能体它做了什么、为什么,也可以问 report agent 关于整场推演的问题。有两个细节的作用比表面上大。每个智能体通过 Zep 挂着长期记忆,所以它在第四轮看到的东西会影响它第二十轮说的话。而模拟的种子是你给的那份文档,这正是同一个引擎既能处理一所大学的舆情、也能处理一部十八世纪小说失传结局的原因。
- 02
那次小说推演,具体数字
这个项目最出名的那次演示,拿《红楼梦》前八十回——约十五万字——去问失传的结局会是什么。图谱阶段产出 905 个实体、3822 条关系;人设阶段产出了其中 580 个,也就是 580 个智能体,每个都有一份写好的小传,至少有一个还带 MBTI。三十轮双平台模拟产生了接近两千个活动。report agent 的结论被媒体引用过,读起来比大多数机器写的文字好:大观园的崩溃并非偶然的悲剧,而是礼法结构与个体命运共振瓦解的必然过程。它推演出的部分结局与现存版本吻合——黛玉焚稿、湘莲出家——也有不吻合的:通行的续本让宝玉去参加科举,而这次模拟让他在连番打击下精神崩溃,随疯道人而去。作者还公布了这场推演的花费:大约十四块钱人民币。他自陈的局限也值得记下——输入文本量过大时,输出会出现中英文混杂。
- 03
十天,以及提交历史显示的东西
关于这个项目的报道都从一个数字开场:十天 Vibe Coding 做出来的。仓库自己的历史给出一个略有不同的形状,但并没有否定关于「构建」的那个说法。第一次提交在 2025 年 11 月 26 日,仓库从那天起就是公开的。此后九个月里,320 次提交分布在 64 个活跃日上,跨度 281 个自然日。其中 21 次落在最初十个自然日之内;第十个有提交的日子是 2025 年 12 月 11 日;而第一个打了 tag 的版本 v0.1.0 落在 12 月 22 日,距第一次提交 26 天。十天这个数字描述的是建造花了多久,不是仓库存在了多久,两个数字并不冲突——但只有一个在报道里,另一个在提交日志里。
- 04
star 曲线,出自仓库自己的数据
这个仓库带了一套追踪自身 star 数并提交图表的子系统,也就是说这条增长曲线是公开的而不是估算的。起点是 2025 年 11 月 28 日的 1 颗星。12 月 22 日,也就是 v0.1.0 打 tag 那天,是 40 颗。第二天是 270 颗——二十四小时内涨了将近七倍。到元旦是 683 颗,一月底 3234 颗,二月底 4042 颗。然后是三月:3 月 9 日 10,278 颗,到月底 46,118 颗,三十一天里涨了十一倍。之后曲线落回一种更平常的形态——四月 57,873、五月 63,036、六月 67,430、七月中 68,993、九月初 71,809。API 现在报 75,157。这个形状说明的是:项目公开后有一个月几乎无人问津,正式发布当天起飞,五个月后又经历了极不寻常的一个月。
- 05
那笔投资,和 README 里的 logo
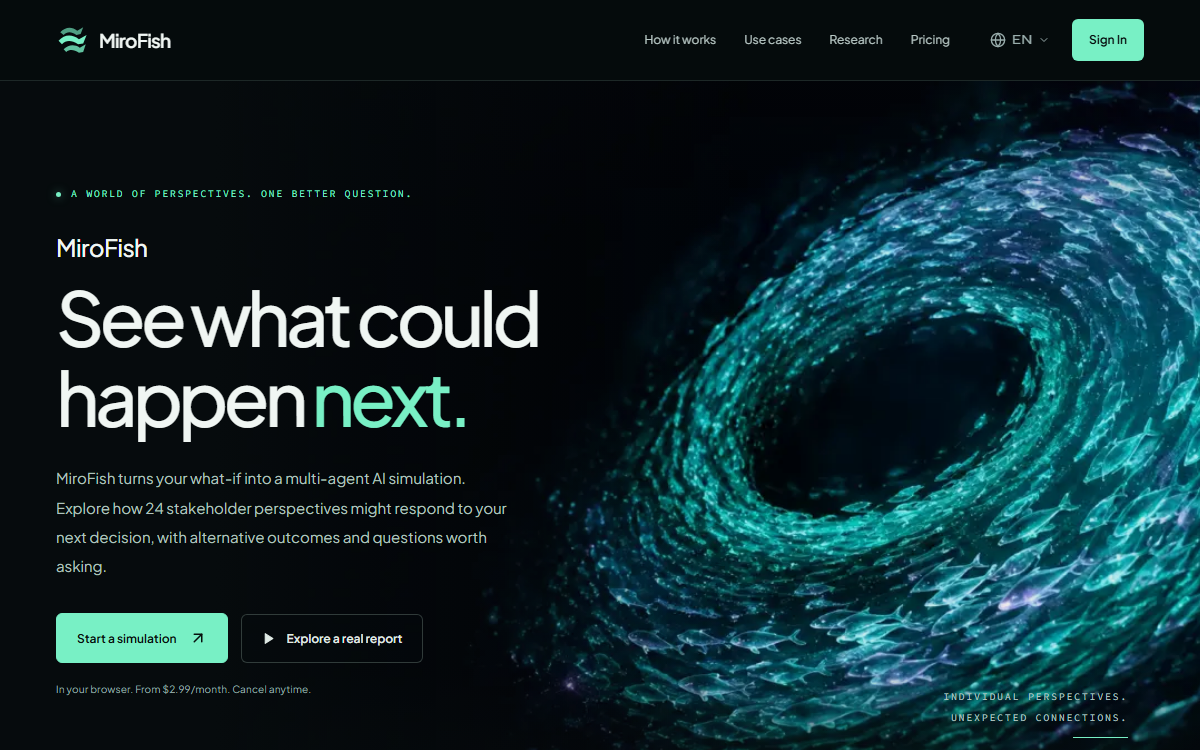
README 在标题旁边挂着盛大集团的 logo——对一个开源项目来说这不常见,而报道解释了原因。盛大创始人陈天桥在他前一个项目走红后邀请他加入公司,而他在盛大用十天时间做出了那个从前作起就想做的「预测」功能。中文媒体的说法是:演示视频提交后二十四小时内就拍板了投资——三千万元人民币,约合四百万美元,用来在集团内部把这个项目继续做深。仓库里另有一枚 Trendshift 徽章(登顶 GitHub trending),一个 Discord 服务器,以及 X 和 Instagram 账号。这是一个背后有市场运作的开源项目,README 也没有假装不是。两部分之间的分工值得直接说清,因为很容易看漏:仓库是 AGPL-3.0、自托管;而 mirofish.us 这个站点在以订阅方式售卖托管版——首屏写的是「in your browser, from $2.99/month」,导航里还有用例、研究与定价页。同一个项目,两种用法,两个完全不同的价格。
- 06
前作,以及这个想法从哪来
同一位作者的前一个项目 BettaFish 有 42,308 颗星、7,615 个 fork,许可是 GPL-2.0 而不是本项目的 AGPL-3.0。它做舆情分析:给一个话题,它去各社交平台搜索,让一个 agent 团队对找到的东西做总结和交锋,然后返回一份报告。按作者的说法,它原本只是他的毕业设计;媒体报道称它公开后一周涨了两万颗星。仓库自己的 star 数据补上了细节,也纠正了这个说法最容易被读成的意思:项目自 2024 年 7 月起就是公开的,直到 2025 年 8 月还只有 272 颗星,随后在 2025 年 11 月 1 日到 8 日这七天里涨了约一万九千颗——正好是 v1.1.0 与 v1.2.0 发布的那一周。一周是真的;真正点燃它的是仓库开了十六个月之后的一次发版。MiroFish 是同一方向上再往前一步,而两者在最要紧的地方是连着的:这个项目的两个演示视频之一,其种子文档正是一份 BettaFish 生成的舆情报告。分析喂给模拟,这就是两份 README 都在描述的闭环。两个仓库都是从头写的、不建立在任何 agent 框架之上——这句话在作者的项目描述里反复出现——也都是中文优先、英文并列。
- 07
他自称是怎么做的
关于这个项目最有用的来源不是仓库,而是作者自己对过程的叙述,中文报道里引了很长。他的时间主要花在市场调研和技术选型上,而不是写代码:先弄明白为什么做、做给谁、怎么做,然后再去指挥模型。他描述的流程是:Figma 画草图并用模型反复打磨,在 Google AI Studio 做前端 demo,把页面补进项目文档,再把任务拆成模块分批交给 AI IDE。他按角色用了两个模型——前端用 Gemini 3 Pro,他说它更有「灵气」,擅长页面结构、美化与交互细节;后端的工程结构、接口设计与稳定性交给 Claude。而且他会让多个 agent 并行做同一个任务再挑最优,经常是八个一起做一个模块。他很直接地说这样 token 消耗巨大,也同样直接地说了为什么还这么做:这是摸清每个模型能力边界最快的方式。
- 08
一个四万星的项目会招来什么
320 次提交,16 位贡献者,148 个未关闭 issue。贡献者名单值得一读,因为外部提交的内容本身就说明问题。有一位贡献者的系列 PR 读起来像一份生产就绪审计:在构造文件系统路径之前校验标识符(描述里指出其中两条路径通向 `shutil.rmtree`,所以一个精心构造的标识符打到删除端点就能递归删掉任意目录);API 密钥认证——项目此前完全没有认证,包括删除类操作在内所有端点匿名可达;资源级归属校验——即便认证加上之后也仍然缺失;给两个用 `open(..., "w")` 直接写的 JSON 文件加上原子写入和状态机,因为它们被 kill 时可能留下截断的文件;给纯内存的任务管理器加崩溃恢复;以及一份可复现性清单,记录某次结果是由哪个模型、哪些文档、哪份本体产生的。日常的 issue 列表则更琐碎、也更说明问题:部署的站点把自己的 HTML 源码当纯文本显示了出来,locale 文件里登记了五种语言却没有任何翻译文件,而一份西班牙语翻译已经被三个人提交了三次。这个量级的项目会产生大量与它的想法本身无关的工作。
他会告诉你什么
- 时间主要花在市场调研和技术选型上,而不是写代码。先弄明白为什么做、做给谁、怎么做,然后再去指挥模型,而不是反过来。
- 让多个 agent 并行做同一个任务,再挑最好的那个推进。他说经常八个一起做一个模块。token 消耗是真的,速度提升也是真的,而且这是摸清每个模型能力边界最快的方式。
- 速度越快,越需要做好刹车系统。版本管理和写好的文档,是防止改了一处影响另一处的东西。
- 一行行读生成的代码,并且跟着执行过程看,而不只是看 diff。他的说法是:大多数 bug 不是某一行写错了,而是模型在某个关键假设上走偏了;把那个假设纠正过来,一批症状会一起消失。
- 不要追求大而全。做减法,不断重新验证自己的定位,也不要等到完美才拿给人看。
- 营销可以不多,但「能让别人帮你宣传」的素材必须提前准备好——首要是足够清晰、别人可以直接转发的演示视频。
- 代码是冷的,故事是热的。会讲代码背后的故事,是独立开发者的必修课。