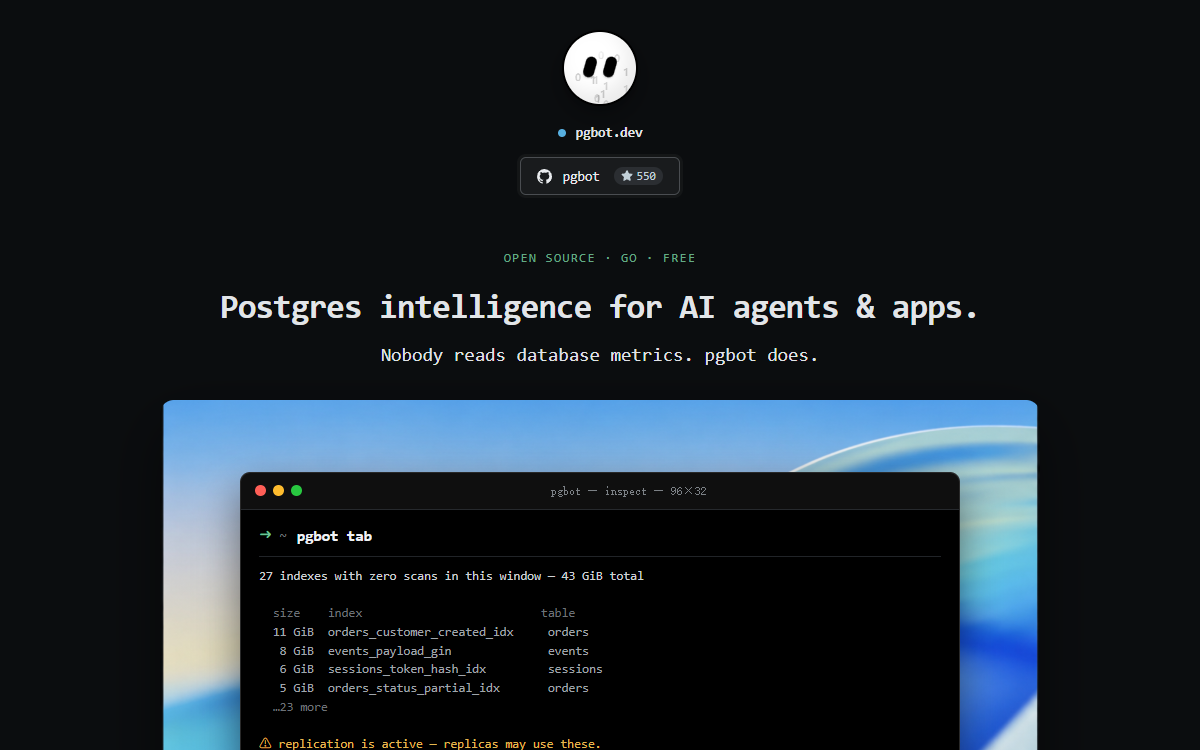
这是什么
一条只读的 Postgres 诊断工具,交付形态是一个静态 Go 二进制。它用一个持有 pg_monitor 的角色连上去,读服务器自己的统计视图——pg_stat_activity、pg_stat_statements、pg_stat_database,以及 WAL、IO、检查点、复制槽、锁、表与索引体积——然后打出一份分级报告:四行生命体征量表、一行 checked 列出这次确认干净的子系统、一个百分制健康分,之后把 finding 分进 CRITICAL、WARNING、NOTE。每次运行还会在本地写一份 SQLite 基线,所以从第三次运行起,它就能说出变了什么、变了多少;pgbot why 则从这份历史里把症状、背后的机制与最早的触发串成一条链。输出可以走一份带版本、无 PII 的 JSON 契约(配有公开的 JSON Schema),也可以走 SARIF(进 GitHub 的 Security 页)、JUnit、Prometheus textfile 格式,以及一个自包含的 HTML 报告页。pgbot mcp 把同一批 finding 通过 Model Context Protocol 交给 agent,而 ask 与 explain 只让模型解读它们,绝不生成它们。
谁做的仓库属于 pgrundev 这个组织,310 次提交里有 252 次带着 Shapalov 的账号、姓名与邮箱;换掉 Postgres 驱动的那条 pull request、以及把项目标识放进 README 的那条,也是他写的。dependabot 另有 22 次提交,贡献者名单上还有另外十二个人:10xdev4u-alt 与 DivyamTalwar 各八次,lofoneh 七次,DiegoDAF 三次,edwardsb 与 GitHub 的 Copilot 各两次,六人各一次。310 次提交全部能对应到关联账号,其中 65 次带共同作者尾注——21 条 Claude Opus 4.8、13 条 dependabot、10 条 Claude Fable 5、9 条 Claude Fable 5.1、8 条 the-ai-developer。
它是怎么搭起来的
组成 · 6一个静态 Go 二进制,以及一条围住「它被允许做什么」的硬边界。它用持有 pg_monitor 的角色连接,用 default_transaction_read_only、statement_timeout=15s 与 lock_timeout=2s 把每个会话钉成只读,并把每个探测包在自己的 BEGIN READ ONLY … COMMIT 里;SQL 本身放在 internal/collect/sql/ 下的 25 个文件里,由各 collector 加载。计数器在一个区间里采两次,报告因此能给出实时速率;其余读到的值都对着本地 SQLite 基线做趋势。finding 全部在 Go 里算出来——光 internal/findings/findings.go 一个文件就有 115,563 字节——再写进一份带版本、无 PII 的 JSON Context,其中每个区段都挂着一个 exactness 标签:sampled、cumulative、scraped 或 unavailable。渲染器从这同一份文档产出终端仪表盘、SARIF、JUnit、Prometheus textfile 与一个自包含的 HTML 页;pgbot mcp 把同一份文档通过 stdio 交给 agent;pgbot why 则通过一个自己不开数据库的纯引擎去读快照历史。AI 层严格地坐在最上面,只被允许解释引擎已经找到的东西。
- cmd/pgbot/
- 五十个文件、249 KB——一个命令一个文件:
inspect(13,565 字节)、advise(12,664)、alldbs(12,829)、why(11,449)、waits(10,486),以及logs、erd、init、vacuum、tune、config、baselines等等;MCP 服务器是mcp.go(17,998),工具定义在mcp_tools.go(10,868)。五十个文件里有二十个是测试。 - internal/findings/、internal/collect/ 与各引擎
- 诊断内核:findings 有 33 个文件、236 KB,其中
findings.go一个文件就 115,563 字节,目录元数据在 25,745 字节的catalog.go里;collector 有 67 个文件、179 KB,SQL 作为 25 个.sql文件放在internal/collect/sql/下。周围还有render(24 个文件、116 KB,最大的是 21,924 字节的终端渲染器)、conn(21 个文件、115 KB,最大的是 19,676 字节的 SSH 隧道)、ai(15 个文件、98 KB)、why(6 个文件、39 KB)、单文件 20,896 字节的correlate,以及erd、advisor、diff、mcp、report、events、rate、pglog与config。 - internal/store/、internal/model/ 与 schema/
- 记忆与契约。六个编号迁移——
001_snapshots.sql到006_index_verdicts.sql——放在一个 6,616 字节的 store 下,旁边是留存、等待、事件、抑制与索引裁定;internal/model/context.go的 37,050 字节,就是其他所有部分都在读写的文档。schema/里是六份公开的 JSON Schema,合计 175 KB,从pgbot-context-1.1.0.json到1.5.0.json,外加pgbot-advise-1.0.0.json,由 1,512 字节的tools/schemagen/main.go生成。 - docs/
docs/findings/下六十一页 finding 与它们的索引(296 KB),一份按症状浏览的 README;另有providers.md(9,300 字节,逐家托管商的说明加一份实测清单)、configuration.md(6,887,抑制契约与每个 finding 的对象标识表)、release.md(5,306),以及唯一一份设计文档docs/superpowers/specs/2026-08-23-pgbot-why-design.md(6,715)。- 构建、发布与打包
- 14,833 字节的 CI 工作流、8,941 字节的发布工作流、5,577 字节的 GoReleaser 配置、4,176 字节给 GitHub Action 用的
action.yml、7,796 字节的install.sh,加上Dockerfile、Makefile、给 PostgreSQL 矩阵用的docker-compose.test.yml、作为推送前本地闸门的scripts/gate.sh(2,408 字节),以及 Nix 的flake.nix与package.nix。npm 这条路是一个 3,420 字节的构建脚本、一个 3,473 字节、负责定位预编译二进制的包装器,和一份 9,978 字节的包装器测试。 - agent 接口面
.claude-plugin/marketplace.json与plugin.json让这个仓库自己就是一个 Claude Code 插件市场;commands/下是三个斜杠命令(pg-health、pg-slow、pg-indexes);skills/postgres-diagnostics/SKILL.md(7,027 字节)是随 1,211 字节安装脚本一起发的打法手册;.mcp.json注册服务器。README 用一节把这几样串起来。
取舍,以及它替代了什么
只读靠角色,不靠开关 替代 一个开关,或者一条「我保证不会写」的超级用户连接
保证来自一个持有
pg_monitor、没有任何写权限的登录角色;会话固定与BEGIN READ ONLY在 README 里被写成它之上的纵深防御。没有pg_monitor时,非超级用户只能看到自己的会话,所以 pgbot 在连接时就检测出来,并直接点出该执行哪条 GRANT,而不是默默给出残缺的数据。只读探测提交,而不是回滚 替代 每个探测跑完就回滚
只读事务两种做法都不写任何东西,但回滚会抬高 pgbot 自己也在报告的那个
xact_rollback计数器。同一种直觉让它在统计时排除掉自己的会话、事务与临时用量,于是它从不把自己的足迹当成数据库的数字。AI 只解释 finding,绝不生成 替代 让模型产出 finding,或者产出因果链
README 的 non-goals 与设计文档各写了一遍,后者直接否掉了由 LLM 生成的因果。模型拿到的就是
--json会打印的那份无 PII Context,被要求把每条 caveat 带进建议里,输出印在一条标明由模型生成、动手前请核实的横线之下;模型报错或没配 key 时,确定性的报告照样在。在已存历史上跑规则式因果链 替代 泛化的统计互相关
设计文档说互相关「spurious, unexplainable — off-brand」,并把链条限制在症状、机制与触发三段,每一跳都带数字与发生时间,而且把时间对齐当作硬门槛,而不是一个可以被平均掉的分数。
why完全离线 替代 连上去取指纹,并把一份新鲜快照当作序列的最后一点这是设计文档在通过之后一天记下的偏离:存储里本来就有用户上次 inspect 留下的新鲜快照,再接一次连接只是「added a failure mode without adding signal」;规格里的
--offline开关也随之变得没有必要,被一并去掉。假设索引,由规划器验证 替代 从查询文本推断出索引建议
候选来自规划器自己的顺序扫描过滤条件,然后每一个都用 hypopg 假设性地建出来并重新规划;只有当规划器真的改用它、且估出的代价下降时才会报出来。什么东西都不会被真的建出来,查询也只用
EXPLAIN (GENERIC_PLAN)规划,从不执行。抑制始终可见 替代 让
.pgbot.toml的一条规则把 finding 从输出里整个拿走被抑制的 finding 连同理由留在 JSON 里,永远不影响退出码,而被抑制的 critical 仍然会渲染,因为「a config must not hide
checksum_failures」;配置文件同时拒绝读取任何形似凭据的键。
依据docs/superpowers/specs/2026-08-23-pgbot-why-design.md(6,715 字节,全文)、带逐文件体积的 cmd/ 与 internal/ 树、schema/(六份 JSON Schema,175 KB)、internal/store/migrations/ 下的编号迁移、README 中关于只读角色、--json 契约、基线存储与 MCP 工具的几节,以及上面引用的各 pull request 串。
制作过程
6 个阶段- 01
从空仓库到第一次提交,只隔十二分钟
仓库建于 2026-08-11 的 23:41:52,而它最早的一次提交——「Add files via upload」——落在同一天的 23:54:02:这个项目是从一次上传开始的,不是从第一次 push 开始。九周之后它有 310 次提交,229 次在八月、81 次在九月,以及二十个 release,从 2026-08-17 的
v0.2.0到 2026-09-06 的v0.8.1。节奏是爆发式的:2026-08-31 晚上 25 分钟内连发四个,从 19:09:30 的v0.6.0到 19:34:56 的v0.6.3;2026-09-01 又跨了三个;2026-08-18 的十八小时里有四个。周围是 1,348 个星、66 个 fork、四个 watcher 和 32 个开着的 issue,标签列表里既有 GitHub Action 钉住的v1,也有一个在任何 release 条目里都没出现的v0.8.0。共有十四个账号贡献过代码:Shapalov 252 次提交,dependabot 22 次,DivyamTalwar 与 10xdev4u-alt 各八次。 - 02
一份在聊天里通过的规格,又被自己的实现改了一遍
docs/superpowers/specs/2026-08-23-pgbot-why-design.md是这个仓库唯一一份架构文档,6,715 字节,开头就给自己标了日期:2026-08-23 在聊天里通过。它把pgbot why设计成在已存的快照历史上跑规则式因果链,并写明自己否掉了什么:泛化的统计互相关,因为那是「spurious, unexplainable — off-brand」;以及任何由 LLM 生成的因果,因为它「violates AI never generates findings」。文档规定了五条机制规则、一个 onset 检测器、一个以时间对齐为硬门槛的置信度评分、一次新增的存储读取、一个新的 MCP 工具,以及一份「每条规则都先从红开始」的测试计划。接着是本档案很少有机会读到的一节——第二天写下的「Implementation deviations (v1, 2026-08-24)」:why最终完全离线,连--offline开关都没有,沿用仓库里diff的既有约定,因为存储里本来就有用户上次 inspect 留下的新鲜快照,再接一次连接只是「added a failure mode without adding signal」。五条规则只发了一条,另外四条是同一个引擎上的后续;target参数被砍掉,因为报告本来就只取最差的三条链。 - 03
换掉 Postgres 驱动,以及一次「失败得正确」的测试
2026-09-30,维护者自己的 pull request 114 把 pgbot 从
pgx换到同组织自研的pggov0.1.0——一个只用标准库、不依赖第三方库的 wire protocol 客户端——于是pgx、pgpassfile、pgservicefile与puddle一起离开模块图。先移植的是连接层:连接池、会话固定、只读事务、SSH 的DialFunc、连接池与 PgDog 探测、Aurora 的--all-instances主机覆盖。然后是各 collector、erd、logs、走简单协议做EXPLAIN (GENERIC_PLAN)的advise、MCP 工具与集成测试,并在 PostgreSQL 13 到 18 以及 19beta1 上走 TLS 验证过。第一次 CI 在 PostgreSQL 15 及以上挂了TestIntegration_ratesArePresent,14 却通过;维护者在那条 pull request 下的分析,正是这件事值得记下来的原因:从 PostgreSQL 15 起,后端只在转入空闲时才把计数器刷进pg_stat_database,而 CI 的写入负载是一整个DO循环,于是那些提交在测试采样时是看不见的。本地复现时,xact_commit每次采样正好加一——采样器数到了自己。在同一负载下,旧构建靠数自己的流量通过,维护者写得很直白:它「would also have passed with the stats-caching bug the guard exists to catch」;而新构建在窗口里留下的自我流量更少,于是正确地看到了每秒零事务。 - 04
一个下午开出二十个连号条目
2026-09-22 的 00:18 到 19:44 之间,一位叫 DivyamTalwar 的贡献者开了二十个连号条目——85 到 104——其中九组是一个 issue 配上修它的 pull request,另有两个单独的 pull request。到材料的最后一天,除第一个之外全部还开着。这些配对读起来像一套方法:先在一个点名的上游提交上复现,再说明测试里哪些部分是真的(真正的 Cobra 命令、真正的文件型 SQLite 存储、真正的 npm 目录布局)、哪些是注入的,然后记下验证过的提交哈希,并给出在该提交 HEAD 上通过的
bash scripts/gate.sh或 race 套件。这些缺陷是同一个主题:没被观测到的值,与测出来的零无法区分。 一个失败的 collector 会返回标着 unavailable 的区段,而store.Save把它那些零值字段提进了趋势列,于是凭空造出一个体积为零的数据库;已存基线里 unavailable 的区段又会在对比时冒出来,变成假的连接下跌与备库丢失;WAL 归档的 finding 拿观看者的时钟而不是快照的采集时间去量,于是一份序列化后完全没变的 Context,事后重算时会给出不同结论。每一条的修法都是同一个形状:未知就留成 SQL NULL,测出来的零就保留,来源不可观测的区段拒绝比较。 - 05
schema 版本号不是免费的数字
JSON 契约按版本一文件地发布——
schema/pgbot-context-1.1.0.json到1.5.0.json,合计 175 KB,由一个 1,512 字节的tools/schemagen/main.go生成——而文件名里带着版本号,两条都去改它的 pull request 就一定会撞。replica identity 那条 finding 的 pull request 113 正是如此:它本来从 1.4.0 起,另一个 pull request 拿走了这个号,于是贡献者最后一条评论说冲突已解决、schema 已重新生成成 1.5.0。维护者那一侧只有一行——「@lofoneh, tnx, pls resolve conflicts」——而同一行也出现在 DivyamTalwar 那条关于 advisor 的 pull request 下,时间是 2026-09-30 的 04:27:01,比材料里最新的一次提交(一次 dependabot 升级)晚一分钟。那位贡献者早就在串里回答了自己的 CI 失败:PostgreSQL 16 到 18 的容器缺少新回归所需的 HypoPG 服务端包,随后一个提交把它装上并记录了前置条件,并且写明没有任何断言或集成检查被关掉。那条 finding 本身靠在wal_level=logical的服务器上对每张已发布表真跑一次UPDATE来立标准,也报出了他「wouldn’t have guessed」的那种情况:DROP INDEX之后,relreplident仍然是i,背后却什么都没有。 - 06
文档被当成产物,连 alpha 通道都算
README 一项就有 60,582 字节,而这个仓库的文字不是附属品:
docs/findings/下有 61 页 finding(296 KB,从一篇 2,126 字节、讲 pgaudit 双重记日志的短页,到一篇 8,364 字节、讲 vacuum horizon 被堵住的长页),加上一份按症状索引的 README 和一份留给下一篇的模板。这些文字也不是没人核对:internal/findings/docs_catalog_test.go与internal/collect/docverify_integration_test.go会把目录与引擎真正产出的 finding 对起来,而pgbot explain-finding <id>从二进制里印出同一页,于是 agent 用的是 pgbot 自己的说法,而不是自己编一个。同样的讲究也覆盖 README 称为承重的那几条不变量——只读、finding 确定性、输出无 PII——它们由测试而不是由评审来守:一份针对所采集 SQL 的readonly_sql_test.go、一份 1,877 字节、把EXPLAIN的执行形态挡在 collector 之外的no_explain_analyze_test.go、一份 10,195 字节的脱敏测试,以及 findings 与 render 两个包里的安全面测试。这种讲究也出现在一处只有一个文件的改动上:pull request 106 把项目标识放进 README 头部,并用三段解释这个决定——图片是提交进仓库而不是外链,因为那个头像地址绑着组织头像,?s=的尺寸对高分屏又太小;深色外框被保留,是因为上传的文件是没有透明通道的 RGB,GitHub 上看到的圆角其实是 GitHub 自己裁的,直接放进 README 会在浅色主题下渲染成一个硬邦邦的黑方块;而「只把圆抠出来」是先试过的做法,它失败了,因为那张脸是白的,在浅色主题下会消失。最后的做法是把一个圆角矩形蒙进 alpha 通道。
相关档案
全部档案 →第 070 号
OpenChatCut
一个本地优先的视频剪辑器,剪辑方式是跟它说话:内置 agent 与外部 Codex、Claude Code 会话调用的是界面自己在用的同一套剪辑工具,于是每一处改动都落在一条真实的多轨时间线上——是片段、转场、字幕、特效或音频,仍然能拖、能撤销、能导出。工程与素材留在本机,预览与最终渲染都出自 Remotion。
第 064 号
delegate-skills
一个技能包,给每一种编码 agent CLI 各配一份委派技能:编排方写好自足的任务书,另一条 CLI 去改真实工作树,而审查与提交留给人。
第 061 号
Reticle
一个 MCP 服务器加一个只在开发期生效的 SDK:让编码 agent 从应用内部去读、去操作一个正在运行的 web 或桌面应用,然后给出判词和该改的文件与行号,而不是一张截图。