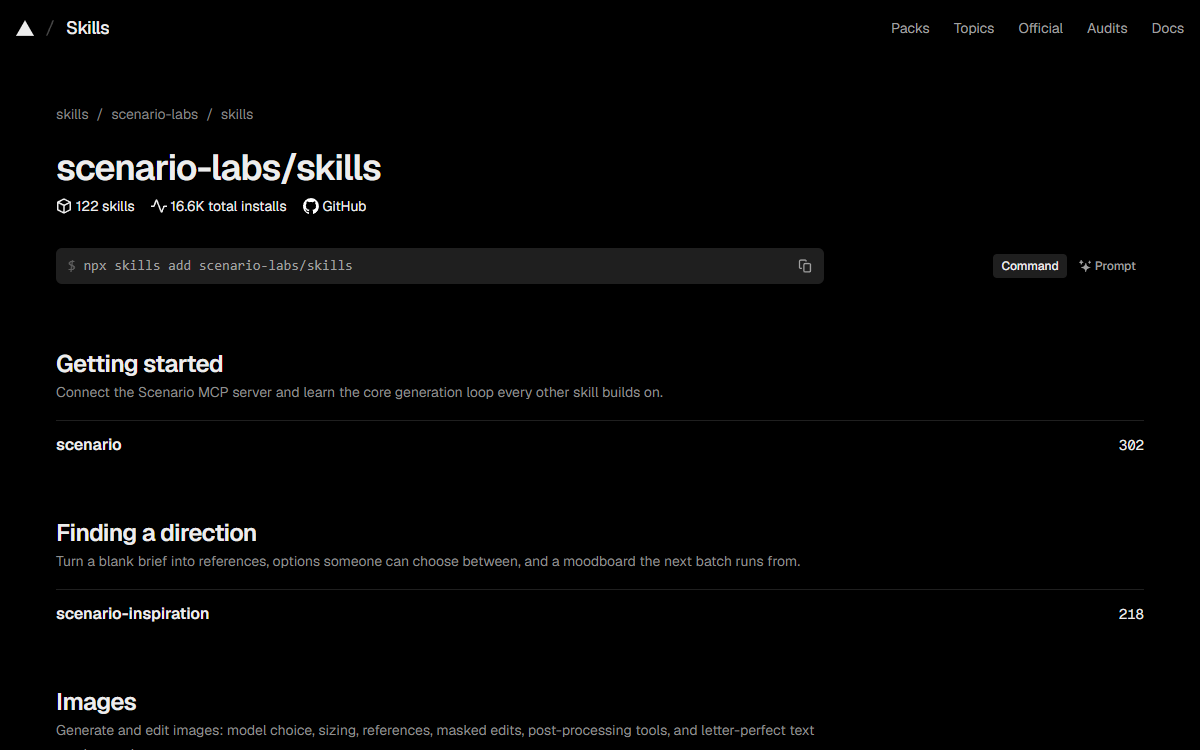
这是什么
Scenario 的公开技能库。122 个技能教编码 agent 如何通过这家公司的 MCP 服务器产出图像、视频、音频、贴图、天空盒、3D 资产与自训练模型,安装方式是 npx skills add scenario-labs/skills。其中 65 个是核心技能,一个目录一个 SKILL.md,围绕一个讲生成循环的中枢技能组织起来——发现能力、读 schema、跑任务、等待、展示、下载。另外 57 个是专家工具:五个家族,每个家族一个 lead 加若干专家,驱动装在用户自己机器上的 ZBrush、Blender、Maya、Unreal Engine 与 Unity。两层都要服从一份写下来的写作契约——正文目标 1,000 词、硬上限 2,500 词、固定结构、frontmatter 只允许 name、description 与 license,以及技能里每发布一个脚本就得有对应测试。持续集成与 pre-commit 钩子负责机械的那一半;真正的合入门槛是一个从没见过仓库的清房 agent——让它写一份工具调用计划,再拿实时工具参考逐条打分。仓库是 MIT 协议,建于 2026-08-12,有 794 个星。
谁做的仓库归 Scenario Labs——也就是 Scenario 这家生成式媒体公司——所有。148 次提交里 129 次是 Hervé Nivon 写的;一个发版机器人占十四次,Emmanuel de Maistre、另一位 Scenario 账号各两次,还有一位账号一次。148 次提交里有 146 次带着至少一条共同作者尾注,其中 126 条写的是某个 Claude 模型,四条 Codex,一条 Cursor,十四条是那个机器人,一条是人类的同事——因为仓库自己的指引规定了该怎么署模型的名。
它是怎么搭起来的
组成 · 6一个提示词库,按代码库的方式在管。每个技能是一个目录加一个 markdown 文件,参考文档和脚本要么放在旁边、要么刻意不放在旁边;把 122 个这样的小东西拢在一起的,是一份写下来的契约加一条检查流水线,而不是某种评审文化:一个把算式一起写出来的词数预算、一个固定的正文结构、一个规范校验器、一个拼写检查、一份必须与分组文件互为镜像的 README,以及一份由同一个文件生成的清单。两个后果塑造了其余一切。第一,一个技能好不好,看的是 agent 装上它之后行为有没有不同,所以真正的门槛是一个从没见过仓库的清房 agent,拿它的计划去和实时工具参考比对——这让预期的失败形态落在文字上,而不是代码上。第二,底下是一整个模型市场:一个技能只按厂商家族命名、不带版本号,也从不把生成式模型 id 写死,于是新一代模型出事也弄不坏一个技能名;而驱动本机桌面软件、不走 API 的专家层,带着逐条写清的差异,留在同一棵树里。
- skills/
- 65 个核心技能,一个目录一个
SKILL.md,从 4.6 KB 的单车道技能到讲生成循环的 24,739 字符中枢技能——别的技能都要调它。少数几个带references/目录、脚本或生成出来的模板:精灵图网格、等距模板、文字叠加的载荷参考、训练用的数据集整理笔记。 - skills/dcc/ 与 skills/game-engines/
- 57 个专家技能,
dcc下 232 个文件、game-engines下 467 个文件,每个家族一份 README 记它是怎么建起来的。每个技能都带references/sources.md,几乎都带procedures.md、critique.md、expert-notes.md;41 个还带gui-paths.md,写明软件里的菜单和对话框;专家们 import lead 的scripts/,所以这里有 148 个 Python 文件,最大的一个 196,922 字符。 - scripts/ 与 tests/
- 十二个执行契约的仓库脚本——文风、支持文件、分组、README 镜像、生成的清单、拼写、命令软链接、规范校验——加十四个测试目录存放已发布技能脚本的套件,再加一个针对 agent 命令文件的回归套件,以及一次实时分析验证留下的证据目录:截图、合成检查、示例看板与一份样例报告。
- .agents/ 与 .claude/
- agent 层:
.agents/skills/下六个SKILL.md——两个是给在这个仓库里干活的人用的 Anthropic 技能,出处与哈希记在skills-lock.json里,另外四个是维护者命令——.claude/skills与.claude/commands里放着三十到五十字节的软链接,CLAUDE.md是九字节,指向 Codex 也在读的同一份指引。 - skills.sh.json 与 .claude-plugin/
- 目录。
skills.sh.json(9,393 字节)是「哪个技能属于哪个分组」的唯一真源;插件市场清单(12,595 字节)由它生成——因为安装器的选择界面只读清单,而目录页只读那份 JSON——两者一旦不同步,检查就会失败。 - 发布与 lint 配置
- release-please 的配置与七字节的
version.txt,四个工作流分别管持续集成、发版、changelog 发布与 pull request 标题检查,commitlint 的合法 scope 直接从技能目录名推出来,一份 9,403 字节的项目词典,以及让同一批检查能在提交前本地跑的格式化与拼写配置。
取舍,以及它替代了什么
把技能正文卡在 2,500 词 替代 相信规范——它并没有对格式设限
这件事是被论证出来而不是被宣布的:参考校验器能干净地放行一份 20 万词的正文;流传很广的「5,000 词」本来是给已经跑坏的技能开的调试药方;真正会咬人的是,一个被触发的技能在压缩后重新挂载时只有前 5,000 个 token 的额度,而这个额度来自所有技能共享的 25,000 token 池。按这个仓库约每词 1.75 token 的密度,2,500 词接近 4,400 token,在单技能上限之内、还给标识符密集的行文留了余量;再往上,正文是用内容换截断。
超出预算就删,而不是拆出去 替代 把事实挪进一个被链接的参考文件
正文每次触发都会加载,参考文件只有 agent 顺着链接去读才加载;所以一份流程每次都要读的参考,本质是一个多绕一跳的更长正文。每次都用到的事实留在正文里,只有真正情境化的内容——深表、分模式细节、脚本——才外链,这一点指引里是明说的,不留给口味决定。
技能里绝不写生成式模型 id 替代 写死撰写技能时那一代模型
可用性按团队而异,而今天写下的那一代几个月内就会被取代,所以经由「按能力排序」的工具去发现,是通往生成式模型的唯一正路。例外很窄而且写了出来:平台上没有竞争替代品的工具,以及一个技能存在的全部意义就是去跑的那个成员。这条测试也用在 Scenario 自家的工具上:64 个打了工具标签的 Scenario 模型里有三个没通过,因为同一个操作有上游厂商在做。
按家族命名,不带版本号 替代 让技能名背上当前那一代
技能名是永久标识——安装、README 行、分组文件、兄弟技能之间的交叉引用都认它——而模型代数几个月一换,所以带版本的名字在下一代发布当天就过期,代价要么是一次破坏性改名,要么是一堆近重复技能抢同一个触发词。版本是数据,不是身份:版本关键词该待在 description 里,这样按版本搜索照样能找到这个技能。
把模型写进提交尾注,且格式被规定死 替代 让一次提交的署名含糊过去
指引把尾注管到模型、推理档位、速度档,要求按当次会话的真实设置写而不是仓库默认值,不确定的字段宁可省略也不许猜,并且要求把尾注带进最终的 squash message。效果在历史里可以量出来:148 次提交有 146 次带共同作者行,其中 126 条写的是某个 Claude 模型。
依据AGENTS.md(37,286 字符)全文、README.md(54,000 字符)、CHANGELOG.md(13,500 字符)与 version.txt;报告中引用的三十个 pull request 与 issue(#141 到 #170),其中包括附在 #153、#154、#155、#156、#159、#161、#163 上的应用测试报告;完整的 968 个文件树及其体积与两级目录汇总;以及 scripts/ 下的十二个脚本。
制作过程
6 个阶段- 01
七个星期,一百二十二个技能
仓库建于 2026-08-12,最后一次推送是 2026-09-30。这段时间里它收了 148 次提交——八月 85 次(都在 12 日之后),九月 63 次——长到 968 个文件。树里 128 个
SKILL.md有 122 个是对外发布的:65 个核心技能各自占skills/下的一个目录,另外 57 个是五个家族的专家工具,按把它们搬进来的那条 pull request 分是 ZBrush 9、Blender 13、Maya 11、Unreal Engine 10、Unity 14。剩下六个,两个是给在这个仓库里干活的人用的 Anthropic 技能,四个是维护者命令。一个改动就是靠 release 走到用户手里的:安装永远从main取最新副本,没有版本钉住这回事——十四个 release,从 2026-08-28 的skills-v0.37.3到 2026-09-26 的skills-v0.48.0,差不多两天一个。它们生成的 changelog 里有 47 条——29 条 feature、17 条 bug fix、1 条文档——而version.txt写的是 0.48.0,0.48.1 的发布 pull request 到 2026-09-28 还开着。代码旁边是 794 个星、93 个 fork、十四个开着的 issue。 - 02
这些提交到底是谁、或者是什么写的
历史里一共出现五个账号。Hervé Nivon 写了 148 次提交里的 129 次,其中 128 次用的是 scenario.com 的邮箱;一个发版机器人占十四次;Emmanuel de Maistre 和另一位 Scenario 账号各两次;第五个账号一次。真正让这段历史值得读的是尾注:148 次提交里有 146 次至少带一条共同作者行,清点下来 126 条写的是某个 Claude 模型——其中 38 条只写「Claude」,38 条「Claude Fable 5」,25 条「Claude Fable 5.1」,其余是 Opus 与 Sonnet 各版本——外加四条 Codex、一条 Cursor、十四条那个机器人、一条人类的同事。这是写下来的规矩,不是习惯。仓库的 agent 指引里有一节叫「Codex commit attribution」,把尾注管到字段一级:模型、推理档位、速度档,要求按当次会话的真实设置写而不是仓库默认值,不确定的字段宁可省略也不许猜,并且要把尾注带进最终的 squash message,让署名在 squash 工作流之后仍然存活。另一条规则从反面说同一件事:只有
feat、fix、docs、perf、revert这几类提交会进 release,所以改了已发布技能内容的提交必须写成其中一类,否则只能等别人的 release 把它带出去。 - 03
一份契约、十二个脚本、九道门
这个仓库是被一份文档组织起来的。
AGENTS.md有 37,286 个字符,全是写作契约:frontmatter 只允许name、description与license;名字必须等于目录名;描述用第三人称、以「Use when」开头、只讲触发条件、不超过 500 字符;正文目标 1,000 词、硬上限 2,500 词;结构固定为 Overview、Quick reference、一个做透的例子、Common mistakes。支持文件只有在内容实在塞不进正文时才可以放在SKILL.md旁边,而且必须由正文直接链接,因为隔着一层文件转引的参考可能永远不会被读。技能发布的脚本住在技能目录里,但它的测试套件住在仓库根的tests/<name>/,每发布一个脚本就一个目录:一共十四个测试目录。周围还有十二个仓库脚本,pre-commit 钩子按顺序跑它们——先给拼写词典排序,再重新生成插件清单,然后pnpm validate,也就是九项检查:文风与正文预算、格式化、支持文件、分组、生成的清单、README 与分组的镜像关系、词典、拼写,以及 Agent Skills 规范校验器。同一份文件还记着一个打自己的 bug:在 git worktree 里提交会让规范校验失败,因为 git 会把GIT_DIR导出给钩子,于是校验只能在清掉它的 shell 里跑,提交则要用--no-verify。 - 04
决定一个技能到底教没教会的测试
机械校验检查的是文件合不合格式;第二套流程检查的是这段文字有没有教会,而 pull request 里吵的正是这个。
/skills:validate <name>先写一个用例,把工作树里的副本装进一个完全没有仓库上下文的清房 agent,只给它那个技能、真实安装会一起装的scenario核心技能、以及一个贴近真实的任务,然后要它给出一份编号的工具调用计划,工具名和参数形状都要写准:只做计划,不许执行、不许浏览,不确定要标出来而不是猜。这份计划再拿去和工具参考逐条比对,参考是现取的,不是背出来的。编出一个不存在的工具名,失败。把生成式模型 id 当常量写死,失败。在有 MCP 工具的环节改去调 REST API、SDK 或命令行,失败。而在技能正文和工具参考里都找不到出处的话,哪怕它碰巧是对的,也算猜的。一次失败会被当成文字里的缺陷,换一个全新的 agent 重跑,因为失败过的 agent 已经被自己的错误污染了。新技能还额外做一次「什么都没装」的基线探针,确认它值它占的那点上下文。每轮都预先登记预算,报告里有一轮写的是两次静帧、二十四次片段、700 CU。 - 05
用一次失败换来的规则
这些讨论很愿意把没成的事记下来。有一条 pull request 教了一种「让提示词随工作流分支变化」的写法,独立跑出来的结果是提示词对了、而工作流任务永远停在 in-progress,因为分支只会跳过接在它自己 handle 上的那个节点。那条规则被撤掉,换成三个各自经过实跑验证的形状,外加在一次文本变换里写条件表达式。另一条加了视差背景这一车道,在实跑视觉验收上失败——五次模型运行、六次 dry run 之后确认:让一次生成去产出「那些图层」,拿回来的是一张画着叠起来图层的图;于是这条车道要么去拆一张画完的画,要么每个深度层各跑一次。还有一条教 agent 上传前先转 HEIC;API 发版之后 HEIC 不再被拒,那段话只能重写,分支被重置到
main上强推,而讨论里同时留着早先的说法和它改变的原因。另有一处是往回走的:一次配对测试表明,记在一个新比较技能名下的能力,其实核心技能和公开的工具契约本来就有。还有两条规则读起来像伤疤——交付的视频要用抽帧拼成 contact sheet 去扫,而不是一个镜头挑一帧,因为一个中途才浮现的瑕疵曾经在 10.5 秒处蒙混过关,而那段片子的瑕疵出现在 11.0 秒——以及,一个机制在大概两次没有结论的对照实验之后就别再追了。 - 06
搬来五十七个技能,也把验证到哪一步留了下来
最大的一次改动是专家层:五十七个技能、五个家族,从 Emmanuel de Maistre 自己的专家技能仓库搬过来,2026-09-25 合入,pull request 里写明了出处。它们是从专家视频、演讲和官方文档里提炼的,然后在同一个模型不带这些技能的情况下盲评过一轮。每个家族是一个 lead 加若干按主题命名的专家,专家们 import lead 的
scripts/,所以一个家族要整套安装。配套件整齐得惊人:五十七个全都带references/sources.md,几乎全都带procedures.md、critique.md、expert-notes.md——分别是 57、53、52、52 个文件——其中 41 个还带gui-paths.md;148 个 Python 脚本里最大的一个是 196,922 字符的 Maya 灯光模块,比 54,000 字符的 README 还大。每个家族目录都有一份 README,记着这个家族是怎么建的、验证到哪一步;而这种诚实一直活到合并里:有一次改动把「还没在 Maya 或引擎里跑过」这类状态说明从模块 docstring 和家族 README 里删掉,同时在自己的正文里列出这些说明还留在哪些文件中;Unity 家族则声称每一条流程都在 Unity 6.3 里实跑过。
相关档案
全部档案 →第 091 号
OKF Agent Memory
把编码 agent 学到的东西以纯 Markdown 留在仓库里——一个用进程内 BM25 检索的 OKF v0.2 知识 bundle——于是这份记忆可以被 diff、被审阅,而不必住进数据库。
第 070 号
OpenChatCut
一个本地优先的视频剪辑器,剪辑方式是跟它说话:内置 agent 与外部 Codex、Claude Code 会话调用的是界面自己在用的同一套剪辑工具,于是每一处改动都落在一条真实的多轨时间线上——是片段、转场、字幕、特效或音频,仍然能拖、能撤销、能导出。工程与素材留在本机,预览与最终渲染都出自 Remotion。
第 067 号
tty7
一个纯 Rust 写的终端:shell 属于后台的服务器而不是窗口,退出应用它们照跑;重启之后面板带着原有布局和最后留在屏幕上的内容回来,四条 CLI 命令能让一个编码 agent 驱动另一个,而远端工作区就是同一个服务器跑在另一台机器上。