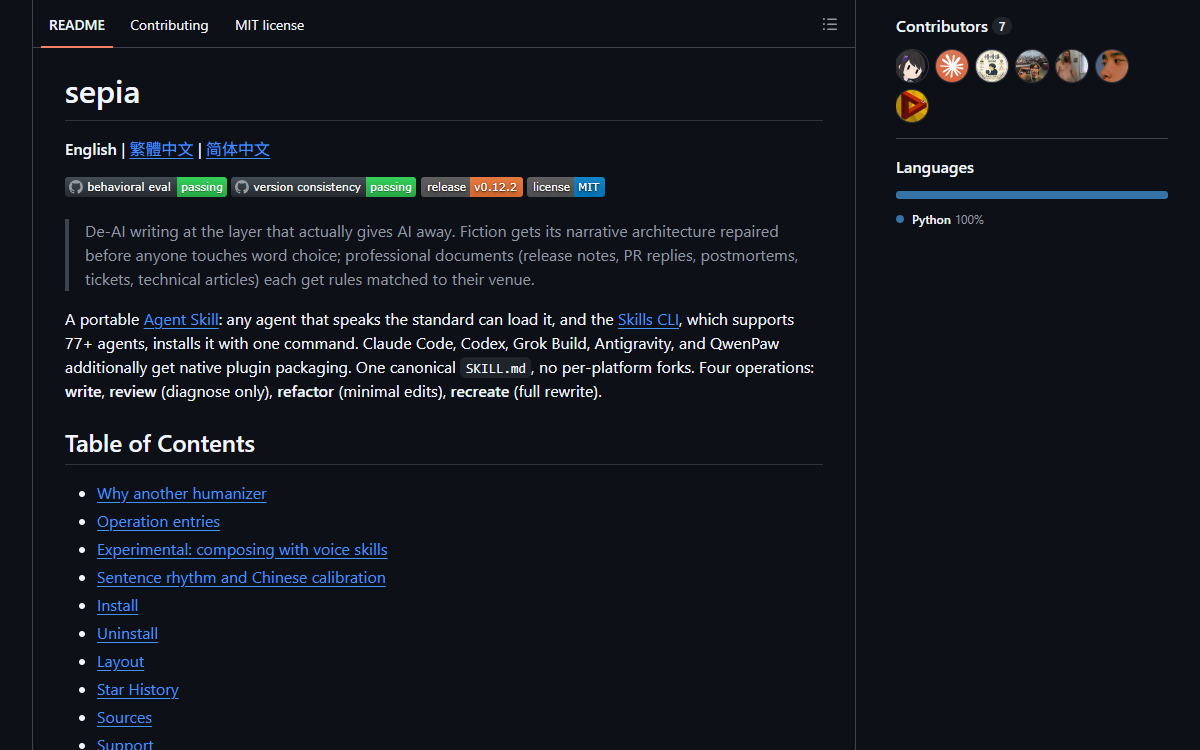
这是什么
sepia 是给编码 agent 用的写作技能,它的论点在于「破绽到底长在哪一层」:长在结构里,不在用词里。通用的人味化工具改的是词汇和句法,而它从一个实验出发——人类编辑把 AI 小说的表层文风整个改写之后,分类器仍然抓得住,检出率只从 95.5% 掉到 93.9%——所以小说要先过叙事结构这一趟,才轮到字句;专业文稿则在同一份清单之上,按场合各套一份薄规则文件。四个操作——write、review、refactor、recreate——跑在同一份 SKILL.md 上,任何说 Agent Skills 标准的 agent 都能装(Skills CLI 支持 77 个以上),另外给 Claude Code、Codex、Grok Build、Antigravity 与 QwenPaw 各做了原生插件打包。它不知道的事会标出来而不是编出来:每条规则背后的证据都消化进一个研究目录,后面站着十五份一手研究;厂商没有发布提示指南的,就记为「已咨询」,不靠猜。
谁做的仓库的 303 次提交来自六个账号:283 次出自维护者自己,且用了两个提交名——Nanako Tsai 214 次、Nyanako 69 次,两者都指向同一个 GitHub 账号;其余是 AugustusW 13 次、CallMeHFK 2 次、shihyuho 2 次、Franky100-pig 1 次、javaht 1 次,另有一次提交没有关联账号。三分之二的提交——303 次里的 202 次——带共同作者尾注,其中 201 条写的是一个 Claude 模型:Fable 5.1 152 条、Fable 5 25 条、Opus 5(1M 上下文)19 条、Opus 5.5(1M 上下文)5 条;剩下那一条尾注写的是一个人。
它是怎么搭起来的
组成 · 6这里的一切都是文本,外加两个小小的 Python 校验器;形状来自一个决定:规则就是产品,所以规则的证据必须跟着规则一起走。一份 SKILL.md 负责路由——这是哪种文稿、跑哪几趟审视、套哪套校准——其余文件要么是路由能调用的某一趟审视,要么是按领域分的规则文件、按模型分的指纹、语言校准,或者叠在上面的声音档。四个操作是这一份技能的包装,而不是四份技能,所以 README 才会说单独安装包装不受支持。可移植性靠打包换来,而不是靠分叉:同一份 Markdown 只签入一次,通过五份插件清单被取用,其中一份走软链——而那也正是这个包已知安装 bug 的来源。规则旁边放着两样比文字更被信任的东西:一个每条说法都带着出处和边界的 research 目录,以及宁可拒绝也不去解析畸形提交的校验器。这里没有服务、没有运行时、也没有模型调用;使用时真正在跑的是宿主 agent 在读这些文件。
- skills/sepia/ 与五个包装技能
- 产品本体:21 个文件、232 KB。
SKILL.md13,642 字节,管路由、操作与护栏;references/下是三趟审视——叙事 12,995、话语 5,393、文风 15,365——外加 30 项特征的rubric.md(9,460)、model-fingerprints.md(19,021)、专业文稿清单(8,136)、六个按领域分的规则文件(1,725 到 8,985 字节)、voice-skills.md(12,920),以及中文校准languages/zh.md(30,604)。旁边五个兄弟技能是薄的固定操作包装,每个 1,022 到 1,819 字节。 - references/voices/
- 声音层:
tw-journalism.md34,825 字节,是全仓库最大的文件——九个叙事形状,每个都带它的动作、出处、对应的 sepia 检查项和已知代价——旁边是hemingway.md(12,731)、散文优先的PERSONA-TEMPLATE.md(7,084)、第一份内置人设personas/nyaneko.md(27,623)以及registry.md(6,381)。 - research/
- 十一个消化文档,按报告自己的算法是 167 KB:领头的
sources.md61,944 字节,是那份每条规则都写明证据及其边界的账本;其后是hemingway.md16,909、newswriting-guides.md16,498、citations-style.md15,763、zh-news-corpus.md15,624、rhythm-syntax.md13,312、storyscope.md10,534、detectors.md7,852 与citations-narrative.md6,011。 - scripts/ 与 tests/
- 两个校验器加各自的测试模块:
check_persona.py21,316 字节,配tests/test_check_persona.py28,797;check_versions.py16,378,配tests/test_check_versions.py23,862——51 KB 的测试对着 37 KB 的脚本。v0.11.0 发版时全套是 88 个测试,到 2026-09-20 是 94 个。 - evals/ 与 .github/workflows/
- 只有一例行为评测
deaify-release-note:1,160 字节的 prompt,加三个 grader——skill-fired.md104 字节、no-slop-markers.md234、reads-human.md889——由一条 3,996 字节的流水线在每次推送时通过claude plugin eval跑;旁边是 627 字节的版本一致性检查,和一份 3,518 字节的.coderabbit.yaml,后者把auto_pause_after_reviewed_commits从 5 提到 20。 - 五套打包与三份 README
- 给 Antigravity 的
plugin.json(182 字节);.claude-plugin/(358 与 458)、.codex-plugin/(358)、.qwenpaw-plugin/(plugin.json916、plugin.py7,417,加一条九字节的skills软链)、.agents/(marketplace.json229、workflows/sepia.md843,加一个 18 字节的skills/sepia条目)。文档是三份 README——英文 20,473、简体 20,333、繁体 19,639 字节——再加 9,805 字节的CONTRIBUTING.md。
取舍,以及它替代了什么
先修叙事结构,再动用词 替代 一个只改词汇和句法的人味化工具
项目赖以立身的那项研究把这个替代方案直接测过:人类编辑改写 AI 小说的表层文风之后,只用结构的分类器仍然检得出来,macro-F1 从 95.5% 到 93.9%。经得起这种编辑的破绽都是建筑性的——主题被叙述者解释掉、只有一条因果过于齐整的线、情绪只以身体感受出现、没有现实世界的指涉——所以第一趟审视就做这些。
朝人的分布校准,而不是把 AI 的分布反过来 替代 优化检测器打分的那些表层统计量
README 把它写成治理原则,issue #268 把它推到底:对 burstiness 与 perplexity 不做优化是刻意的,项目也明说自己不以规避检测器为目标。于是,一个加上这两个轴的可选诊断的第一个 pull request 被关掉,换成标题、正文和分支名里都不出现检测器措辞的版本。
厂商不说话的时候,就记为「已咨询」 替代 靠推断得出某个模型默认怎么写
README 把这条写成规则——厂商没有发布提示指南的记为已咨询,不靠猜——pull request 里也照此执行:
Opus 5.5、GPT-6 Sol 与 GPT-6 Luna 一条可执行的行都没拿到;而页面确实给了说法的地方,#280 把「三条」换成五条原文并列,并解释结论为何仍然成立。留下句长离散度,丢掉另外三个表层信号 替代 凡是数得出来的都检查
README 用一张表把四个句法量按研究结论分开:段落内方差在人写的文本里一致更高,中英文语料都如此,所以留作信号;而平均句长、标点数量和段落长度被丢掉,因为在不同语料里测出的方向互相矛盾。
拒绝畸形的贡献,而不是去解析它 替代 猜一个坏表格行的单元格边界
人设校验器原本只收集以竖线开头的覆写行,于是一个被格式禁止的 token 可以藏在不带开头竖线的行里。修法是直接报错并点出那一行,pull request 里用一句话给了理由:猜畸形行的单元格,guard 比 row 还多。
人设用散文描述,而不是用测量值描述 替代 用句长占比、emoji 密度和数出来的动作搭一个身体
第一份内置人设被重写了两遍,最后由同一份事实清单上的五次运行定了案:量出来的版本读起来像一个格式,而写作者自己那份不含任何分布目标的散文式说明,产出了读者认得出是她的输出。模板因此变成散文优先、只留一个可选的范例小节,而那些测量留在原地——它们的说法本就绑在语料上。
依据README.md(20,473 字节)与 README.zh-CN.md(20,333)、README.zh-TW.md(19,639)、CONTRIBUTING.md、完整的 65 个文件树及其体积,以及这段描述所依据的 pull request 与 issue 正文——#257、#258、#263、#264、#265、#266、#267、#268、#270、#271、#273、#274、#275、#277、#280、#281 与 #283。recon 报告的架构文档扫描没有找到单独的设计文档:这个仓库的形态写在 README、references/ 和 research/ 里。
制作过程
6 个阶段- 01
二十七天、303 次提交,以及尾注里写的是谁
仓库建于 2026-08-28,最后一次推送是 2026-09-23:二十七天、303 次提交、十四个 release,从它出现当天的 v0.2.0 到 2026-09-22 的 v0.12.2。节奏并不均匀——八月 45 次、九月 258 次——但真正值得读的是作者构成。303 次里有 283 次来自同一个账号,用了两个提交名:
Nanako Tsai214 次、Nyanako69 次;202 次带共同作者尾注,其中 201 条写的是一个 Claude 模型——Fable 5.1152 条、Fable 525 条、Opus 5(1M 上下文)19 条、Opus 5.5(1M 上下文)5 条——而写人的尾注只有一条。剩下的提交来自另外五个账号:AugustusW 13 次、CallMeHFK 2 次、shihyuho 2 次、Franky100-pig 1 次、javaht 1 次,此外还有一次没有关联账号。发版的 pull request 也是同一种口吻:正文只讲四处版本声明由python3 scripts/check_versions.py核对过,结尾附一条 Claude Code 会话链接,并且明说发布说明写在 tag 上而不是正文里。文档也是这么来的,而且是这个项目自己做的:三份 README 由 Antigravity CLI 跑 sepia 自己的recreate操作重排,走的是文档路线,当前文件是唯一的事实来源,风格指南内联进去,两份译文则加载languages/zh.md。 - 02
研究目录本身就是产品,而且自带边界
把它和一堆 prompt 区分开的,是一个研究目录,以及目录里的一个习惯:每条规则都写明出处,每个出处都写明它没覆盖什么。
research/sources.md有 61,944 字节——在这个几乎全是 Markdown 的仓库里它是最大的文件——README 的来源表列了十五份一手研究。立论的那一份是 StoryScope:61,608 篇故事,作者是人和五个前沿模型,只用叙事结构特征的分类器在 AI 小说上做到 93.2% macro-F1。真正决定设计的是下一个数字:同一项研究里,人类编辑改写过表层文风的那一档,检出率只从 95.5% 降到 93.9%。这道缝就是「修结构而不是换词」的论据。而专业文稿这条路,有一段时间就架在这个论据上、却没有自己的测量;issue #263 把话说得很直:小说路线的说法带着一个数字,专业路线的没有。2026-09-14 上线的一篇预印本补上了一部分:268 个公司域名下的 2,250 篇 ChatGPT 之前的真人博客,对 11,250 篇来自五个前沿模型的 AI 镜像,214 个特征分 11 个维度、其中 187 个是结构特征,仅用结构特征就在留出公司上分到 98.0 macro-F1,让每个模型自己改写一遍之后是 98.1。它以SLOPSHAPE-2026进了账本,并带着自己的边界:特征是 LLM 打分的,实验从没测过人类编辑。 - 03
这套说法怎么被验,以及没人注意到的四天
技能声称的东西和仓库测到的东西之间有多大距离,仓库自己会讲。行为评测只有一例——
evals/deaify-release-note/,一份 1,160 字节的 prompt 加三个 grader,分别是 104、234 和 889 字节,问的是技能有没有触发、输出读起来像不像人、有没有残留 slop 标记——每次推送都通过claude plugin eval跑一遍。这条流水线红了四天,而那个失败长得什么都不像:从 2026-09-15 起连续七次运行(34980491671、35005656553、35107215014、35119480316、35368600325、35368661029、35368703581)在第一个用例之前就退出 1,因为 CLI 多了一道 runner 答不了的首跑信任提示。最后一次绿灯是 2026-09-11 的 34592097838。issue #259 把那七个 id 列了出来,并指出退出是立刻发生的,所以汇总那一步什么都没打印;#260 加上--trust-plugin,并在注释里写清这个标志断言了什么、没断言什么。其余检查这个仓库的东西几乎都是文本加 Python:两个校验器,v0.11.0 于 2026-09-18 发版时是 88 个测试,到 2026-09-20 是 94 个;一份 CodeRabbit 配置把auto_pause_after_reviewed_commits从 5 提到 20,因为在默认值下「审查暂停了」和「审查很慢」根本分不出来;以及真模型跑的 A/B 对照,README 把它记成项目的持续开销,而不是功能。 - 04
人设这一转:量出来的写法反而像一个格式
仓库里最锋利的一次反转,是发生在「声音」上的。issue #257 是以 RFC 开的,背后有证据:2026-09-16 到 09-18 的一次私下试点产出了十九份人设档,每一份都来自对某位写作者十到十五篇文章的通读,而不是来自指标,而十九份里每一份都至少要让一条现有规则让位。第二步交付了接口、模板和
scripts/check_persona.py;第三步没有信任接口,而是把它端到端跑了一遍,维护者的报告一边列出成立的部分——路线闸门、单独成块的 persona 成本、绝不退让的类别——一边列出五个缺口,其中一个是没有诚实取值的Consent:字段。第四步把第一份内置人设重写了两遍。同一份事实清单上跑五次之后事情定了:用句长占比、emoji 密度和k/n计数写出来的身体读起来像一个格式而不是一个人,而读者认得的输出,来自写作者自己那份散文式说明——它根本不含任何分布目标。v0.12.0 把这个结论带进了接口:模板变成散文优先、十五个固定小节加一个可选的范例小节,校验器改成要求盲测记录在Tested: untested下必须正好是none yet,而按上一版模板写的人设不再通过校验——这就是为什么一次 0.x 发版走了 minor 而不是补丁号。 - 05
别人送来了什么,以及这个项目不肯做什么
报告里有三十个 issue 与 pull request,最有意思的恰是项目没有收下的那些。issue #268 由一位贡献者提交,是一条跟项目自身利益相反的限制说明:sepia 的输出仍可能被检测器判成「混合」,因为它刻意不去优化 burstiness 和 perplexity——正是这类检测器最依赖的两个轴——也因为项目明确表示自己不是在规避检测器。同一位贡献者随后把那两个轴做成了可选技能;第一个 pull request 被关掉,换成一个标题、正文和分支名里都不提检测器的版本,理由是那种措辞会把仓库已经表明的立场倒过来。issue #267 是一封致谢,来自一位维护投稿用论文润色技能的人,边界写得很小心:只拿了那套框架,没拿文本、没拿规则文件、也没拿语料。issue #274 则是对一个已发布包的实测——装进去的
skills软链被压平之后,安装报成功却一个技能都没落地——而它的作者随后发了一条更正,撤回自己先前提的那个修法,理由是他后来给的替代方案才是准的。报告里最新的一条 issue #283 最不客气:一篇 2,900 字的中文科普随笔在路由表里掉进了通用文稿那一行,于是它真正的毛病所在的叙事审视与话语审视两趟,永远都不会跑。 - 06
一张靠逐页读厂商文档维持的指纹表
一份 19,021 字节的参考文件声称知道每个模型默认怎么写,而 pull request 记录了维持这个说法要付的代价。Claude Opus 5.5、GPT-6 Sol 与 GPT-6 Luna 出来的时候,#275 把三者都记成「已咨询、没有文风表述」,一条可执行的行都不给,把原有表格留作先验,因为它们的页面里没有任何关于默认长度、语域、排版或语气的话。#277 把 Gemini 那一行从一个厂商从没写过的上界,收回到页面真正支持的范围——Gemini 3 与 3.1 可执行,3.5 与 3.8 Flash 只当先验——依据是厂商 2026-09-17 更新过、维护者 2026-09-23 重读过的页面。#280 重读 Opus 5.5 那页,又找出两条关于写作的表述,于是把「只有三条」这个说法换成五条原文并列,旁边写清结论为什么仍然成立:五条里没有一条给出默认长度、语域、排版或语气。最新一条是拿厂商工具审自己的技能文本:#281 跑了 Anthropic 的
/claude-api prompt-audit——那份规格随 Claude Code 2.1.280 发布,与anthropics/skills里一个未合并的 pull request 在某次具名 head 上逐字节相同——应用了六处中等置信度的改写,路由、操作与规则一律不动。六处里有一处让引用点名 GPT-5、DeepSeek-V3 与 o3-mini,并承认没有任何 Claude 模型被测过。
相关档案
全部档案 →第 080 号
HarnessRouter
HarnessRouter 的自托管、Apache-2.0 版本:把十六种现成的 agent CLI——Codex、Claude Code、Hermes、DeepSeek Harness 以及另外十二种——放到同一个兼容 OpenAI Responses 的 API 后面,会话、流式进度、文件、取消与结构化失败都在里面;它实现的那套 Unified Harness Protocol,以及用来度量它的 conformance 套件,也一并放在这个仓库里。
第 070 号
OpenChatCut
一个本地优先的视频剪辑器,剪辑方式是跟它说话:内置 agent 与外部 Codex、Claude Code 会话调用的是界面自己在用的同一套剪辑工具,于是每一处改动都落在一条真实的多轨时间线上——是片段、转场、字幕、特效或音频,仍然能拖、能撤销、能导出。工程与素材留在本机,预览与最终渲染都出自 Remotion。
第 064 号
delegate-skills
一个技能包,给每一种编码 agent CLI 各配一份委派技能:编排方写好自足的任务书,另一条 CLI 去改真实工作树,而审查与提交留给人。