这是什么
一个把 Claude Code 或 Codex 变成口播视频动效工作室的 agent 技能,也是本档案里出自同一个账号的第三条记录。你给它一份口播稿和一条成品配音——任何 TTS 合成的声音,或者真人录音——它在本机把两者逐字对齐,默认后端是跑在 sherpa-onnx 上的 767 MB 语音模型,备选是免手动下载的识别后端;随后它把每个语义拍写进 SHOTBOOK 分镜,再用 108 张动效配方卡渲染成片。每张卡有三份产物:一份配方文档、一份除 React 与 Remotion 之外什么都不 import 的自包含组件,以及一份可直接在浏览器里跑、并带一张音效 cue 表的预览。一套靠减法定义的相机系统给每个场景只留一条极缓推或极缓拉,并把静止帧当作缺陷;一个浏览器工作台能把交付后的成片按七类轨道重新打开。许可是 PolyForm Noncommercial 1.0.0:个人、教育、研究用途免费,商业用途需事先授权,而你用它做出来的视频归你所有。1,318 个星、126 个 fork、约 30 MB,只有一次 release,而且那是一次媒体投放,不是版本号。
谁做的仓库挂在 GitHub 账号 Vincentwei1021 下——video-shotcraft 与 anything2explainer 也出自这个账号——README 的落款是 Vincent。仓库建于 2026-08-22,第一次提交在六天之后,也就是 2026-08-28。82 次提交里 79 次来自这个账号:44 次署 Vincentwei1021、用的是该账号的 noreply 邮箱,35 次署 Yihao、用的是 gmail 邮箱;余下三次各来自一位外部贡献者——leksautomate、ltppp、scpcn01vision-oss。其中 57 次带着共同作者尾注,49 条写的是 Claude 模型:Fable 5.1 三十三次、带百万 token 上下文的 Opus 5 十次、Fable 5 六次;另外八条写的是 Vincentwei1021 本人。
它是怎么搭起来的
组成 · 6一个 agent 技能,入口是一份方法文档,复用单位是一张卡。方法住在一份 62 KB 的 SKILL.md 和十三份参考文档里;卡被存了三遍——散文、确定性组件、以及作为视觉真值的预览——于是 agent 可以被指名用某张卡、读到它是干什么的、并抄下真实的参数,而不是自己发明。时间轴不是设计出来的,是量出来的:本机识别器把稿子贴合到交付的那条配音上,每个节拍都锚在某个字上,画面再在这些数字之上生长,这也是为什么管线在音频一侧是 Python、在画面一侧是 Node。渲染遵循同一套逻辑——成片按镜头切段、逐段渲染,音轨整条只渲一次——所以改一个镜头的代价是该段加它两侧的邻段,而每次拼装都有帧数断言看着。因为静止帧正是整套设计针对的失败,反幻灯片的规矩都被写成机器能查的东西:一个量帧间差的探针、一个识别重复源的签名检测、一个读人物素材帧率的检测器,以及一道在编辑器打开之前先读交付工程结构的 lint。工作台是外挂上去的,不是内建进去的,而且它借用成片自己的形状、而不是要求第二套:它经一层适配读工程,工程缺哪一份契约文件就只退回哪一个替身模块,而参数写回走的是渲染器读的同一份覆盖。
- SKILL.md 与 references/
- 面向 agent 的那一半:入口 62,221 字节,旁边十三份文档共 306 KB——
taxonomy.md(60,834)当卡片索引,design-language.md(28,256)、cinematography.md(22,231)、shot-design.md(20,533)、shotbook-example.md(16,020)、demo-spec.md(15,549)、review-protocol.md(13,996)、broll-sources.md(13,370)、layout.md(10,492)、host-footage.md(9,485)、schematic.md(8,527)、semantic-annotation.md(8,155),外加一份生成的cards-index.json(85,527 字节)。references/cards/里是 108 份配方文档,共 1,124 KB。 - template/
- 真正会被复制进片子的东西:108 份自包含组件共 961 KB;运动系统层 23 个文件 108 KB——
backdrop.tsx(18,449)带着十二款动态幕底,schematic.tsx(13,913)、transitions.tsx(10,783)、Subtitles.tsx(7,786)、longtake.tsx(7,075)、camera.tsx(4,452);以及六个共享组件共 42 KB,领头的theme-frame.tsx(16,338)就是那八式视频边框,它被刻意留在卡片库存之外。 - demos/ 与 gallery/
- 视觉真值加上它的橱窗:108 份单文件预览,共用一层 15,284 字节的外壳、一份 GSAP 与一份 Lottie、一张 37,222 字节的音效 cue 表和 1.76 MB 的 base64 采样,另有约 5 MB 注明来源的示意素材与图片。画廊是一个 2.87 MB 的单页,配 16 MB 的 109 张缩略图和 1,236 KB 的 108 份英文卡文,由一个 2,272 字节的工作流发布到 GitHub Pages。
- scripts/
- 各种闸门,32 个文件共 342 KB:
preflight.py(45,891)是全仓库最大的脚本,其后是voice_trim.py(38,565)、render_shots.mjs(24,378)、semantic_annotate.py(21,539)、timestamps_cpu.py(19,710)、pipeline_state.mjs(17,727)、tts_fishaudio.py(16,252)、workbench_contract_lint.py(14,531)、card_match.py(13,016)、cards_index.py(12,107)、motion_check.py(11,121)、freeze_probe.py(8,570)与face_bbox.py(4,595),旁边还放着两个测试文件。 - workbench/
- 一个浏览器编辑器,192 个源文件共 1,200 KB:12,601 字节的应用外壳、10,834 字节的 store、19,195 字节的成片导入路径、21,269 字节、同时提供实时看板的 Vite 配置、23,854 字节的样式、一条时间轨、若干面板、一个预览、十五个替身契约模块,以及一套 19,972 字节的回归测试。它的图文指南(17,730)与说明(16,936)旁边,
docs/下十六个文件——一份实时看板文档加十五张截图——再加 1,653 KB。 - runtime/ 与 .github/
- 所有片子共用一套依赖,七个文件共 198 KB:186,728 字节的 lockfile、一份 4,207 字节的体检脚本(装依赖、升级并冒烟渲一帧,不过就回滚)、一份 4,051 字节的链接脚本,以及一份 5,723 字节的 Python 测试。一个 2,272 字节的工作流负责发布画廊;
LICENSE(4,895)与THIRD_PARTY_NOTICES.md(4,274)分别写着代码与内嵌采样的条款。
取舍,以及它替代了什么
预览是视觉真值,组件必须与它一致 替代 先写组件,再让预览去追它
项目开工当天定版的
references/demo-spec.md里就这么写:预览是视觉真值,改动它的时序或画面就必须同步改组件——这也正是音效 cue 表遵循的同一条纪律,改了预览时序却不改 cue,在这里被当作缺陷。卡片蒙皮中性化,除了那张卡演的是真实产品界面 替代 对所有卡用同一种中性处理
2026-08-23 的视觉基准要求白舞台、不要装饰性渐变/网格/噪点/暗角,这样一张卡才能被带进任何风格。2026-08-25 的例外更有意思:当卡演的是某个产品的界面,那层皮就是内容本身,于是配色、圆角、间距与标识照抄,可改的只有文案——否则它不再读作那个产品,卡存在的理由也没了。2026-09-05 片场一侧补上了配套规则:从稿子的领域推出风格档,并逐镜写一行蒙皮。
在实测静音处切开识别输入 替代 想办法让模型一口吞下更长的音频
崩的地方在编码器里那张定长的相对位置编码表,所以这个上限没法靠论证绕过去。修法是在 20 到 75 秒的窗口里挑最长静音的中点下刀,再把每段的偏移加回时间戳;改动拿同一段 193 秒录音做单变量验证:token 数同样是 975,98.6% 可配,起点差中位 10 毫秒,耗时与峰值内存从 54 秒、8.6 GB 变成 34 秒、2.4 GB。
只做一镜就问一次,而不是做完整片再给用户看 替代 把十三个镜头全部实现完再展示结果
确认点原本落在整片实现之后,于是只要是样板级的问题——蒙皮、字幕、相机幅度——就得回头返工全片。现在先把骨架搭全、其余镜头用替身占位,只渲一镜、并用只属于它那一段的音频出预览,然后停下来只问一次:测试工程里一条 6.22 秒的首镜花了 47 秒,与之相对的是返工整片的代价。
先给稿子逐句标注,再去查卡库 替代 只按一个镜头里有哪些材料来筛卡
漏斗只有一道过滤,而从来没有人记下每句话在做什么,于是一句自我介绍配到了全库能量最低的文字卡,而一张自家说明里写着「也用于自我介绍」的卡闲着没人用;三份独立评审还都放过了那一镜,因为评分表核的是摆上去的对不对,不是该摆的在不在。解法是一份逐句标注文件——封闭词表、主句/从句权重、这句话需要的实体——外加一个匹配器,它给出排序后的候选,也同样给出其余候选被否掉的理由。
轮换镜头的呈现方式,而不是给它加运动 替代 继续用那条碰巧管用的版式
这条规则来自一支十一镜的片子,其中八镜用了同一个分屏、同一枚圆章、同一列文字。如今单条素材的呈现要在七式之间轮换,相邻两镜不得同式,同一式不得超过全片三分之一;规则旁边那句注脚说,轮换是换构图而不是加运动——七式里每一式仍然只有那一条极缓推。
依据README.md(12,055 字符;侦察报告里印了前 6,000 个,其余于 2026-10-01 取自默认分支)、报告中全文印出的两份架构文档——references/demo-spec.md(8,104 字符)与 references/shot-design.md(10,225 字符)——完整的 928 个文件树及其体积与两级目录汇总,以及上文提到的各条 pull request 与 issue 正文,主要是 14、16 至 22、26 至 31、33 至 36、39 至 42。
制作过程
6 个阶段- 01
三条记录、一个账号,以及三件不同的东西在决定画面
本档案里现在有三条记录出自
Vincentwei1021这个账号。video-shotcraft 建于 2026-07-19,做的是产品宣传片,重心是 157 张镜头配方卡,外加一轮覆盖 149 个音效和五首垫底曲的声音设计。anything2explainer 建于 2026-09-08,从主题或文档出发,交付一支 1280×720 的解说片,且旁白在任何一个镜头动工之前就已经冻结成帧号;它没有卡片目录,也没有音效库。video-talkcraft 建在这两者之间,2026-08-22,从一条已经存在的配音出发,并把那条声音当作时钟。资产因此各不相同:shotcraft 的运动是从十二支具名的产品片里读出来、进门时已经去掉品牌的;anything2explainer 用代码画自己的图解;这一条收下口播稿、录音,以及可选的人物素材、B-roll 或截图——而它自己的卡库有一部分正是从 shotcraft 长出来的:2026-09-05 的第八批把那边 19 张产品片镜头卡翻译成本库的契约,库存从 89 变成 108。机器也在三者之间流动:本仓库的浏览器工作台被搬到了 video-shotcraft,那边的记录写着它于 2026-09-04 到达;三者还共用同一个runtime/目录里的依赖。许可证不一样,而且同时用其中两个库的用户把话说明白了——shotcraft 是 Apache-2.0,没有协议问题;这一条是 PolyForm Noncommercial,于是他正式写信申请商用条件。 - 02
二十六天、八十二次提交,和一个不是版本号的 release
仓库建于 2026-08-22,第一次提交在六天之后到达,也就是 2026-08-28,用短短一行把整个想法说了出来。八月落了六次提交,九月落了 76 次,82 次里的最后一次在 2026-09-22,是 pull request 42 的合并。唯一那个 release 叫
gallery-media,日期是 2026-08-28——和第一次提交同一天——打的是画廊里的动效预览,不是版本;标签列表里也只有这一个名字,整个项目从来没有版本号,对一个在一个月内就交出浏览器工作台和共享 runtime 的仓库来说,这不太寻常。周围是 1,318 个星、126 个 fork、两个 watcher、一个未关条目,仓库约 30 MB,而 GitHub 报的语言是 HTML,因为那座画廊是一个 2.87 MB 的单页。issue 与 pull request 的编号从 14 排到 43,其中 30 条留了档:对这么年轻的项目来说,队列本身就是项目,因为几乎每条改动都先写清哪里错了,再写改了什么。外部反响以两种形式到来,而不是以报道的形式。一家商业 agent 工作空间的团队装上了这个 skill,把一场会议的纪要做成了分镜、节拍与配音时序数据,并把交付物连同报告一起公开;另有一位同时用着这位作者两个库的开发者,正式写信询问能否为小微商家做片的商用授权,得到的回复是一个邮箱地址。 - 03
配音就是时钟,而这只时钟跑在你自己机器上
字级对齐是 README 里的第一条卖点,也是整件事里最不显眼的一段活。
scripts/timestamps_cpu.py默认用跑在 sherpa-onnx 上的 FireRedASR2-CTC int8 模型把口播稿贴合到音频——这个模型 767 MB,只需下载一次——备选是 faster-whisper,适合不想手动下载任何东西的人。README 给出的实测数字是:一段 110 秒的中英混合口播,对着 GPU 强制对齐器比,字级偏差中位 20 到 40 毫秒、最差 200 毫秒,且自家质检零误报,于是每个动效节拍都能钉在确切的字上。材料把上限记得比成绩更清楚。一段 193 秒的口播跑完用了 54 秒、峰值内存 8.6 GB;而 210、225、240、317 秒的输入全部崩在编码器里的同一处,因为那里的相对位置编码表是定长的,且内存随长度平方增长。修法是在实测静音处切段,切点落在 20 到 75 秒的窗口内,再把每段的偏移加回时间戳。拿同一段 193 秒录音做单变量复测:按 75 秒切段后 token 数同样是 975,其中 98.6% 可配,起点差中位 10 毫秒、最差 150 毫秒——约 3% 的 token 超过一帧——而耗时与峰值内存从 54 秒、8.6 GB 降到 34 秒、2.4 GB。2026-09-10 加进来的一步排在这之前:scripts/voice_trim.py从真人录音里剪掉口水词、结巴、重说和过长停顿,并输出一份编辑单,可以用同一份编辑单去剪同录的人物视频,音画逐帧同长。它的判定写的是「宁漏勿错」——稿子是真相,所以只有稿子里没有的插入段才成为候选,而识别器听错的稿内字永不剪。唯一的云端路径是可选加入的:2026-09-15 一条社区 pull request 接进了一个免费的流式语音服务,一次请求同时返回音频与字级时间戳;维护者把它作为贡献者本人的提交合入,后面跟两条独立修复,并以 25 项离线测试验证,其中包含 ffmpeg 输出检查。 - 04
一百零八张卡、每张三份产物,以及一次对着代码做的审计
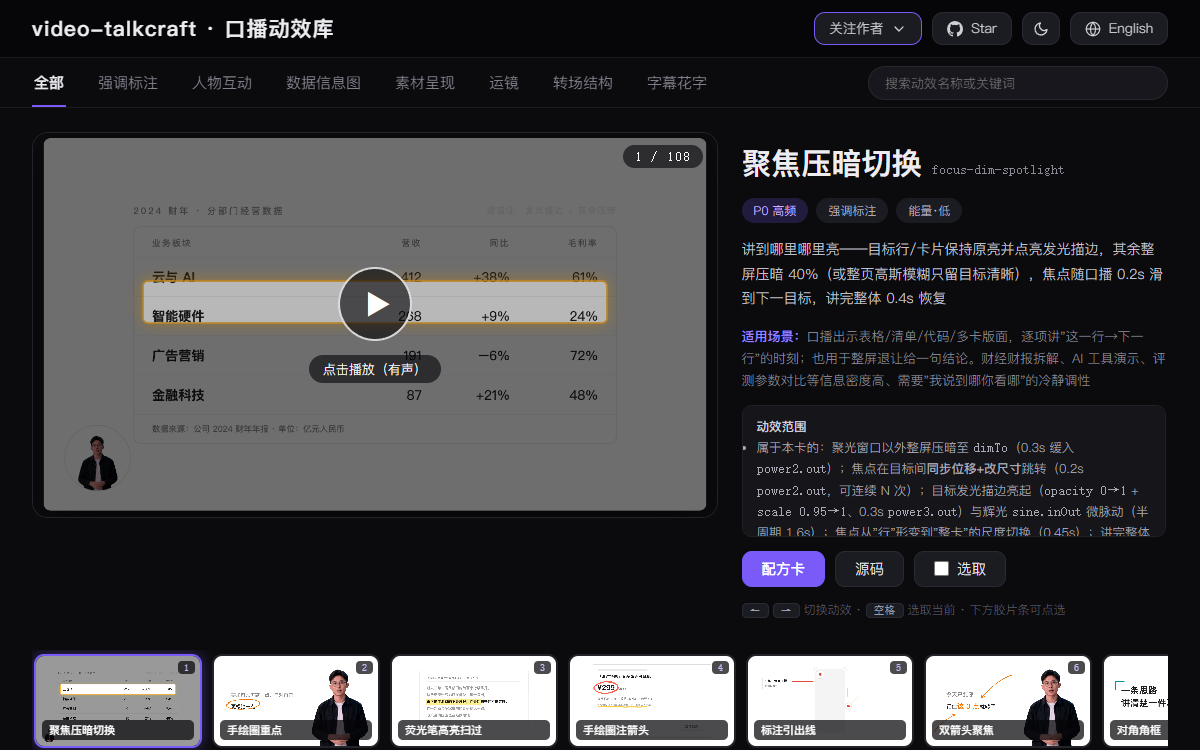
卡库是重心,而且每个动效都被存了三遍。每一张都有一份配方文档放在
references/cards/下,一份自包含组件放在template/cards/下——除 React 与 Remotion 之外什么都不 import,并导出一块写着宽、高、帧率与时长的元数据——还有一份能直接打开的 HTML 预览放在demos/下;规则写得很明白:预览是视觉真值,组件必须与它逐帧一致,改了一边就必须改另一边。第四份产物更小、也更容易被忽略:每张卡一张音效 cue 表,以预览秒计,音色从十三种里选,其中十种是从姊妹库的 Mixkit 库搬来、以 base64 内嵌在本仓库里的真实采样。2026-08-26 的全库重配把 cue 总数从 439 压到 269,音量上限压到 0.65,把收尾叮当与重砸从全库清零,还故意给两张循环卡留了空 cue 表;从 2026-08-27 起这些 cue 还会跟着进片,选中一张卡,它的音效就一起上。数量本身在仓库里有两个答案:账号页上的项目简介写的是 109 张动效配方卡,而 README 横幅、配方目录、组件目录说的都是 108——108 份配方文档、108 份组件、108 份预览,缩略图却有 109 张,因为其中一张属于那个视频边框组件,而不是某张卡。这里最有教益的改动是一次审计而不是一次新增。2026-09-21,九个子代理把每一份配方文档与实现它的组件逐张对照——仓库把组件当作真值——结果是准确 29、有小偏差 66、不准确 13:十张卡声称吃它们代码从未读取的素材,三张归错了输入类型,能量档从五个标签归一成三个,还有若干节奏数字在动效定版之后没有回写。动的只有文档。第二天,用户找出了更深一层的毛病:选卡漏斗只有一道过滤,看的是一个镜头里有哪些材料,而从来没有人写下稿子里的每句话在做什么,于是一句自我介绍配到了全库能量最低的文字卡,而一张「也用于自我介绍」写在自家说明里的人名条卡就摆在货架上。三份独立评审都放过了那一镜,因为评分表核的是「摆上去的对不对」,不核「该摆的在不在」。 - 05
一套靠减法定义的「反幻灯片」系统
项目简介里管它叫反幻灯片运镜系统,而它实际上是一串禁令。每个场景只给一条连续的相机曲线,且只允许两种——从 1.00 极缓推到 1.04 至 1.06 之间,或者极缓拉——而 2026-09-04 之后,环境呼吸、idle 微动与曝光脉冲全部默认关闭,理由是画面该靠那一条曲线和它自己的内容活着,而不是靠装饰。静止帧被当作本该结构性地不可能出现的缺陷,而仓库并不指望这一点自动成立:
scripts/freeze_probe.py每镜渲三个点,把相隔 0.8 秒的两帧拿编码器同款的帧间绝对差判据比对,低于标定阈值就判为静止候选,在 45 个采样点上与成片母版一致率 98%,而 90 张静帧的普查只要约两分钟。纪律的另一半是变化,而它是从一条投诉里学来的。一支十一镜的片子交回来,其中八镜都是同一个 60/40 分屏、左下圆章、右侧文字,规则于是改成:单条 B-roll 的呈现必须七式轮换,相邻两镜不得同式,同一式在全片占比不得超过三分之一;规则旁边那句注脚说,轮换是换构图,不是加运动——七式里每一式仍然只有那一条极缓推。纯文字镜也不再允许裸放:它配一张由图标、方框和箭头组成的线稿示意图,图从这句话推出来,缺了会被检查报 WARN。单一视频的镜头必须包进八式边框之一——复古浏览器窗、杂志相框、带齿孔的 35mm 胶片、拍立得、工程图纸——一片一式,而且绝不做假播放器,因为最初那版就是播放器,得到的定论是不要进度条、不要播放键。网页是被「拍」而不是被贴上去的:长截图在被滚动、巡游、放大或标注的时候,相机保持不动;录屏被直接否掉,理由是 Remotion 在静帧上工作既 seek 安全、又能对词下锚,而录屏帧率不稳,还会在懒加载和粘性头上穿帮。 - 06
机器闸抓住了什么,以及一位用户的账单抓住了什么
这套检查机制诞生于糟糕的一周,而且对自己的来历记得异常具体。一支口播片做了 7 小时 21 分钟,产出六个整片母版、废掉五个,还蒸发了三次评审;其中最严重的两个坑——25fps 的人物素材混进 30fps 的成片、空的 B-roll 目录一路走到交付——其实早就写在文档里了,所以结论不是文档缺失,而是文档没有在对的时刻被读。于是
scripts/preflight.py把入场硬规变成开工前必跑的断言:逐条核对人物素材的帧率、宽高比与时长是否与成片一致,查找能暴露源片不匹配的重复帧签名,并要求分镜里每一镜的素材行都指向一个真实存在的文件,对一支完全没有 B-roll 或图片的片子直接判 FAIL。交付由三道闸看着——画面上的静止段与并发光栅抖动检测、纯音效轨的逐 cue 能量检查、以及一轮针对锚点帧与静帧拼图的独立评审——之后修完 P0 与 P1 即交付。工序的顺序也出于同一个理由改了:不再把十三个镜头全部实现完再给用户看,而是先把骨架搭全、其余镜头用替身占位,只渲一镜并用只属于它自己那一段的音频出预览,然后只问一次——测试工程里一条 6.22 秒的首镜花了 47 秒,与之相对的是返工整片的代价。一块实时看板按盘上文件推导每一镜的状态,而不是按 agent 的记忆,于是过期的镜头会显示为过期。队列里最锋利的一条至今没关:一位用户报告,一个晚上九次整片直渲产出约 2.5 GB、烧掉约 10000 积分,折合约 150 元人民币;事后调查的结论是渲染本身不要钱,因为它跑在本地——真正花钱的是驱动它的那个循环,每一次导出都是又一轮 agent 轮次,而长会话会把整段上下文重新付一遍,那九次里有九次都绕开了 skill 里写好的迭代纪律。作者给出的解法走向另一边:先做一镜,问一次,再往下做。
相关档案
全部档案 →第 083 号
video-shotcraft
一个把 Claude Code 或 Codex 变成动态设计工作室的 agent 技能:157 张写着真实缓动与时间参数的镜头配方卡、214 段动效预览、一支验证过的 36.2 秒模板片、149 个按场景归档的音效,以及一个把交付后的成片重新打开供人修改的浏览器工作台。
第 128 号
anything2explainer
一个把主题——或者一份文件——变成 1280×720 旁白解说片的技能,跑在 Claude Code 或 Codex 里。agent 先带着来源做调研、写解说词、生成配音和词边界时间轴,再逐镜头做分镜,然后派出一批并行构建 agent,每个 agent 写一个 Remotion 组件,所以画面是代码画出来的,不是模型生成的。它与同一作者的 video-shotcraft 不是同一种片子:那一条用 157 张镜头卡加一轮声音设计做产品宣传片,这一条的主干是旁白,不带镜头卡库、不带音效也不带配乐,并且在任何镜头动手之前就把解说词冻成了帧号。
第 119 号
headcount
一个按公司组织的 agent 组织——一位首席执行官之下是十六个可独立安装的部门和 172 个技能:每个技能是一个 Markdown 目录,请求与它的描述匹配时自己加载;同一棵树既能装进 Claude Code,也能装进 ChatGPT,因为两边只有清单不同;而那 184 份真正裁决问题、而不是给答案做装饰的外部权威——监管机构、标准组织、成文法——就放在它们所服务的技能旁边,每一条都标着 agent 拿它可以做什么。