这是什么
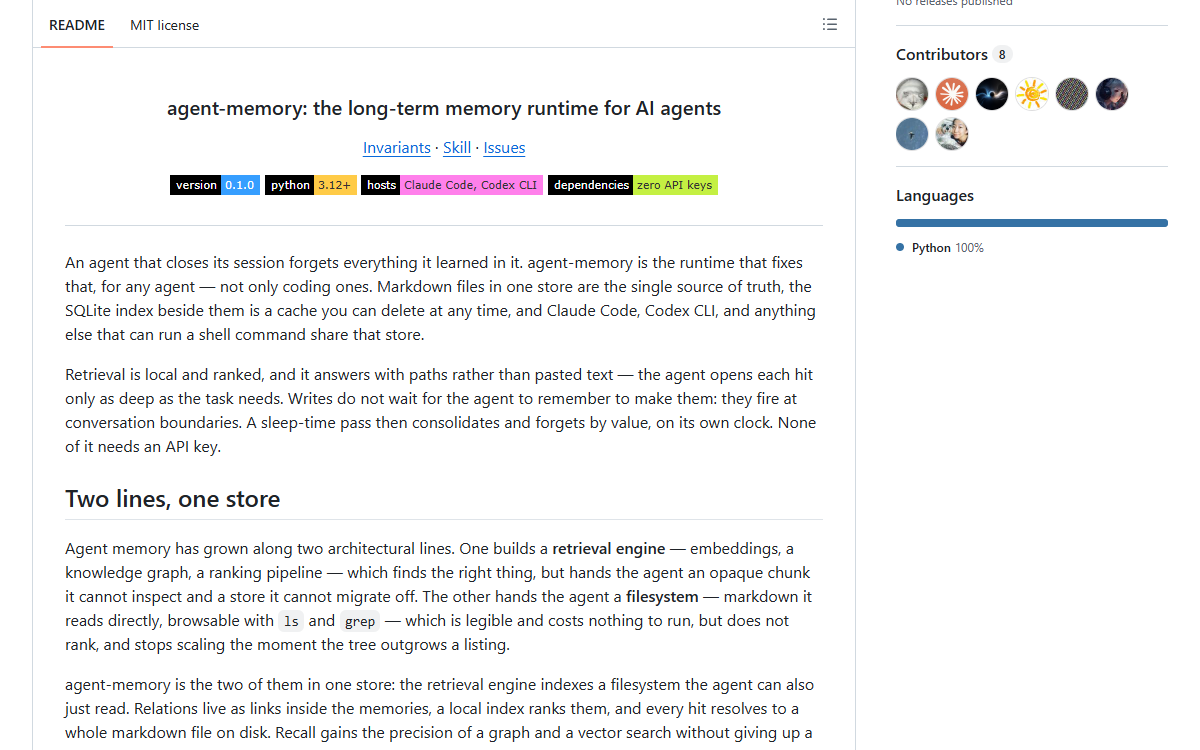
一个给 AI agent 用的长期记忆运行时,知识存放在普通的 Markdown 文件里,旁边的每一个索引都被当作随时可以丢掉的缓存:rm -rf .index/ && mem rebuild 一个字都不该丢,这一点由测试来保证。一条记忆就是一个文件,frontmatter 里带着稳定的名字、一句话摘要、类型及其 schema 字段、时间戳、链接、权重与出处,有效期取代了状态字段,于是被替换掉的文件仍留在存储里,recall --as-of 还能回答到那个时间点。检索在本地排序——默认走 FTS5 上的 BM25,可选的向量索引用倒数排名融合进来——而且它返回路径而不是粘贴正文:召回先给一行清单,agent 只把命中的东西打开到任务需要的深度。写入在对话边界触发,不等 agent 想起来;蒸馏之前先把完整记录复制一份;独立的睡眠期管理层按自己的时钟整理,把删除留成提案。Claude Code、Codex CLI 与 Hermes 共用一份存储,整条链路不需要 API key。
谁做的这是一个组织账号,不是个人:仓库的 MIT 版权署名 Tigerless Labs,154 次提交由八个账号在 2026-09-01 到 2026-09-28 之间写完。历史被其中一位成员主导——liruihan000 这一个账号就占了 103 次,用了三个不同邮箱和两个显示名提交——faj-design5260 占 33 次,importcpp 占 7 次,其余五个账号各一到两次。154 次提交里有 90 次带共同作者尾注,而每一条尾注写的都是 Claude 模型:Opus 5 占 59 条,Fable 5.1 占 28 条,Opus 5.5 两条,Fable 5 一条。
它是怎么搭起来的
组成 · 6一个刻意分成三层、并且允许各自独立失效的运行时:Markdown 文件是真相,其上是本地排序的索引,再旁边是按自己时钟走的睡眠期管理层。塑造其余一切的那个后果是「索引是可丢弃的」——整个架构按「rm -rf .index/ && mem rebuild 一个字都不丢」来建,并且由测试来保证而不是写在文档里承诺——以及「一条记忆是带有效期的文件,不是带状态的行」。写入只有一条路径,agent 的写入与管理层的改写走同一条 validate、hash-diff、reindex 管线;读永远不改真相:使用统计进访问日志,权重由管理层批量落回 frontmatter。检索把三种传统放进同一个存储——关系是记忆内部的 links,本地 FTS5/BM25 索引外加可选的向量插件,以及 agent 仍然能走的普通目录树——所以一条轨道漏了不等于漏掉。库核心里没有模型客户端,判断力是从宿主 agent 自己的命令行借来的,这让核心不联网也能测,也让每一次写入都显示在用户自己正在看的记录里。它之上是六个包,附带一条不变量:适配器不携带任何算法,于是同一个请求走任何入口都得到同一个结果。
- packages/core/ —— 44 个文件、212 KB
- 真相层与检索层。
store.py(27.6 KB)是唯一的写入路径;manage.py(31 KB)与prompts.py(17 KB)是睡眠期那一层及其推理用的提示词;reconcile.py、schema.py、frontmatter.py、placement.py、record.py、migrate.py构成记忆模型;recall.py、indexer.py、search_index.py、vector_index.py、chunking.py、embeddings.py负责排序;其余机关在ledger.py、archive.py、distill.py、reasoning.py、sessions.py、trace.py、observation.py、locking.py、watermark.py里。 - packages/cli/、packages/mcp/、packages/adapters/
- 三个入口,最终都塌缩成同一批核心调用:22.6 KB 的命令行入口;一个 MCP 服务,工具模块 10.6 KB、对外暴露九个记忆工具;以及宿主适配器——6.1 KB 的钩子入口,加上 setup、capture、moments、transcript。不变量是适配器不带算法,所以任何入口来的同一个请求都得到同一个结果。
- packages/executor/
- 唯一会调用模型的地方,被刻意挡在库核心之外:宿主方言、推理器、蒸馏器与凭据处理,默认借正在触发的宿主自己的命令行,也可以指向配置好的端点。全新安装那次修复改的正是这里的默认值——从组织内部的托管默认改成宿主本身。
- packages/harness/ —— 17 个文件、86 KB
- 测量装置:25.5 KB 的考试驱动、裁判与宿主系统模块、一个基准载入器,以及 dataset、metrics、report、coverage、interop、framing、sampling。正是它把「关于召回与写入策略的说法」变成固定宿主与裁判配对的实验组记录。
- tests/ —— 33 个单元测试文件、11 个系统测试文件
- 205 KB 的单元测试加 93 KB 的系统测试,外加一个 6 KB 的记忆投毒 red-team 文件和 tools 目录下的读暴露闸门。系统测试覆盖入口等价、并发、固定考试、宿主之间的互操作,以及管理入口。
- docs/ 与 skills/
- 四份设计文档(管理操作边界、批量写入边界、原始证据读取,以及一个索引),八份共 18 KB 的计划文档,根目录上一份 8.9 KB 的架构文档,一份给 agent 看的 4.7 KB skill,以及一个 510 字节、跑测试、lint 与类型检查的持续集成工作流。
取舍,以及它替代了什么
用 Markdown 文件当真相,所有索引都当缓存 替代 一种以数据库为主形态的存储
理由写在仓库里:迁移自由、可以进 git、与宿主自带的自动记忆兼容、用户对自己的知识有主权。它不是口头承诺,而是由测试保证——从文件重建索引不许丢任何知识。
给文件一个有效期,而不是存一个状态字段 替代 带第三种状态的 status 字段
一个文件要么有效要么失效,中间没有别的;失效只来自被替换或被删除。仓库的说法是:一个不改变任何事的状态是假话,而一个文件内部局部过期会毒掉整个文件。被替换与被删除的文件留在存储里供
recall --as-of与 trace 使用,旧文件里遗留的 status 也仍然能加载。从宿主 agent 自己的命令行借判断力 替代 在库里自带一个 LLM 客户端
不用装任何 key、没有账单面,所有宿主共用一条抽取管线,核心不联网也能测;附带的好处是每一次蒸馏与改写都出现在用户本来就在看的记录里。
向量检索保持可选、默认关闭 替代 把向量索引当成默认检索路径
先测再定:可选融合在固定的 120 条查询集上把 Recall@5 从 79.0% 提到 86.6%,但检索延迟中位数从 5.1 毫秒涨到 139.2 毫秒;答案层面的重放是 17/24 对 18/24、28/36 对 27/36——答案层面的实验没能证明端到端更准,于是 BM25 继续当低延迟基线。
无人值守的一趟可以新增与更新,但只能提删除提案 替代 给整理过程删除权限
记忆投毒被当作长期存在的攻击面;在没有人盯着的情况下,仓库点名可逆、限速与审计才是让无人值守变安全的东西:只讲规则的部分直接生效,执行器部分只提提案,每一类在单次睡眠里有上限,一次睡眠一次提交,而物理删除是一条人工命令,管理层够不到。
依据CLAUDE.md(8,884 字符)、README.md(14,855 字符)、skills/agent-memory/SKILL.md、docs/design/management-operation-boundaries.md、docs/design/batch-write-boundaries.md、docs/design/raw-evidence-reads.md、docs/plans/ 下八份计划文档、各 issue 与 pull request 的正文及评论串、.github/workflows/ci.yml(510 字节),以及完整的 149 个文件树及其体积。
制作过程
6 个阶段- 01
二十九天,154 次提交,零个 release
仓库建于 2026-09-01,而它最早的那次提交——日志时间只早四秒——标题是「Scaffold repo: CLAUDE.md, design tree, roadmap v0.1」:先写不变量与计划树,再写代码。154 次提交全部落在那个九月里,最新的一次是 2026-09-28 合并第 46 号 pull request,最后一次 push 记在 2026-09-30。仓库里没有任何 release,也没有任何 tag,README 明说还没有发布到 PyPI,只能从检出安装;版本徽章至今写着 0.1.0。这一个月换来的是关注度——1,974 个星、124 个 fork、66 个 watcher、元数据里十个开放的 issue,以及包括 local-first、mcp、sqlite 在内的十二个 topic——还有一波集中修门面的工作:第 21 到第 25 号 pull request 全部落在 2026-09-08,而且全是 README 与许可证。其中一条补上安装章节,原因是发现
mem setup会把一条裸mem-hook命令写进宿主配置,而uv sync只把这个可执行文件放进虚拟环境,于是在虚拟环境之外启动的会话什么也没记录。另一条把首页重新围绕检索设计来写,并删掉了指向已被移进忽略文件的目录的那些链接。再一条用一个三行的例子展示读路径,代价是砍掉一节「别处已经说过」的内容。许可证那条记下当时的仓库已经公开却没有许可证文件——这在法律上等于「保留所有权利」——于是补上 MIT、版权署名 2026 Tigerless Labs,写进根目录和六个包的清单里。 - 02
文件是原子,索引是可以扔掉的
设计规则写在
CLAUDE.md里,作为「改动不得破坏」的不变量:Markdown 是唯一真相,所有索引都是可重建的缓存;agent 的写入与睡眠期的改写共用同一条 validate → hash-diff → reindex 管线;读永远不修改真相文件,所以使用统计只写进索引的访问日志,权重由管理层批量落回 frontmatter;原始材料只追加,蒸馏是投影而不是搬移;库核心里没有 LLM 客户端;管理层永不销毁信息;文件边界就是失效的原子单位;而读路径在一次写入实验里要保持固定,因为一个研究「怎么写」的实验,只有在「怎么读」完全相同的前提下才能把差异归给写入那一半。一条记忆就是一个文件:frontmatter 里放着名字、一句话摘要、类型及其 schema 字段、时间戳、链接、权重与出处,正文是自由 Markdown,有效期由valid_from与可选的invalid_at表示,取代了原来的 status 字段。存储里放MEMORY.md(被称作「唯一常驻注入」)、一份在加载时拒绝未知旋钮的配置文件、每种类型一个 schema、位于<type>/<group>/<name>.md的记忆本体、两个只追加的归档目录(放出处与完整会话记录)、每次睡眠一份 dream report、一个可重建的索引,以及保存蒸馏水位与写锁的状态目录。第 40 号 pull request 把读与管理两半放在一起简化:深层的原始检索路径、它的索引、配置键与适配器参数被整体删除,limit成为扩大召回候选的唯一方式。 - 03
召回返回路径,以及这条排序背后的几场修补
召回不会把正文粘进上下文。它返回一份 L0 清单——一行摘要、文件路径、锚点、分数,默认八条——agent 再按任务需要把命中项打开到相应深度:
mem read <name> --level outline,或者 abstract,或者 full,mem context一次做完两件事,mem trace则去取被引用的原始消息。每一级比上一级贵一个数量级,而长文件还白送两级:命中的那个锚点,以及读的时候现算出来的大纲。背后有三条读轨:会话开始时确定性地注入MEMORY.md;FTS5 索引上的 BM25,可以再把向量插件用倒数排名融合进来;以及两样都失灵时仍然可以用ls和grep走的目录树。pull request 里的争执都围绕「候选集到底指什么」。有一处把作用域改成按完整路径分段匹配,因为user这个作用域原本会匹配到username/settings.md;同一个修复别人在六天前已经提交并先合了。另一处把作用域过滤挪到候选池上限之前——此前召回先取全局前若干条再丢掉超出作用域的,于是很窄的作用域明明有命中也可能返回空。向量召回是作为可选插件加进来的——装一个 extra、打开开关,默认模型BAAI/bge-small-en-v1.5,SQLite 上做精确余弦——在固定的 120 条查询集上把 Recall@5 从 79.0% 提到 86.6%,而检索延迟中位数从 5.1 毫秒涨到 139.2 毫秒,固定上下文的答案重放是 17/24 对 18/24,所以它默认是关的。 - 04
睡眠期那一层被允许做什么
管理层被描述成一个按自己时钟走的独立层,并且有权限分级。T0 只讲规则——日期、权重、链接、目录——直接生效;T1 由库自己的执行器裁决,只允许新建文件或把旧文件标为失效,动手方式是提一份提案。每一类操作在单次睡眠里有上限,一次睡眠对应一次 git 提交,于是无人值守的一趟影响面是有界的。dream report 记录这一趟动了什么、提了什么、证据指针在哪;决定账本存裁决,仓库给的理由是账本是真相而不是缓存,因为丢掉一条否决就等于操作者的拒绝被遗忘,同一个提案下次睡眠还会回来。第 36 号 pull request 发现账本追加是一段没有加锁的「读—改—写」,两个并发追加者各自只会写回自己那一条,于是把它放进存储锁内,新内容先落到同级的 pending 文件再原子替换。删除只会以提案形式出现,由
mem decide确认;物理删除是一条人工命令,管理层碰不到。仓库把可逆、限速与审计列为「无人值守也能安全跑」的原因,因为记忆投毒被当作长期存在的攻击面——测试里就有一个专门放投毒样本的 red-team 文件。这一层的分量写在代码里:manage.py31 KB、prompts.py17 KB,是 212 KB 的 core 包里最大的两个文件。 - 05
一个什么都没记下来的全新安装,和三分钟里的 340 个会话
仓库里写得最好的一条 pull request,修的是做 demo 时撞见的四个缺陷,每一个都先有一条会失败的测试。全新安装之后,没有任何对话变成记忆,新会话也召回不到东西:钩子启动的是
mem distill --store …,而存储参数是顶层参数,解析器直接拒绝并把这个错误丢掉了。默认的推理执行器指向组织内部的私有项目,组织之外的人什么都拿不到;默认值改成了正在触发的宿主自己的命令行。可那位宿主的claude -p又会触发同一批生命周期钩子,于是蒸馏递归起来——pull request 里记下实测到的数字是三分钟约 340 个会话——现在执行器的运行会被打上环境变量标记,钩子在那下面会让开。另一条讲模型重复自己刚被告知的键:宿主推理器在 schema 字段旁边又加了一个group,值就是那个字段的复述,存储以「未知字段」拒绝,修复轮又把同样的错误重复一遍,整段对话就卡在 pending 里;现在调和阶段会把这种复述丢掉。另外两条展示了两种不同的证据。有个 issue 断言纯非 ASCII 摘要会互相覆盖到域根下一个名为.md的文件上,针对它写的 pull request 反而否掉了这个说法:路径还没构造出来就已经抛错,所以既没建文件也没覆盖,剩下的真实缺陷是 slug 折叠成空。还有一条发现「只讲规则」那一层的词集指纹对非 ASCII 文本一个词都贡献不出来,于是一趟睡眠可能让不相关的中文记忆失效;替代方案是对解析后的文本、类型、语义字段、有效期起点、作者、链接与出处做精确身份判定。 - 06
外部修复集中到货的那一个月
档案里读了三十个 issue 与 pull request,编号从 21 到 50,其中七个仍然开着。Windows 支持来自一个外部账号:
core/locking.py在模块层就 import 了fcntl,于是每一个入口——mem、mem-hook、mem-mcp——在干任何事之前就死于导入错误;修法是按平台分支,用 Windows 的加锁调用锁住位置零的那一个字节,并捕获那个调用抛出的普通系统错误而不是更窄的子类。另一位外部贡献者送来一对关于并发的改动:一次更正先无锁读记录、再在第二把独立的锁下写回,于是并发写入者的编辑与出处可能无声地丢失,删除路径也是同样的形状。第三位在同一分钟内提了一个 issue 和一条 pull request,讲 frontmatter 不能往返:双引号值从来没有被反转义,于是每次重写都多一个反斜杠;而true、null、42、1e3这类字符串被不加引号地写出去,读回来就变成了别的类型。同一个缺陷在三周内落到两个人手上,其中一位发现对方的 pull request 已经合掉了自己写的修复,于是关掉自己那条,并把覆盖了边界情形的测试记在对方名下。测试套件跟着这个节奏长:2026-09-10 是 388 个通过的测试、90.91% 覆盖率,下一周一次重新验证是 426 个,到 2026-09-23 已经是 544 个,并且 lint 与类型检查在 69 个源文件上全绿。
相关档案
全部档案 →第 073 号
Engram
一条把「学一门东西」做成流水线的办法:课程架构师拆出第一性原理的概念图,一名看不见讲课过程的评分者盲评你写下的原话。再由 FSRS 排程,每次判分都在磁盘上留下一条收据。
第 055 号
LeanCTX
一层贴在编码 agent 旁边、决定什么内容能到模型眼前的本地软件:文件读取会被压缩并缓存,命令输出按每条命令各自的规则压缩,会话里的发现跨对话留存,本地代理重写每一个请求同时不弄坏服务商的 prompt cache——还有一本节省账、一份预算和一块仪表盘,报告它究竟量到了什么。
第 113 号
Lemmalog
一个用 Rust 写的 Datalog 引擎,它把 agent 记忆当成演绎数据库,而不是一个更大的向量库。事实在抽取边界断言,分层规则推导闭包与时态视图,每条派生事实都带着回到来源 episode 的溯源,派生视图按 epoch 增量维护,并以十二个 MCP 工具的形式交给 Claude Code 与 Kimi CLI 使用。