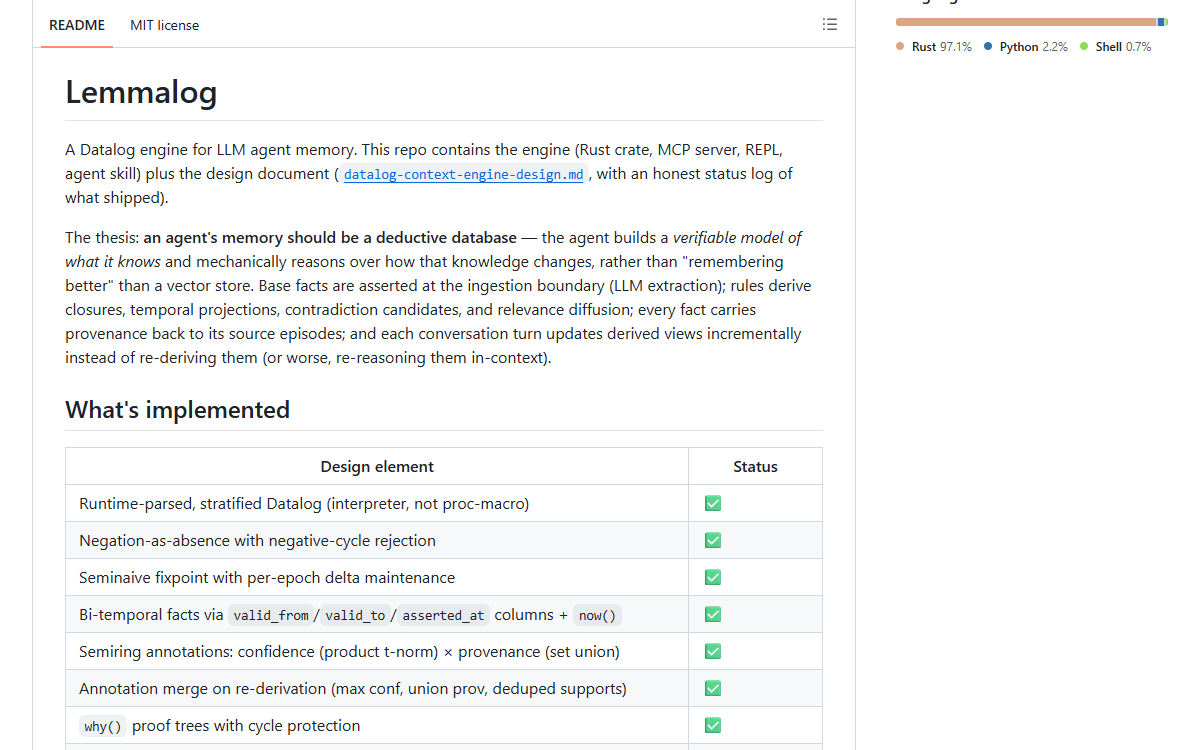
这是什么
一个用 Rust 写的嵌入式 Datalog 引擎,用来做 agent 记忆。记忆被当成演绎数据库:抽取模型把 episode 变成带注释的基础事实,分层规则层推导时态投影、传递闭包与矛盾候选,任何派生事实都可以问为什么——答案是一棵最终落到来源 episode 的证明树。事实是双时态的,所以取代是把有效期收口而不是删除;注释是半环,置信度沿证明链相乘,溯源按 episode id 集合取并。规则在运行时解析而非编译:agent 把它们作为可卸载的带版本批次安装,安装会把程序标脏,下一次 run 针对已有存储回填全部规则。求值是每个 epoch 的半朴素求值,撤回只作用于传递依赖,点查询可以走 magic sets 而不做完整不动点。它以 crate、REPL、无头 CLI、一份 agent skill 和一个十二工具的 MCP 服务的形式发布,另有 44 个测试和若干基准脚本在仓库里。
谁做的账号 2016 年注册,76 个公开仓库、4 个 gist、88 个关注者,个人站点指向 pwning.systems,签名写的是「Popping the stack all day, everyday.」。这个仓库 46 次提交里 33 次由他署名——其中 28 次来自一个 GitHub 未关联任何账号的本地地址,5 次挂在已关联账号上。另外三位贡献者合计提交 13 次,另有 5 次提交带着共同作者尾注,全部写的是「Claude Opus 5 (1M context)」。
它是怎么搭起来的
组成 · 6一个 Rust 解释器,而不是编译式规则程序;不动点保持纯净,所有非单调的东西被推到边缘。规则在运行时解析,这正是 agent 能在会话中途安装、分版本、回退与回填规则的前提;存储是行向量加逐位哈希索引,支撑每一条读取路径,规则体靠 undo trail 回溯而不是克隆环境。求值器按 epoch 做半朴素求值,撤回走有范围的负增量,按需查询走 magic sets,变更日志同时被上下文组装器和外部投影读取。其上是抽取边界——一个 trait,按 episode id 记忆化,供应商出错时退化为零事实——一个能自己解决就解决、剩下升级给 agent 的确定性更新策略、一个位置化上下文组装器、一个 MCP 服务、一个 REPL 和一份 skill。两个后果塑造了代码:安装规则会把程序标脏,于是下一次 run 清掉派生关系并针对现有存储回填全部规则;派生关系从不持久化,所以加载快照是重放基础事实并重建视图。
- src/eval.rs
- 引擎本体,86 KB,是仓库里最大的文件:行向量存储与逐位索引、注释合并、分层、靠 trail 回溯的半朴素求值、有范围的负增量、epoch 变更日志、模式查询、ask 与 ask_deep,以及证明树。
- src/agent.rs
- agent 层,50 KB:抽取边界与它的 mock 和模型实现、ADD / UPDATE / NOOP / 升级策略、升级队列、位置化上下文组装器,以及串起 observe、策略、维护、ask、context 与 why 的 AgentMemory 门面。
- src/bin/
- 四个二进制共 88 KB:50 KB 的基准运行器、31 KB 的 MCP 服务(stdio JSON-RPC,十二个工具)、7 KB 的无头 CLI(写同一份快照,供子 agent 与 cron 使用),以及 815 字节的 REPL 入口。
- The smaller src modules
- 符号内化与值、规则 AST 与手写解析器、magic-sets 改写、藏在 Embedder trait 后面的语义索引、实体规范化与读侧规范视图、混合检索、带真值的确定性长程场景生成器、REPL 命令面、抽取提示词,以及基准适配器。
- tests/
- 十一个文件、98 KB 测试,领头的是 25 KB 的 agent 测试、17 KB 的引擎测试,以及 15 KB 的差分测试(生成随机程序与朴素 oracle 对照),其后是注释、规范化、检索、聚合、评测、模型、语义与会话测试。
- README.md、设计文档与技能目录
- 一份 36.7 KB 的 README(带功能状态表和两份基准报告)、一份 22 KB 的设计文档(含实施计划、风险与状态一节)、
docs/下一个 42 KB 的单文件页面、一份 11 KB 的 agent skill、九个示例程序,以及两个 Python 基准脚本,其中一个把每一次失分归入某个桶。
取舍,以及它替代了什么
用 Datalog,并且把模型挡在不动点之外 替代 让 LLM 在检索到的上下文上推理,或把 LLM 谓词放进规则求值里
设计文档把这条边界写成发现而不是假定:没有哪个成熟系统把 LLM 调用放进 Datalog 不动点,理由很正当——LLM 调用非单调且昂贵。于是抽取发生在边界上并按 episode id 记忆化,不动点保持纯净,确定性更新策略能由规则解决的就解决,剩下的作为一件工作项升级给 agent。
规则可运行时装载的解释器 替代 Crepe 与 Ascent 那种编译期绑定规则的路线
编译期绑定恰好排除了这个项目最需要的东西——agent 在会话中途安装、分版本、回退与回填规则。代价付在求值器内部:它因此需要逐位索引、row-id 查表与 undo trail,好让规则体的 join 仍然只取最小的那个桶。
先固定一种具体的注释积 替代 一开始就做通用的注释多态
风险一节把通用情形白纸黑字地推迟了:先把一种具体的注释积定下来,等评测装置存在之后再泛化。多态是 2026-09-14 作为一份 pull request 到的,那时评测装置已经有了;作者的回复记下了这个次序——设计文档的第三阶段,正好在风险说明说它该来的时候到了。
先用索引加嵌套循环求值器,triejoin 以后再说 替代 一上来就写最坏情况最优 join
是循环 join 的基准定的:在 2,000 节点、8,000 条弧上,三角形检测在稀疏桶上很便宜,而完整物化传递闭包压倒一切——3.9M 事实、约 67 秒。README 把这条读成反对盲目物化稠密闭包、支持按需查询,而不是「在 agent 记忆的规模上需要 triejoin」。
有范围的撤回,而不是重建派生视图 替代 一旦事实被取代就把所有派生关系重算一遍
只有传递读取被撤回谓词的派生谓词会被清掉,按 stratum 顺序逐层进行,而且只有输入的键集真的变了才继续向下传播。这正是让空转轮次停在微秒级、增量轮次停在 50 毫秒左右的原因,也是差分测试装置后来逼着它覆盖「被负向读取的谓词」的机制。
把选择排序,而不是继续加抽取 替代 把更丰富的记忆塞进同一个上下文预算
在逐项枚举抽取让存储涨了约 2 倍、F1 一度掉到 0.435 之后,写进 README 的结论是:在上下文边界上,约束是选择而不是抽取。修法是把选择预算从 1,800 扩到 3,200 token,而不是少抽一点。
依据README.md(36,718 字符)、datalog-context-engine-design.md(22,066 字符)、skills/lemmalog/SKILL.md(10,975 字符)、完整的 49 个文件树及其体积,以及点名了自己改过哪些文件与提交的 issue 与 pull request 正文。
制作过程
5 个阶段- 01
三周、四十六次提交、零个 release
仓库建于 2026-08-27,46 次提交几乎平分在两个月里:8 月 24 次,9 月 22 次。它没有 release,也没有 tag,版本线从未开始。周围是 326 个星、29 个 fork、3 个 watcher,收尾时未关闭 issue 为零。贡献者四位:46 次提交里 33 次署名 Jordy Zomer,其中 28 次来自一个 GitHub 未关联任何账号的地址;另外三位——Bergmann89、Frank Noirot、Josh Biggley——合计 13 次,各自都附着一份详细报告。结尾有自己的形状:2026-09-15 的 08:34:57 到 08:35:03,六分钟里关掉四个 issue,此前他对一条 2026-09-03 的 pull request 回复「Sorry for the late response, I was on holiday.」。README 自称带着诚实的进度日志,功能表把 leapfrog triejoin 与 DBSP 式增量列在未来的阶段。
- 02
为什么是 Datalog,以及作者自己的数字在哪里反驳它
设计文档开篇就否掉它要反驳的那个框架:上下文被当成缓冲区,而不是数据库;它对更早那批系统——Zep/Graphiti、Mem0、GraphRAG、Letta——的意见不是存错了东西,而是它们什么都不推导:闭包与矛盾检测要么每次查询让模型重做,要么根本没有。它引上下文退化那一线文献,说明无论窗口标称多大,可靠上下文只有 4k–32k token。它给出四个理由:递归本来就是上下文查询的形状;可保证终止且无副作用,因此可以放心交给 LLM;增量求值已是成熟问题;半环注释一次承载溯源、置信度与新鲜度。有两条限制被明确写成限制:没有哪个成熟系统把 LLM 调用放进 Datalog 不动点,因为 LLM 调用非单调且昂贵;而定位表的五列——时态事实、规则推导、增量、溯源、对 LLM 安全的查询语言——只有 Lemmalog 全有。它自己的测量又往反方向切,README 也照实写了:在上下文边界上,瓶颈是选择,不是抽取。落地的答案是三路排序——仓内 BM25、实体命中加权(被点名的实体 +1.5、一跳邻居 +0.4),以及把 60% 的 token 留给排序后事实的组装。
- 03
一条事实带着什么,溯源落到哪一粒度
每个基础元组除了三元组,还带 valid_from、valid_to、asserted_at、一个置信度和一个溯源指针。双时态意味着更新是按注释撤回——写 valid_to,不删任何东西——历史与 as-of 查询因此都还在。注释是半环而不是普通列:置信度按 product t-norm 融合,溯源是 episode id 的集合按集合并,显著度是区间格。重新推导时是合并而不是覆盖:取最大置信度、并集溯源、去重后的支撑列表。
why()返回带环保护的证明树,对聚合事实则显示规则外加一行贡献行证。设计选择的粒度是 episode,每条事实的溯源证人数被刻意设上限,因为why()只需要一条推导,不必是指数条路径。两个约定让这个粒度对模型可用:skill 要求把证据锚成located(Entity, "file:line"),好让引用在推导后仍然活着;它还把这套乘法算清楚——四跳「已验证」的事实落到 0.66——于是核实过的事实标 1.0,推断标 0.4 到 0.7,默认 0.9。快照逐字保存 episode,从不保存派生关系:那是可重建的投影,加载时重算。 - 04
epoch、有范围的撤回,以及那次没有去写的 join
每一次
run()就是一个 epoch。自上一次以来断言的事实构成增量种子;半朴素求值让每条规则在每个绑定到该增量的正体原子处只触发一次,然后迭代到不动点,所以没有新断言的一次 run 什么也不推导。撤回是不对称的那一半,作者选了有范围的版本:只有传递读取被撤回谓词的派生谓词会被清掉并重建,按 stratum 顺序逐层进行,而且只有输入的键集真的变了才继续向下传播。每一次新增、撤回与清空都带 epoch 盖进变更日志,它支撑上下文组装器里「上一轮以来新增」的那一节,以及给外部投影用的变更流;what_if假设临时事实、回答一个目标,然后把存储逐字节还原。在一台 M 系列笔记本上,500 节点链条闭包(124,750 条事实)的不动点约 17 秒,而一次增量轮次约 50 毫秒、空转轮次是微秒级。同一批基准也被用来反驳文档自己已经选中的一件东西:在 2,000 节点、8,000 条弧的图上,三角形检测在稀疏桶上很便宜,而完整物化闭包压倒一切——3.9M 事实、约 67 秒;这条被读成支持按需查询,而不是「在 agent 记忆的规模上需要 triejoin」。 - 05
静默的成功、union 那个陷阱,以及测试抓到了什么
八份报告里有好几份共享同一种失败形状:引擎报告成功,却什么也不产出。第 7 号最锋利,因为作者的答复与报告相反。把规则收窄看起来会让旧元组仍可查询,但卸载再安装能正确撤回它们,所以陷阱是并集语义:把修好的规则作为新批次安装,旧批次仍然生效,两份定义取并集。没有任何东西提醒调用者,于是安装工具与 CLI 现在会返回警告。同一天的第 6 号是同一形状:
_Y(Prolog 的「不在乎」变量惯例)被解析成常量,用到它的规则什么都不推导,安装却照样报成功并给出回填数量。最大的一份报告来自 Josh Biggley:一个时钟同时是要写入事实的 valid-from 时间戳和now(T)读到的「现在」,于是乱序重放历史会把读取时钟往回推,823 条边里 79 条从current里消失。不用用户上报就能发现这类问题的是差分测试装置——450 个随机程序对朴素 oracle 加 2,000 例解析器 fuzz——它抓到一个可靠性 bug:被负向读取的谓词跨轮增长,从未让该规则先前的推导失效。也不是什么都成了:把计数规则接进去并没有修好计数类问题,那里的瓶颈是抽取召回而不是聚合;一条把知识更新恢复到 0.587 的抽取提示词也被回退,因为它把时态砸到 0.20。
相关档案
全部档案 →第 073 号
Engram
一条把「学一门东西」做成流水线的办法:课程架构师拆出第一性原理的概念图,一名看不见讲课过程的评分者盲评你写下的原话。再由 FSRS 排程,每次判分都在磁盘上留下一条收据。
第 129 号
Agents Universe
一套开源智能体平台,让同一个项目里的人共用一份上下文。项目选中时智能体把全部知识读进上下文,干活过程中再把学到的东西写回同一批文件;知识是磁盘上的 Markdown,数据库只做索引,没有嵌入模型,也没有向量检索。
第 117 号
sepia
一个可移植的去 AI 味写作技能:一套规则文件配四个操作,小说先修叙事结构再谈用词,专业文稿按场合套一份薄薄的规则文件,而每条规则都标着它是被测出来的、被咨询过的,还是这个项目自己的推断。