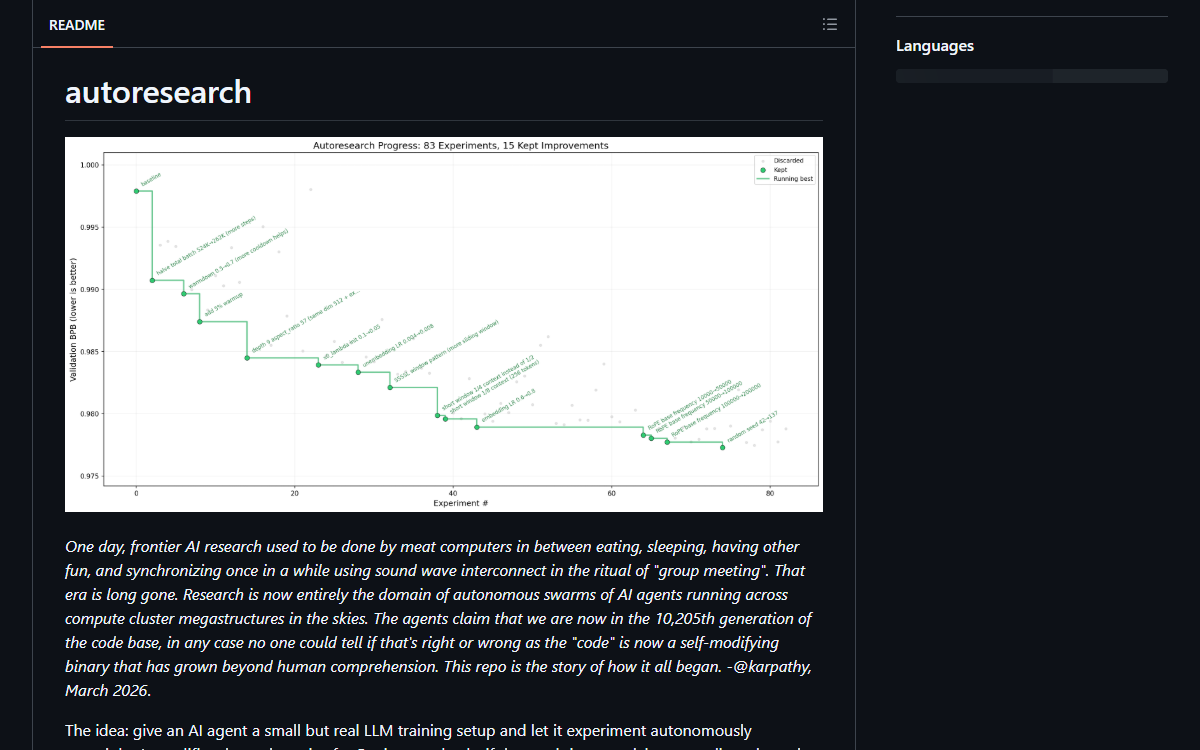
这是什么
一套小而完整的 LLM 训练装置,专门设计成可以整夜交给一个自主 agent。agent 只改一个文件,训练恰好五分钟,看验证损失有没有变好,保留改动或者回滚,然后重复——一个人睡觉的时间里大约能跑一百次实验。有意思的是这个反转:人类不再写 Python,人类写的是指挥 agent 的那份 Markdown。
谁做的斯洛伐克裔加拿大 AI 研究者,OpenAI 联合创始人,后来在特斯拉主管人工智能与 Autopilot Vision;2024 年创办 AI 教育公司 Eureka Labs,2026 年加入 Anthropic 的预训练团队。这里的训练代码是他自己 nanochat 的单卡简化版;三文件的划分是实验的重点,而不是偷懒。
制作过程
6 个阶段- 01
开场白本身就是作品的一部分
README 以一段署了名、标了日期的科幻短文开头:前沿研究以前是由「肉计算机」做的,它们要在吃饭、睡觉、找别的乐子之间挤出时间,偶尔靠声波互联完成「组会」这个仪式;那个时代早已过去,而本仓库就是这一切如何开始的故事。用这种方式开头一个机器学习仓库不常见,它给后面所有内容定了调。
- 02
反转:人类编辑的是 Markdown
真正要紧的只有三个文件,而它们按「谁有权改」来划分。prepare.py 放常量、一次性数据准备和运行时工具,不许改。train.py 放模型、优化器和训练循环,是 agent 改的那个文件。program.md 放给 agent 的指令,是人类改的那个文件。用 README 的话说,你不是在给 Python 编程——你是在给那份配置自主研究组织的 Markdown 编程。
- 03
把循环写到机械可执行的程度
program.md 把实验描述得足够具体:开一个专门的分支;直接改 train.py 试一个想法;提交;跑训练并把输出重定向到日志;从日志里 grep 出验证集 bits-per-byte;把结果记进一个制表符文件,状态写 keep、discard 或 crash;数字变好就推进分支,没变好就重置回去。一次实验五分钟,一小时大约十二次,一整晚大约一百次。
- 04
「NEVER STOP」
指令的最后一段是仓库里最值得引用的话,因为它在这里承认了自己要的到底是什么。循环一旦开始,agent 不得停下来问要不要继续——不许问「我该继续吗」,不许问「这里是不是个好的停止点」。人类可能在睡觉。如果想法用完了,它被要求想得更狠、去读代码里引用的论文、重读涉及的文件找新角度、尝试更激进的结构改动。循环一直跑到人类打断它为止,就这样。
- 05
它是一颗种子,不是一个产品
仓库大约十个文件、530 KB,它从来不是人们最终会去跑的那个东西。它变成了一个模板:13,526 个 fork,README 自己就列着别人贡献的 macOS、Windows 和 AMD 端口,还有一节专门讲怎么把默认参数缩小到比它测试用的 H100 更小的机器上。围绕它的讨论比代码本身大得多——2026 年一整年的 Hacker News 帖子把这套循环用到内核优化、SAT 求解器和强化学习上,其中一个拿到 237 分的扩展实验问的是:把整个 GPU 集群交给 agent 会发生什么。
- 06
目前的状态
2026 年 3 月 6 日到 26 日之间 36 次提交,其中 28 次来自 Karpathy,其余八位外部贡献者各一次;三条带 Claude 的共同作者 trailer。最后一次提交是 2026 年 3 月 26 日,之后安静了下来——对一个明确定位为起点、而非持续维护工具的项目来说,这比「失败」更接近预期结果。96,000 星、13,526 个 fork、195 个未关闭 issue。README 写着 MIT 许可,但仓库里没有许可文件。