上线时间 2026年3月
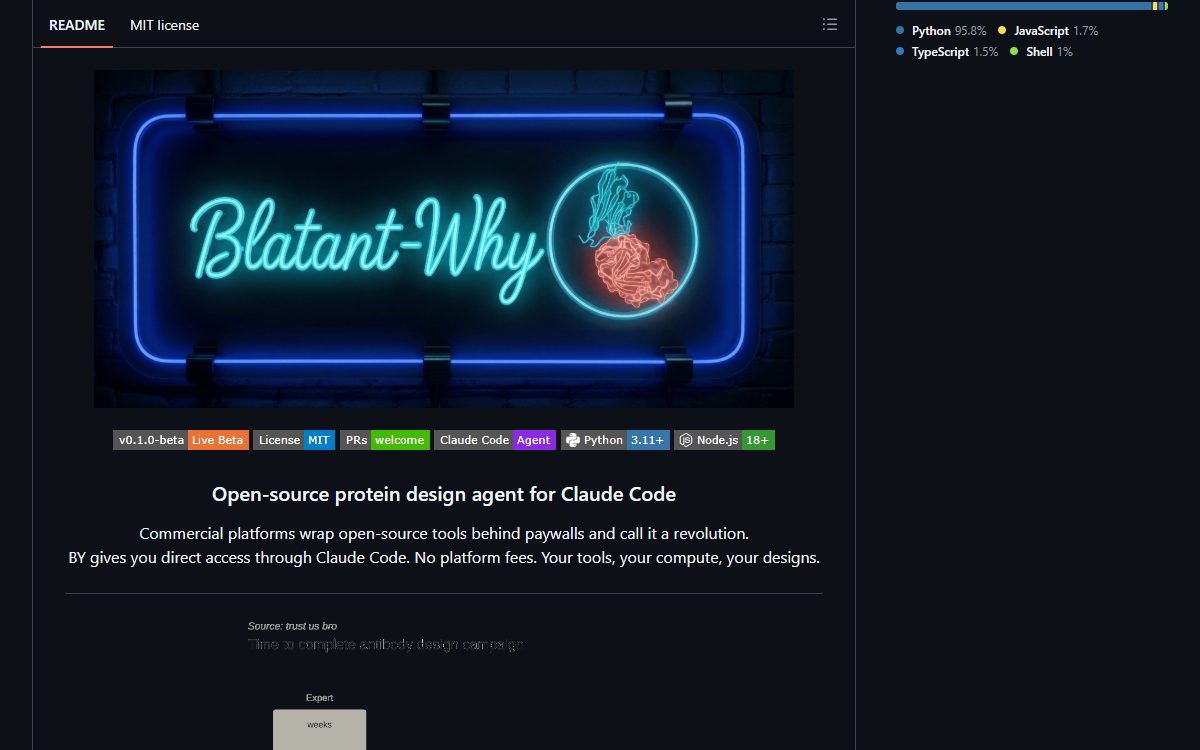
这是什么
从一个靶点蛋白走到一份值得合成的抗体清单,中间要串起五六个各自独立的程序,而难的地方是它们之间的接线。每个程序都要自己的输入格式、自己的环境、自己的任务队列。
一个模型要一份实体 YAML,结合位点残基按它自己那套编号写;下一个要一份序列 JSON;第三个要你把预测误差矩阵按对的截断值读;每个还要不同的卡。
Blatant-Why(作者自己简称 BY)把这条链打包成一个 Claude Code 项目。在一个空目录里跑一次 init,得到 11 个 MCP 服务器、21 个 agent 定义、19 个 skill 和 13 个斜杠命令,全都是普通文件,外加一份 CLAUDE.md,写明什么时候该派哪个 agent 上场。
说一句 design VHH nanobodies against PD-L1,编排层就去做那些原本要人手做的事:去 PDB、UniProt 和 SAbDab 查靶点,选表位,写出 BoltzGen 或 PXDesign 的输入,把它提交到本机显卡、RunPod 的机器或 Tamarind 的云上,用 Protenix 把每个设计重新折一遍,从预测误差矩阵里算出 ipSAE 和 ipTM,再扫一遍序列里的可开发性风险,最后交回一张排好序的表。
生成这件事不是 BY 做的。BoltzGen、Protenix、PXDesign 都是别的团队的公开模型,要单独安装。BY 是驱动它们并保存 campaign 状态的那一层。仓库简介里点了这三个名字,后面跟一句 200+ cloud tools,那说的是 Tamarind Bio 的目录,不是这个仓库发的东西。
谁做的
一个创建于 2024-02-08 的 GitHub 账号,15 个公开仓库、32 个关注者;简介写着 Proteus Labs,链到 proteusbio.ai,档期说明是 Nature has time we have GPUs。仓库 169 次提交里 168 次是他的,另一次是十月合进来的外人修复。他手上另一个项目在同一块地里:001TMF/ProteinView,一个 Rust 写的结构查看器,342 星;还有 81 星的 001TMF/harness-forge。代码里每个环境变量上还挂着的 PROTEUS_ 前缀,是这个项目早先的名字。
它是怎么搭起来的
组成 · 7组织方式是:agent 宿主就是运行时,仓库是给它的一套说明。这个项目里没有任何东西在排班、把模型放在显存里、或者对候选跑一个循环;做这些的是 Claude Code,BY 提供四类材料给它用。文字:21 个 agent 定义、19 个 skill 连同它们的参考文件,以及一份 CLAUDE.md,写明哪个 agent 按什么顺序跑、每个能碰哪些工具。可调用的程序:11 个 MCP 服务器、83 个工具,通向数据库、算力后端和 campaign 存储。算数的代码:ipSAE 的实现、综合排序,以及风险、电荷、可开发性三项筛查。还有状态:.by/campaigns 下每个 campaign 一个目录,由服务器写成 JSON 与 Markdown,再由 agent 读回去。于是这条流水线是一串文件,这既让一场 campaign 可恢复、事后可查,也让它依赖模型照说明去做,而不是依赖调度器去强制。所有贵的部分都在外面:三个引擎由用户安装、通过它们自己的命令行调用、从不打包,所以仓库很小,第一场 campaign 的启动很慢。
- templates/.claude/agents
- 21 份带 YAML 头的 Markdown agent 定义:名字、一段角色说明、一个工具白名单,以及设计 agent 那份里对实验室提交工具的明确禁用。这些是委派的单位,白名单由 Claude Code 执行,不由这个仓库里的任何代码执行。
- templates/.claude/skills
- 19 个 skill,每个是一份
SKILL.md加一个放规则的references/目录和一个放辅助脚本的scripts/目录。三个引擎 skill 各教一个套路:写输入文件、跑上游的可执行文件、解析输出的 CSV。其余覆盖 campaign 管理、打分、筛查、表位分析、失败诊断、HPC 部署和一场假设辩论。 - templates/.claude/mcp_servers
- 可调用层:11 个自足的 Python 服务器,用
uv run --script跑,合计 83 个工具。四个通向数据库(PDB、UniProt、SAbDab 和一个研究服务器),三个通向算力(本机与 SSH、一个统一的云抽象、Tamarind),四个持有 campaign:状态、筛查、知识库和带闸门的实验室提交。 - src/proteus_cli
- Python 包,同时暴露一个
proteus控制台命令:ipSAE 的实现、一个筛查包(比对、交叉验证、可开发性、多样性、风险、天然度、帕累托前沿,以及一个用接触数顶替形状互补的实现),加上 campaign 状态、成本估算、主动学习和一个 SSH 执行器。 - src/init-cli
- npm 那一半:一个 TypeScript 脚手架,检查
uv与 Python 3.11,复制模板,写.claude/settings.json,用claude mcp add -s project注册每个 MCP 服务器,问 key,再验证注册。已发布的 npm 包里只有这些。 - templates/CLAUDE.md、templates/.by/config.json 与 templates/.claude/hooks
- 编排规则、算力策略和闸门。
CLAUDE.md点名那条强制的五 agent 链,并禁止静默切换 provider;config.json把local设为默认 provider 并给出优先级列表;hooks.json装了会话启动的加载器、两个工具后的脚本,以及一个拦在实验室提交调用前的安全闸。 - templates/.claude/scripts
- 四个 hook 程序:环境加载、状态行、campaign 追踪,以及
safety-gate.js,后者读.by/lab/下的批准文件,文件不在或超过五分钟就拦掉实验室工具。
取舍,以及另一种做法
让 agent 宿主当运行时 替代 自己发一个编排器
唯一试图派发 agent 的 Python 文件
orchestrate_debate.py,把Task放在try/except NameError后面,名字不存在时就写占位提案,真正的调用留成一句注释。委派之所以成立,是因为CLAUDE.md叫模型去用宿主的子 agent 工具。取舍是看得见的:某一步停下来时,没有一个队列可查。要求用户自己装三个引擎 替代 把模型打包或内嵌进来
plugin-manifest.json把每个引擎映射到一个环境变量和一个上游 URL,代码树里没有任何东西是 checkpoint;许可证头、权重、CUDA 要求都留在上游项目那边。代价落在第一场 campaign 上:在设计出第一个分子之前,要先备好三个环境、约 50 GB 权重。用公开指标加固定权重来排序 替代 用 campaign 结果训练一个重排模型
ipSAE 是另一个仓库里的公式,来历写在注释里;综合分的权重是三个常数,旁边有写下来的理由。唯一学出来的部件是五输入、100 棵树的随机森林,用一场 campaign 自己的设计训练,小到可以读完,也小到能让一个数据泄漏 bug 藏五个月。
把 campaign 状态放在磁盘文件里 替代 数据库或托管服务
campaign 服务器在
.by/campaigns下读写 JSON 与 Markdown,agent 之间传的是路径,恢复用的 skill 按产物清单走一遍,找出上次停在哪。一场结束的 campaign 就是一个目录,不装这个工具也能复制、比对、阅读,对一份可能要进实验记录的东西来说这很重要。给实验室下单加三道彼此独立的闸 替代 一个确认提示
一个
PreToolUsehook 读带五分钟有效期的批准文件,campaign 状态自己带一个已批准标志,Adaptyv 那个工具还要一个确认码。把合成出来的蛋白送去合成,是整条流水线上唯一花了就退不回来的钱,也是唯一被这么多机构围住的一步。
依据001TMF/blatant-why 的 master:README.md、CLAUDE.md、plugin-manifest.json、package.json、pyproject.toml、.env.example、docs/LOCAL_GPU_SETUP.md、templates/.claude/agents/ 下 21 个文件、templates/.claude/skills/ 下 19 个 skill(含 by-scoring/references/scoring-pitfalls.md 与 composite-score.md、by-campaign-manager/references/cost-model.md、by-hypothesis-debate/scripts/orchestrate_debate.py)、templates/.claude/mcp_servers/ 下 11 个服务器、templates/.claude/hooks/hooks.json、templates/.claude/scripts/safety-gate.js、templates/.by/config.json、三份示例 campaign 配置、src/init-cli/、src/proteus_cli/、tests/ 与 assets/ 目录,2026-10-31 读取。
制作过程
7 个阶段- 01
生物药设计流程是什么,agent 站在哪一步
设计出来的东西是一个蛋白,它要粘在另一个蛋白上选定的那一小块表面上。做抗体或纳米抗体时,计算这一端的产出是一条序列,加上这个复合物预测出来的三维结构;它到底结不结合、结得多紧,是实验室的问题。在那之前,整条流水线给出的每一个数字都是预测。 这条链在这个领域里是稳定的。先从 PDB 取靶点结构,从 UniProt 取序列与注释,再去 SAbDab(结构抗体数据库)找已知的结合物。选表位,也就是决定结合物该落在靶点的哪些残基上,因为对着错的那一面设计,整场 campaign 就白跑。然后是生成,重活在这一步:要么用扩散模型先给出骨架再指派序列,要么用一个 de novo 结合物设计器。把每个候选复合物重新折叠,从里面读出模型自己的置信度。给界面打分,按那些让分子难做的特征过滤序列,把剩下的排个序。活下来的送去合成,拿回读数再喂进下一轮。 BY 就是这条链上的胶水,仅此而已。它自己不折任何东西,也不带任何权重。它带的是每一步的说明、算分的那几个小程序、两次会话之间的 campaign 状态,以及哪个 agent 能碰哪个工具的规矩。 这条记录里的测量来自代码树。
git ls-files列出 261 个文件、4,003,487 字节。其中 116 份 Markdown 占 1,270,053 字节、20,357 行,104 个 Python 文件占 1,090,662 字节、25,920 行。GitHub 的size字段写 12,003 KB,那算的是 packfile 里存的东西。在这里 Markdown 比 Python 更重要:agent 和 skill 都是写给语言模型的说明文字,所以提示词在产品里占的份量比代码大。 - 02
三个公开模型、一个借来的数字,还有一条 404 的链接
BoltzGen 是
HannesStark/boltzgen:MIT,创建于 2025-10-26,1,090 颗星,pip install boltzgen就能装,它自己的 README 把它描述成先扩散生成骨架、再做反向折叠和一轮分析的设计工具。BY 用它做抗体、纳米抗体和 de novo 结合物。 Protenix 是bytedance/Protenix:Apache-2.0,2,098 颗星,README 的模型表给protenix_base_default_v1.0.0写的是 368 M 参数,也就是 BY 的 skill 里说的那个 AlphaFold3 级别的模型。BY 用它重新折叠复合物,读出 ipTM、pTM 和 pLDDT。 PXDesign 是bytedance/PXDesign:Apache-2.0,272 颗星,创建于 2025-12-04,最后一次推送是 2025-12-31。它的 README 说这是一个扩散生成器 PXDesign-d,配上 Protenix 和 AF2-IG 两个置信度模型做筛选,并在七个靶点上、其中六个达到 17-82% 的纳摩尔级命中率。BY 里反复出现的17-82% hit rates就出自这句话,而它是对模型的声明,不是对 BY 跑过的任何一场 campaign 的测量。 第四个名字是打分指标。ipSAE 是DunbrackLab/IPSAE,MIT,282 颗星,src/proteus_cli/scoring/ipsae.py把它重写了一遍:取预测误差矩阵的链间区块,按残基取最小 PAE,在算 d0 归一化因子之前把界面残基数钳到至少 19,套 TM-score 核,对通过截断的残基取平均,两个方向各算一次,报其中小的那个。默认截断是 10 Å,这对 Protenix 和 AlphaFold3 的输出是对的,对 AlphaFold2 是错的,这个区别项目自己的打分笔记里写了。200+ cloud tools数的是 Tamarind Bio。README 写Tamarind provides access to 200+ structural biology tools;统一 cloud 服务器的文件头写Tamarind Bio cloud API (free tier, 200+ tools);tamarind 服务器的列表工具说自己返回226+ tools。BY 自己朝向这份目录的表面,是tamarind服务器上的 10 个工具加cloud服务器上的 8 个,多数是提交、轮询、下载。目录是真的,也是别人的;要用 Tamarind 的 key 才够得着,而没有 key 时GET https://app.tamarind.bio/api/tools返回 400,所以这条记录没法自己数一遍。 README 里有一条链接打不开。本机显卡那一节写git clone https://github.com/jostorge/boltzgen,这个仓库返回 404;jostorge这个账号下有两个公开仓库,都不是 BoltzGen。plugin-manifest.json和 boltzgen 那个 skill 都指向HannesStark/boltzgen,模型确实在那儿。 - 03
这里的「多 agent 编排」是用什么搭起来的
agent 是
templates/.claude/agents/下的 21 份 Markdown,每份带一段 YAML 头,写明名字、描述,以及它能用哪些工具。by-design拿到Read, Bash, Grep, Glob, Write加五个 MCP 通配域,并被明确禁止碰 Adaptyv 那一域;by-lab才是带着实验室权限的 agent。Python 包里没有任何一行读这些文件。读它们的是 Claude Code,白名单也是 Claude Code 在执行。 把它变成流水线的规矩写在templates/CLAUDE.md里:campaign 必须派 agent,并点名这条链:by-research写target_report.json,by-campaign写campaign_plan.md,by-design写design_summary.json,by-screening写screening_results.json,by-verifier写verification_report.md。每一段都是磁盘上的一个文件,下一段被要求去读它,/by:resume之所以可能就是因为这个:恢复协议按清单走一遍产物,从第一个缺的地方接着跑。 可调用的那一半是 11 个 MCP 服务器,合计 83 个工具,按@mcp.tool()装饰器数的:screening 14、campaign 14、tamarind 10、cloud 8、local_compute 8、knowledge 6、pdb 5、research 5、adaptyv 5、uniprot 4、sabdab 4。每个服务器就是一个带 PEP 723 文件头的 Python 文件,用uv run --script跑,所以注册只是每个目录一条claude mcp add,它们没有构建步骤。 真正试图派 agent 的 Python 文件只有一个。templates/.claude/skills/by-hypothesis-debate/scripts/orchestrate_debate.py有 571 行。它拼出三份指令(保守、激进、分散),然后调用_spawn_agent_task,这个函数的函数体是try: Task except NameError:,接下去写一份 mock 提案,真正派发的地方只留了一句注释。本该给提案排序的反思 agent 也只是一句注释,实际跑的排序是把提案自己字段算出来的四个轴做加权求和。skill 的说明把这一套叫 3+1 agent 拓扑。 所以真正跑起来的编排,是自然语言指令加文件契约,派发器是 agent 宿主自己的子 agent 工具。这是真机制,也是为什么一场停住的 campaign 留下的是对话记录而不是任务队列。同样因为这个,委派可以被跳过:它是文本文件里的一条规矩,好几个 skill 反复写「不要在主会话里内联做」,正因为规矩自己不会执行。 - 04
真正手写的代码在打分这一层
这个仓库里有四样东西是在算东西,不是在描述东西。 界面分。
compute_ipsae拿一个 PAE 矩阵和两个链掩码,从界面残基数算出 d0 归一化因子、下限是 19,用1 / (1 + (pae/d0)^2)给每对残基打分,对通过截断的残基取平均,返回两个方向以及它们的较小值。同一段代码存在两份,一份是模块,一份内联在 screening 服务器里;这是代码树承担下来的维护成本,没有被藏起来。 综合排序。0.50 * ipSAE_min + 0.30 * ipTM + 0.20 * (1 - min(高危风险数 / 5, 1)),权重和风险数上限都写在by-scoring/references/composite-score.md里,每个权重旁边有理由。 序列筛查。风险扫描是一组正则:NG、NS、NT、NA是三个严重度的脱酰胺,DG、DS、DT是异构化,每个甲硫氨酸都算氧化风险,半胱氨酸数为奇数就把它们都标成游离半胱氨酸,N-X-S/T是糖基化位点。净电荷是七个 pKa 值上的 Henderson-Hasselbalch。可开发性是疏水、脯氨酸、甘氨酸的比例,加上上面那两个输出。天然度在装了 AbLang2 时用它的伪对数似然,没装就返回一个带安装提示的错误对象。 界面几何。screen_shape_complementarity并不计算形状互补统计量。它用 BioPython 解析结构,数两条链之间 8 Å 以内的原子对,返回接触数、界面残基数和接触密度;函数上方的注释写着Simplified。这是整个代码树里唯一一处名字比代码更有野心的。 这里最好的技术写作是by-scoring/references/scoring-pitfalls.md,它知道 ipSAE 在哪里会失灵:d0 在 n0 = 19 处截断,让很小的界面不管几何如何都接近零分;在柔性的 CDR-H3 环上只用一个种子,ipSAE 能晃动 0.1 到 0.2;在 Protenix 输出上用 15 Å 截断会把分数抬高 0.05 到 0.1。这些担忧都是对的,是一个踩过坑的人写下来的。 0.50 这个权重背后的引用,是这条记录必须放慢的地方。composite-score.md把它归给The Dunbrack 2025 meta-analysis (n = 3,766 published binders),说这篇分析发现 ipSAE_min 是预测实验成功率最好的单一指标。确实有一篇这个样本量的元分析,结论也确实是 AF3 算出来的 ipSAE 胜过 ipAE 和 ipTM,平均精度比 ipAE 高 1.4 倍。作者是 Overath、Rygaard、Jacobsen、Brasas、Morell、Sormanni 和 Jenkins(bioRxiv,2025-08-14),而 Dunbrack 是 ipSAE 这个方法本身的作者。那篇论文还报告说,在 ipSAE 之外加上 Rosetta 的 ΔG/ΔSASA 和界面形状互补会更好,而这两样都不在 BY 的综合分里。权重本身站得住;引用点错了作者,漏掉的恰好是论文建议加的东西。 同一份文档还写Internal BY validation on 1,200+ refolded designs,说 ipSAE 与实验 Kd 的 Spearman 相关是 0.62,ipTM 是 0.41,pLDDT 是 0.18。代码树里没有任何数据集、脚本、表格或引用支持这三个数。这条记录把它当作作者的自述。 - 05
它跑得起来吗,跑之前要装什么
npm 上只有一个版本
blatant-why@0.1.0-beta,发布于2026-04-03T23:54:37Z,截至 2026-10-29 的三十天里被下载 19 次。PyPI 上没有这个包。GitHub 上 0 个 release、一个 tagv0.1.0-beta。这个包的files列表是dist/、templates/、README 和许可证,唯一的可执行文件叫by,而 README 的快速开始写的是npx blatant-why init。 那个可执行文件干的是搭脚手架。runInit检查uv和 Python 3.11,把模板树复制进当前目录,写.claude/settings.json并把里面的mcpServers键删掉,对每个 MCP 目录调一次claude mcp add -s project,问你要 API key,追加.gitignore,建.by/campaigns,最后用claude mcp list把服务器列回来。npm 包里没有求解器。 没有持续集成:仓库里没有.github目录。测试是有的,但没接上发布:12 个 Python 文件里有 128 个def test_函数,另有三个 shell 脚本,npm test只跑其中两个。Python 那一侧要 3.11 以上,加上click、pydantic、rich、pyyaml、numpy、biopython、httpx、mcp和scipy;scikit-learn、fair-esm、ablang2是可选附件,需要它们的功能够不上时会退化成一条说明性错误。 贵的部分在仓库外面。本机模式要一张至少 24 GB 显存的 NVIDIA 卡,项目自己的安装指南推荐 A100 或 H100、说 RTX 4090 是最低配,要 CUDA 12.1,要大约 50 GB 权重,而且三个引擎都得自己装。PXDesign 还要 CUTLASS 和自定义 kernel,它自己的 README 建议干脆用它的网页服务器。便宜的路是 Tamarind:一个免费 key、每月十个任务、不用显卡,代价是把靶点传上去。第三条路是 RunPod、Modal 或 SSH 到自己的机器,第四条是实验室,示例配置把 Adaptyv 的单价写成每个变体 175 美元、最多 20 个候选。 诚实的安装总结是:npm 包是一个小的 TypeScript 脚手架,Python 包是打分的库,所有生成性的东西都在一次git clone加一个 conda 环境之外。 - 06
119 颗星,以及它站的那层架子
读数取于
2026-10-30T17:34:54Z:119 颗星、11 个 fork、1 个 watcher、2 个未关闭的 pull request,最后一次推送是2026-10-16T00:12:10Z。 跟它驱动的模型比,这个数小:Protenix 2,098、BoltzGen 1,090、PXDesign 272、IPSAE 282。在 GitHub 的antibody-design话题下(共 59 个仓库),它排第五,前面是 BoltzGen、481 的 Rosetta、177 的 AntiFold 和 135 的 dyMEAN,后面是 112 的 MEAN 和阿斯利康的 DiffAbXL 100。在它自己占的那个更窄的位子上它是第一,而这个位子几乎是空的:按仓库描述搜antibody design agent只有四个仓库,其中三个是 1 星或 0 星,搜binder design agent有十八个,排它后面的 T-REX 是 24 星。这个方向上有公司做出来的最接近的一个是adaptyvbio/protein-design-skills,173 星。 星数背后是一段短而密的提交史。master上共 169 次提交,来自两个账号:001TMF168 次,liutmelody1 次。按月算是 2026 年 3 月 158 次、5 月 10 次、10 月 1 次;按天算是 2026-03-04 的 15 次,然后是 2026-03-23、24、25 的 36、57、50 次,三天占了一百六十九次里的 143 次。第一次提交的时间是2026-03-04T13:30:01Z,比 GitHub 建仓库的2026-03-23T18:54:59Z早十九天,所以代码是先在本机写的。之后 2026-05-20 有 9 次提交做了一轮 skill 打磨,再往后就没有了,直到最后一次提交2026-10-16T00:12:10Z,那是别人一个两文件修复的合并。 这 169 次里 153 次带共同作者尾注,其中 152 行点名了某个 Claude 模型:128 行 Claude Opus 4.6,15 行是同一个模型换个地址,7 行 Claude Opus 4.7,2 行没写版本。还有一行写的是 Codex CLI。提交标题里 64 次feat、62 次fix、10 次docs、8 次chore、5 次test。issue 和 PR 加起来一共五个:三个已关闭,两个开着,一个是发布两天后提交的六 agent 安全审计、零评论,另一个是把 Tamarind 后端换成 Modal 的分支。 星数跟来的注意力不成比例。仓库建立的那一天,正好是 Latent Labs 发布自主药物设计 agent 的同一天(2603.29727),README 第二段就是冲着这一类产品写的。2026-03-25 的一条 Hacker News 投稿最后停在 3 分、2 条评论,其中一条是署名proteus-design的回复,讲 BoltzGen 报告的成功率怎么比。 - 07
仓库没有说的那部分
没有局限一节。README 里没有一句话说排好序的设计只是预测,没有说命中率要去湿实验拿,没有临床用途的免责声明,也没有列出这条流水线做不到什么。对一个产出是「有人可能花钱去合成的分子」的工具来说,这是它最大的缺口。 它有的是一个放在证据位置上的玩笑。README 里唯一一张性能图是一张完成一场抗体设计 campaign 的耗时柱状图,三根柱子分别标
weeks、hours、minutes?,横轴写painful、vibes-based、56x faster!!!。图注是Source: trust us bro,脚注写Y-axis: conveniently omitted · Baseline: "independent expert time estimates" · n = 3 · Peer reviewed: no。作者是在告诉读者别信它,这比反过来强,但它仍然不是对「这个 agent 擅长什么」的描述。 安全与质量上的缺口写在读者很晚才会看到的地方。作者自己那套六 agent 安全审计是 pull request #1,从 2026-03-25 开到现在零评论,报告里写 8 个 critical、9 个 high、12 个 medium、8 个 low,点名 SSH 命令注入、导出路径穿越、不安全的 numpy pickle 反序列化和未钉版本的 Python 依赖。np.load(..., allow_pickle=True)到现在还在ipsae.py的score_npz里。实验室提交是唯一有三道闸门的一步:一个读批准文件的 hook、五分钟过期、一个 campaign 标志、一个确认码。这说明作者想过那个不可逆的步骤,对其余步骤想得少一些。 最有教育意义的缺陷是外人发现的。liutmelody在 2026-05-04 开了一个 pull request,标题是fix data leakage bug: remove ipsae from RF features since it's the target,正文写this looks cool! i don't think ipsae should be in the random forest features though since it's the target. lmk if i'm off base though。那个随机森林是 campaign 优化器的主动学习步骤,它拿另外五个分数去预测 ipSAE,而 ipSAE 同时是它自己的输入之一。修复涉及两个文件五行代码,2026-10-16 才合并进去,中间隔了五个月。 代码树里没有任何湿实验的结果。examples/只有三份 PD-L1 和 TNF-α 的config.yaml,没有输出。作者引用的 BoltzGen 在新靶点上 66% 这个数字,出处是一条署名proteus-design的 Hacker News 回复,不在仓库里。而项目自己开着的 pull request #5 说明了下一步:去掉 Tamarind,换到 Modal 加本机算力,理由是per the move to an own-the-stack, kimi-only harness。简介里的 200+ 和对 Claude Code 的依赖,都在这张清单上。
他会告诉你什么
- 星数量的是这个包装想法,不是里面的科学。119 在 GitHub 的 antibody-design 话题下是 59 个仓库里的第五,在五六个 agent 包装这一档里是第一,同时比它驱动的每一个模型都小:Protenix 2,098、BoltzGen 1,090、PXDesign 272、IPSAE 282。这个方向上由公司做出来、最接近的一个是 Adaptyv 自己的 protein-design-skills,173 星。
- 简介里的
200+属于 Tamarind Bio。BY 在它的 Tamarind 服务器上暴露 10 个工具、在统一的 cloud 服务器上 8 个,多数是提交、轮询、下载;背后的目录要 key,免费档每月十个任务。项目自己开着的 pull request #5 提议去掉 Tamarind 换 Modal 加本机算力,那之后这句简介就不只是借来的,而是错的。 - 多 agent 编排归到底是几份 Markdown 加宿主自己的子 agent 工具。21 个 agent 是带工具白名单的提示词,流水线是一串文件、每段写给下一段看;唯一的 Python 派发器在运行时名字缺失时写的是 mock 提案。这个设计是能跑的,代价是停住的 campaign 留下的是对话,不是一个可查的队列。
- 打分代码是真的,文档也比这个规模的多数项目好。
scoring-pitfalls.md点名 ipSAE 骗人的三种方式:界面残基少于 19 时 d0 被钳住、柔性环上只用一个种子、在 Protenix 输出上用 15 Å 截断,每一条都给了修法。综合分那个 0.50 权重引错了论文,而论文建议补的两样(Rosetta ΔG 与形状互补)也不在综合分里。 - 这里没有任何东西经过项目自己发表的湿实验验证。
examples/里是三份 campaign 配置、没有输出,README 没有局限一节,支撑 Spearman 相关系数的那句Internal BY validation on 1,200+ refolded designs在代码树里没有数据集、脚本或表格。唯一被引用的外部验证,也就是那篇 3,766 个结合物的元分析,讲的是这个指标,不是这个工具。 - 数据泄漏那个 bug 最有教育意义。有五个月时间,campaign 优化器训练随机森林去预测 ipSAE,而 ipSAE 同时是它的输入特征之一;这种错误一遍人工审查就能看出来,任何测试都看不出来。五月一个陌生人指出来,修复是两个文件五行,十月才合并。这个学习层不管还叫什么,都没有被审计过。
- 门槛在安装,不在代码。跑一场本机 campaign 要一张 24 GB 的 NVIDIA 卡、CUDA 12.1、约 50 GB 权重和三次上游安装,其中一个还要 CUTLASS、并且官方建议改用网页服务器。npm 包是 480 行 TypeScript 的脚手架,Python 包是打分的库,所有真正生成一个分子的东西都是别人仓库里的东西,要你自己 clone。
相关档案
全部档案 →
第 127 号
Lemmalog
一个用 Rust 写的 Datalog 引擎,它把 agent 记忆当成演绎数据库,而不是一个更大的向量库。事实在抽取边界断言,分层规则推导闭包与时态视图,每条派生事实都带着回到来源 episode 的溯源,派生视图按 epoch 增量维护,并以十二个 MCP 工具的形式交给 Claude Code 与 Kimi CLI 使用。
第 080 号
Engram
一条把「学一门东西」做成流水线的办法:课程架构师拆出第一性原理的概念图,一名看不见讲课过程的评分者盲评你写下的原话。再由 FSRS 排程,每次判分都在磁盘上留下一条收据。
第 140 号
Agents Universe
一套开源智能体平台,让同一个项目里的人共用一份上下文。项目选中时智能体把全部知识读进上下文,干活过程中再把学到的东西写回同一批文件;知识是磁盘上的 Markdown,数据库只做索引,没有嵌入模型,也没有向量检索。