
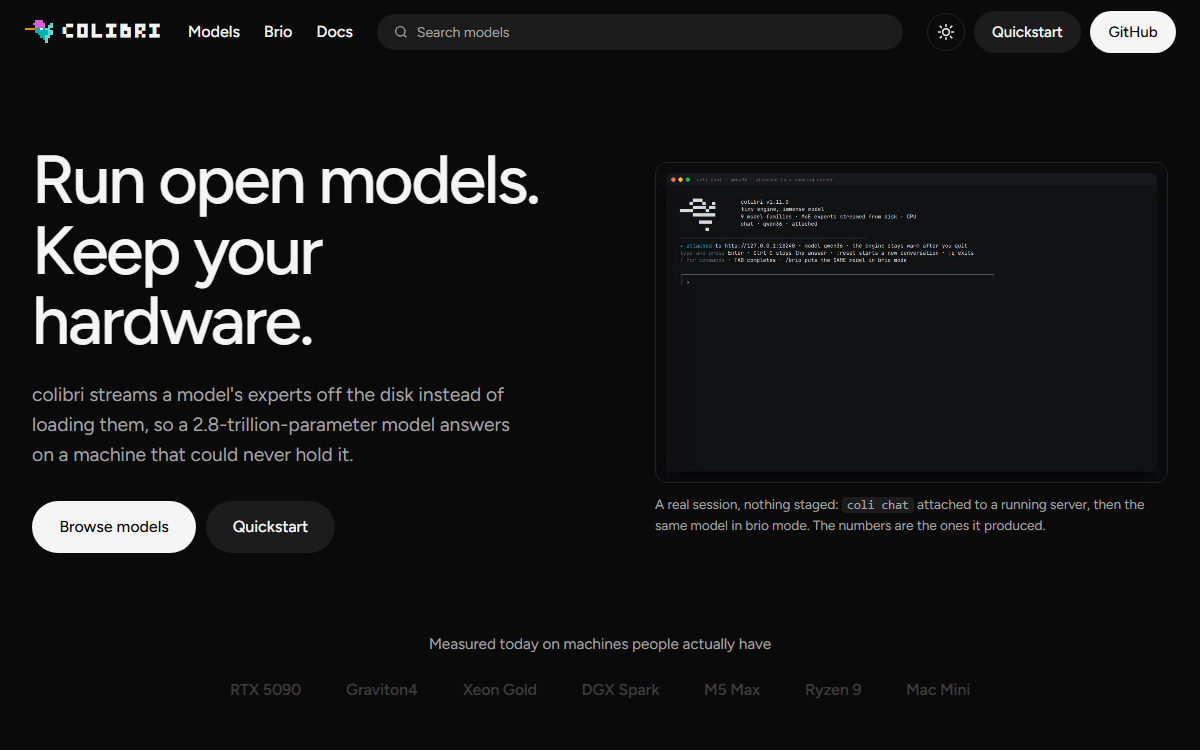
这是什么
Colibrì 不去假设模型必须装进显存,而是把显存、内存与存储当作一套统一的内存层级,从而在消费级与异构硬件上运行前沿 MoE 模型。目前已支持九个系列:744B 的 GLM-5.2/5.3、带视觉的 321B GLM-5.3-Flash、975B 的 Inkling、2.8T 的 Kimi K3、284B 的 DeepSeek V4 Flash 与带视觉的 552B V4.1 Flash、125B 的 Qwen3.8-Flash-Next、35B-A3B 的 Qwen3.6 以及 7B 的 OLMoE——每个系列一个 C 文件,共用同一套 coli chat / coli serve / coli web 前端。
谁做的仓库在 2026 年 7 月到 10 月之间累积了 2,803 次提交,最大两份份额属于 Vincenzo Fornaro(837 次)和 GitHub 账号 JustVugg(593 次)。其后对这样一个年轻项目来说分布异常宽——ZacharyZcR 216 次、monotophic 141 次、Vincenzo 63 次、Steve Markgraf 60 次、woolcoxm 55 次——贡献者名单超过一百个名字。
它是怎么搭起来的
组成 · 5引擎围绕一次反转搭建:不问「怎么把模型塞进显存」,而是把存储、内存与显存当作一套层级,让专家在其中流动。模型因此变成一组按需读取的文件,而不是一块常驻分配;有意思的问题也随之从量化变成 I/O 布局、调度、kernel 与 CPU/GPU 重叠。全部是纯 C、无引擎依赖,所以整套东西就是一批文件——每个支持的模型系列一个——共用同一个前端。
- c/ ——引擎
- 126 个文件、6.3 MB:共享运行时、内存分层、以及每个模型系列一个 C 文件——GLM、Inkling、Kimi K3、DeepSeek V4 与 V4.1、Qwen3.8 与 Qwen3.6、OLMoE。
- c/tests/
- 390 个文件、3.6 MB——占文件数的大半,也是「实验可以牺牲速度、但不能悄悄改精度或路由语义」这条承诺背后的机制。
- 三个前端
coli chat、coli serve、coli web,所有模型共用。跑哪个模型是同一个程序的配置,而不是另一次构建。- docs/
- 按主题与按模型分册:环境与安装 61 KB、Metal 后端 47 KB、格式 38 KB、Windows 35 KB、基准 28 KB,以及每个模型系列一份——最大的是
qwen38.md的 29 KB。 - web/ 与项目站点
justvugg.github.io/colibri这个静态站,以及coli web背后的web/目录——读者不必自己构建就能看到这个引擎。
取舍,以及它替代了什么
把存储、内存与显存当作一套层级 替代 要求模型必须装进显存
README 把它写成核心想法:744B 到 2.8T 参数的模型能跑在消费级与异构硬件上,是因为专家是从磁盘流式读取的,而不是常驻内存。
保证语义,拒绝保证速度 替代 在快速内存不足时降低精度
README 把它写成规则——对速度不作 SLA、对语义给硬保证——并给出理由:快速内存不够可以降速,但不能悄悄把模型重新定义一遍。
纯 C、零引擎依赖 替代 搭在已有的推理运行时之上
每个模型系列一个 C 文件、共用同一前端,只有在引擎自己掌握格式、I/O 与 kernel 时才成立;README 把「没有依赖」写成让这套内存层级可被检验的前提。
依据JustVugg/colibri 的 README、仓库文件树与 docs/ 下的分册文档,2026-10-02 读取。
制作过程
4 个阶段- 01
三个月做出一个完整引擎,以及是谁写的
仓库创建于 2026-07-01,此后每天都有推送;2,803 次提交落在七月(1,028)、八月(985)与九月(790),共 857 个文件。读者应先看署名:591 次提交带共同作者尾注,其中约 575 次署名 Claude 模型——Fable 5 166 次、Opus 5 153 次、Opus 4.8 85 次、Opus 5(1M 上下文)57 次、Fable 5.1 41 次、Opus 4.8(1M 上下文)20 次,另外还有 Opus 5.5、Sonnet 4.6、Sonnet 5 的少量计数,以及 Claude Code、Claude、Cursor 的若干条。十六次尾注署名的是人,多数是维护者。归属也不只体现在尾注上:有几次提交直接以
codex 20260923-120015-1331522267这类机器生成的名字署名。 - 02
它的主张在于模型住在哪里,而不是跑得多快
README 用两句话说明设计:744B 到 2.8T 参数的前沿 MoE 模型能在消费级硬件上运行,是因为把存储、内存与显存当作同一套推理层级,并且是纯 C、零引擎依赖。项目把这称作 AI memory multitiering,并把自己首先定位成一个研究平台。这个定位带来一条被写成规则而不是愿望的承诺:对速度不作 SLA,对语义给硬保证——实验必须靠可复现的端到端测量赢得位置,默认策略不会悄悄改变模型精度或路由语义。快速内存不够可以降速,但不能悄悄把模型重新定义一遍。
- 03
九个模型系列,每个一个 C 文件
README 逐条列出今天能跑的东西与参数量:744B 的 GLM-5.2/5.3、带视觉的 321B GLM-5.3-Flash、975B 的 Inkling、2.8T 的 Kimi K3、284B 的 DeepSeek V4 Flash、带视觉的 552B DeepSeek V4.1 Flash、125B 加 51B n-gram 的 Qwen3.8-Flash-Next、35B-A3B 的 Qwen3.6,以及 7B 的 OLMoE。每个系列是一个 C 文件,全部接在同一套前端之后——模型是引擎的一种配置,而不是它的一个分支。文档也按同样的方式切分:
docs/FORMATS.md38 KB、docs/ENVIRONMENT.md61 KB、docs/metal_implementation.md47 KB、docs/windows.md35 KB、docs/benchmarks.md28 KB,以及每个模型系列一份——qwen38.md29 KB、deepseek-v41.md26 KB、deepseek-v4.md25 KB。 - 04
仓库里体量最大的是测试
857 个文件里有 390 个在
c/tests,占 3.6 MB,而c/下的引擎代码是 6.3 MB——这个比例来自那条语义保证:一条「绝不悄悄改精度」的规则,价值只等于能发现它被改动的那些检查。贡献者名单对一个三个月的项目也异常宽:除两位维护者外还有一百多个署名,从二十次、六十次的贡献者一直到大量只提交过一次的人。
相关档案
全部档案 →第 131 号
agent-memory
一个给 AI agent 用的长期记忆运行时:Markdown 文件是唯一真相,检索在本地排序、读的时候不调用任何模型,召回返回的是路径而不粘贴正文,写入发生在对话边界而不是等 agent 想起来,另外还有一个独立的睡眠期管理层——它可以自己新增和更新,但删除永远只能以提案的形式提交。Claude Code、Codex CLI 与 Hermes 共用同一份存储,不需要任何 API key。
第 077 号
Engram
一条把「学一门东西」做成流水线的办法:课程架构师拆出第一性原理的概念图,一名看不见讲课过程的评分者盲评你写下的原话。再由 FSRS 排程,每次判分都在磁盘上留下一条收据。
第 068 号
GSD Core
「Git. Ship. Done.」——一个元提示、上下文工程与规格驱动开发的框架,每个里程碑都重复同一条五步回路:讨论、计划、执行、验证、发版。重活被推给上下文全新的子 agent,主会话因此保持轻量;每一项决定都写进规划目录下的 Markdown 与 JSON,而不是留在对话里。