上线时间 2026年9月
这是什么
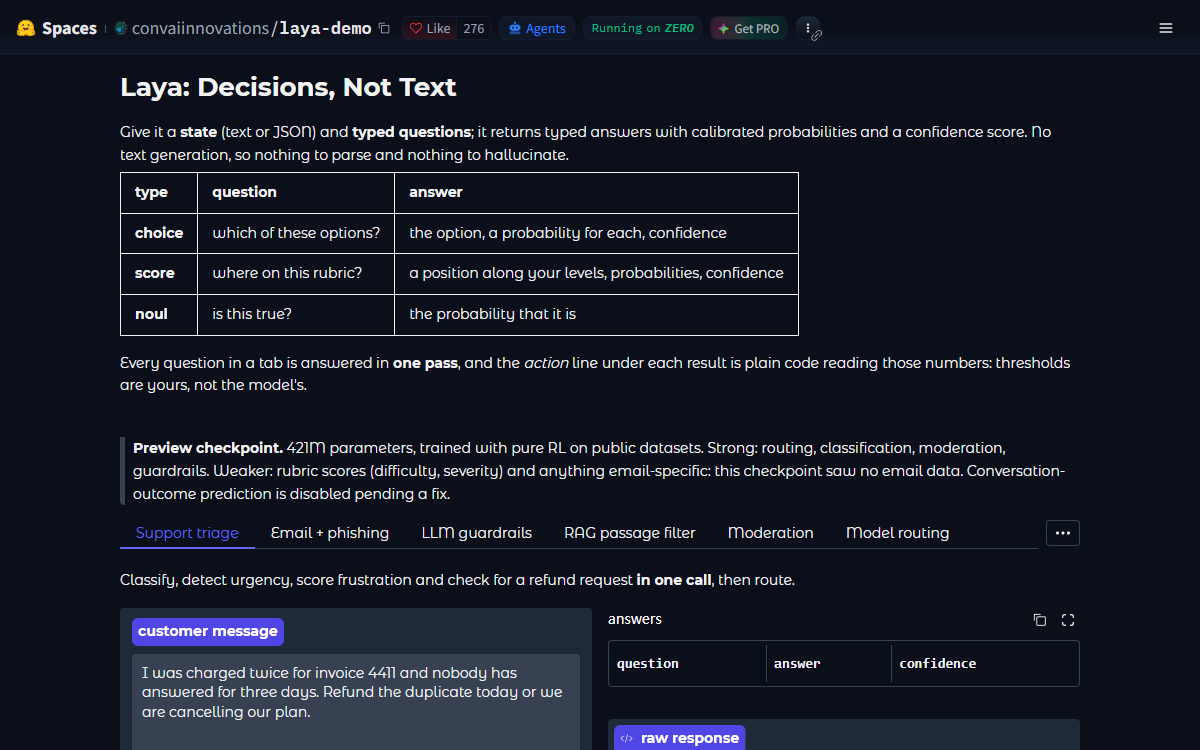
这是一个用 Python 写的判断服务,把「分类、分流、守门」这类活从大模型调用里拿出来,变成不解码的一次计算。
Laya 反过来做。
choice 问题给一组具名选项,返回这些选项上的分布;
noul 返回某个陈述成立的概率;
score 返回有序档位上的分布以及期望档位。
全程不解码,所以没有东西需要解析。
三个 checkpoint 以 Apache-2.0 发布:一个是建在 ModernBERT-large 上的 421M 英文模型,一个是建在 mmBERT-base 上的 322M 多语言模型,还有一个 421M 的工作流微调版。
Router 先读输入的脚本和语言,再决定加载哪一个,因为英文 checkpoint 上一份高棉语文本的准确率是 0.000,而它自己报的置信度是 0.952。
包里还带一个 HTTP 服务器,走的是 TypeSafe Jev 的 /v1/systemone 协议,另有 LangChain、LlamaIndex、CrewAI 和 MCP 的接入层,以及 TypeScript、Go、Java、.NET 四个 SDK。
谁做的
一个创建于 2019-03-16 的 GitHub 账号,87 个公开仓库、1,948 个关注者;简介写着 CEO Convai Innovations,并注明此前在 IIT Palakkad 的 Technology IHUB Foundation 任 principal investigator。三个 checkpoint 所在的 Hugging Face 组织 convaiinnovations 属于这家公司。仓库 2,213 次提交里 815 次是他的;贡献者接口返回 149 个账号,算上匿名是 162 个。
它是怎么搭起来的
组成 · 7组织方式是:决定本身是一个打分问题,所以模型该是一个带头的编码器,而问题该是输入的一部分,不是一段对话的一部分。一次请求被渲染成一条平铺的序列,问题的选项以 [MASK] marker 的形式排在 state 前面。编码器是双向的,所以 marker 读得到文档,文档也读得到 marker,都在同一次前向里。随后一个两层的 transformer 头读取每个 marker,打分器把每个变成一个 logit,marker 上的 softmax 就是答案。包里其余部分都从这个形状长出来。不生成词表里的东西,所以没有需要解析的输出;原语只有三种而不是开放的,所以这个头可以对着一条 proper 打分规则训练,而不是对着似然;又因为编码器就是全部开销,塞进同一个请求的多个问题共用一次前向。路由器在这个形状前面,不在里面:英文 checkpoint 读不了非拉丁文字而且自己不知道,所以选哪个 checkpoint 是在任何权重被碰到之前,从输入的脚本和语言里定下来的。
- laya/common.py
- 序列构造与模型本身。
build_sequence渲染[CLS] <type> instructions [SEP] [MASK] opt0 … [SEP] state [SEP],build_head返回每个选项的 marker 位置,DecisionModel把一个 Hugging Face 编码器与两层 transformer 头、一个scorer、一个act_head和三个温度缓冲绑在一起。 - laya/agent.py
- 运行时:加载 checkpoint 时会做版本与摘要钉定,按批大小选 autocast 与 dtype,把一次请求收成若干行,显存不够时把这一次请求降级到 CPU 跑完再把运行时恢复回去,最后把 logit 解成带类型的答案。
- laya/router.py 与 laya/lang.py
- 三个具名 checkpoint、默认只驻留两个模型的懒加载与 LRU 淘汰、决定加载哪一个的脚本与语言检测,以及
predict、predict_batch、predict_long三个入口。 - laya/calibrate.py 与 laya/confidence.py
- 按问题类型与选项数拟合温度并钳在
[0.5, 5]、弃权阈值,以及三个彼此不同的置信度:基于熵的confidence、针对所报答案的answer_confidence,和用 Jev 自己形式表达的jev_confidence。 - laya/train.py
- 微调循环:以 proper 打分为回报的
rlcd_loss、可选的选项顺序打乱(目标同步置换)、与运行时同一个温度拟合器,以及两种告警——温度从未动过,或者头塌到了类别先验上。 - laya/serve.py、laya/mcp/、laya/integrations/
- 几条进入的路:一个走 Jev
/v1/systemone路由的 HTTP 服务器,带一个给严格客户端的模式;一个 MCP stdio 服务器;以及给 LangChain、LangGraph、LlamaIndex 和 CrewAI 的适配层。 - laya-ts、laya-go、laya-java、laya-dotnet 与 sdk/
- 同一套接口协议在另外四种语言里的重写,各自带自己的夹具与测试;凡是能共用运行时的,就在持续集成里从 Python 的金标重新生成。
取舍,以及另一种做法
给选项打分,而不是把它们生成出来 替代 让解码器写出答案再解析回来
整个包里没有一处
generate调用,也没有任何采样参数。答案就是每个选项[MASK]位置上的 softmax,这使得输出在结构上就可解析,也让训练回报可以是一条 proper 打分规则而不是似然。对着一条严格 proper 的打分规则训练 替代 只对 argmax 标签做交叉熵
proper_reward是对数得分,加上球面得分的 0.75 倍,再对有序问题加一项排名概率得分。README 把这个取舍用自己的数字写了出来:微调版在 argmax 准确率上赢 Jev,0.766 对 0.727,在软准确率上输,0.471 对 0.580。在前向之前就把 checkpoint 定下来 替代 先问英文模型,置信度低再退回去
README 给了逼出这个选择的测量:英文 checkpoint 上高棉语准确率 0.000、置信度 0.952,而且它的平均置信度在任何准确率水平上都不低于 0.885,所以它自己的置信度卡不住任何东西。路由器先读脚本和语言。
把头做小,并假定使用者会微调 替代 用一个更大的模型去零样本覆盖所有领域
head_layers是 2,随包的配置里英文基座记着 1.96 小时、7,313 次更新。文档把立场直说了:Laya 是一个用来做专门化的快基座,不是一个零样本决策引擎。直接说 Jev 的接口协议 替代 另做一套自己的 API
laya-serve就回答在/v1/systemone上,LAYA_JEV_STRICT会去掉多余字段以适配按 Jev 契约校验的客户端,x_jev_confidence报的是 Jev 自己的置信度公式,所以阈值可以搬过来而不用重新标定。
依据NandhaKishorM/laya 的 README.md、BENCHMARKS.md、LOCAL_SETUP.md、AGENTS.md、CONTRIBUTING.md、pyproject.toml、docs/ 下 35 个文件(含 benchmarks.md、evals.md、finetune.md、http-api.md、routing.md、guardrail-limitations.md)、.github/workflows/、laya/common.py、laya/agent.py、laya/router.py、laya/train.py、laya/fast.py、laya/revisions.py、laya/confidence.py、laya/lang.py、research/README.md,以及 Hugging Face 上三份 rl_agent_config.json 与 encoder/config.json,2026-10-15 与 2026-10-16 读取。
制作过程
6 个阶段- 01
同一套接口协议,三台不同的机器
TypeSafe 在 2026-09-15 开放了 Jev:一个托管模型,对带类型的问题返回概率,不返回文本。这个品类几小时内就公开了,随后人们开始重写这套接口。Laya 的仓库创建于 2026-09-18,也就是三天后,是这批重写里最大的一个。 Laya 与 Kev(
jaredpalmer/kev,创建于 2026-09-17)、Jeff(firelex/jeff,2026-09-28)共用的是一套接口约定,不是代码。三者都收一份 state 加一组带类型的问题,都能直接顶在一个 Jev 客户端后面。Kev 与/v1/systemone对得足够齐,TypeSafe 自己的 Python SDK 不改一行就能驱动本地的 Kev 服务器;Laya 把laya-serve也放在这条路由上,并在每个choice和score答案里加一个x_jev_confidence,也就是 Jev 自己的置信度公式,好让从 Jev 搬过来的阈值有个能对的东西。 底下的机器并不一样。Kev 是建在 Qwen 上的解码器一族,答案从一个<decide>token 里读出来。Jeff 是一个 0.8B 的 Qwen 模型,配一组按任务替换的 LoRA adapter,外挂一套级联。Laya 只有编码器:一个双向的ModernBERT或mmBERT主干,上面接一个决策头,而问题是渲染进输入里的,不是在对话里问出来的。这个名字不是 Jev 的另一种拼法,是作者自己起的。 作者同时主张这个想法是他先发表的。Nandakishor 对 Tom's Hardware 说,他 2025 年 3 月的一篇论文 SalesRLAgent 已经提出过概率估计模型,并且公开了权重和数据集,只是当时面向销售场景,所以没被当成通用引擎看待。这是他对先后顺序的说法,这条记录把它当作一种说法记下来。 - 02
代码里的 non-autoregressive 到底指什么
这个说法可以核,而且成立。整个
laya/包里没有一处generate调用,没有max_new_tokens,没有 beam search,也没有采样计划;把这些词在包里搜一遍,什么都搜不到。 一次请求被渲染成一条平铺的序列:[CLS]、问题类型与说明、[SEP]、每个选项一个[MASK]token、[SEP]、state、[SEP]。编码器在这条序列上跑一次。一个两层的 transformer 头读取每个[MASK]位置上的隐状态,一个打分器(LayerNorm、一层线性、GELU、再线性到一维)把每个位置变成单个 logit,这些 marker 上的 softmax 就是答案分布。答案是模型在固定位置上被读出来的,没有任何东西被吐出来。 「一次前向」指的是每个请求一次,不是每个问题一次。一个请求里的每个问题都是同一次批处理里的一行,所以八个问题仍然只是一次编码器前向;Router.predict的文档字符串就是这么写的:先路由,再在选中的 checkpoint 上用一次前向回答所有问题。长文档是例外,代码里也点了名:predict_long把 state 切成互相重叠的窗口逐个打分,每个窗口一次前向。 上面还压着两块东西。每个 checkpoint 都带一组按问题类型和选项数拟合的温度,钳在[0.5, 5],在 softmax 之前作用在 logit 上。另有一个act_head,用池化表示加四个特征预测「直接行动」还是「上交」。README 自己报告说,第二个目前对几乎任何输入都读 1.0,而且它的原始 logit 与正确性反向,396 条标注决定上 AUROC 是 0.30。 - 03
这里的 System 1 是一种训练目标,而训练只花了几个小时
两个基座 checkpoint 都是公开编码器的微调:英文那个是
answerdotai/ModernBERT-large,多语言那个是jhu-clsp/mmBERT-base。项目给这套方法起的名字是 RLCD,它在包里就是rlcd_loss。做法是往 detach 过的 logit 上加高斯噪声,每个噪声样本由proper_reward对着目标分布打分,优势在组内归一化,再用这个优势去加权该样本的高斯对数密度,最后加上对目标分布的软交叉熵。proper_reward是一条严格 proper 的打分规则:对数得分,加上球面得分的 0.75 倍,再对score这类有序问题加一项排名概率得分。用一条 proper 规则去训一个分布,就是项目所说的「如实报概率是提高回报的唯一办法」的含义。 这在技术意义上确实是强化学习,而随 checkpoint 一起发布的配置文件把它的规模写在了明处,不用人去猜。英文 checkpoint 记的是 7,313 次更新、1 个 epoch、单机 1.96 小时。多语言 checkpoint 记的是 15,987 次更新、4 个 epoch、单机 4.97 小时。工作流微调版沿用英文那份数字。权重是公开的,在convaiinnovations名下三个 Apache-2.0 仓库里:英文模型 842,609,210 字节,多语言 643,835,514 字节,微调版 842,609,220 字节;后两个同时也作为子目录放在第一个仓库里。 训练数据是没公开的那一半。基准表给每条评测集标了in training mix或held out,演示 Space 把 checkpoint 描述为在公开数据集上做纯强化学习训出来的,而仓库里没有任何一页点名这些数据集,也没有发布它们。权重可以下载重跑,它们背后的语料读不到。 - 04
发布出来的 checkpoint 撑不住的地方
README 主推的数字是 typed-decisions 基准上的 0.766,而同一张表也印出了它属于谁。同一批 2,000 个决定上,两个基座 checkpoint 是 0.362 和 0.352,随机基线 0.318,多数类基线 0.461。README 自己把结论写了出来:基座在多数类基线之下,这个基准上的全部能力来自一个在该基准自己训练集上微调出来的 checkpoint。那份数据的金标来自某个 teacher 端点的三次采样取均值,而 teacher 与自己的自一致率是 0.735,所以微调版的分数量的是与 teacher 的一致程度。 公开的局限清单很长,而且写得很具体。内容审核在留出的 toxic-chat 上是 0.530、macro-F1 0.400,项目自己说这在均衡切分上只比随机好一点。一道
choice问题的选项共用一份固定的 token 预算,于是 77 个标签每个只分到三到四个 token,Banking77 掉到 0.425,而同题 Jev 是 0.870。有序的score是最弱的一项,SST-5 上 0.372。true/false这类标签词有时会盖过 state 本身决定答案。英文 checkpoint 出了英语就崩,而且是自信地崩:高棉语准确率 0.000,置信度 0.952,这还是在温度钳制之前。多语言 checkpoint 干脆没有拟合过温度,temperature是[1, 1, 1],按选项数的表是空的,而且在score问题上存在位置偏置,很少选到第一个档位。README 里记的一次否定探测中,英文 checkpoint 对四条被否定的取消请求全部选了cancel_account,多语言版有一条给到 0.9998。 后面有一次独立复现发现校准问题的方向与卡片描述相反,那条放在下一节。 - 05
27 天里的 33,025 颗星
这组计数读于
2026-10-15T17:48Z:33,025 颗星、2,968 个 fork、117 个 watcher、111 个未关闭条目;仓库创建于2026-09-18T04:46:33Z,最后一次推送是2026-10-15T10:46:25Z。前后二十七个整天。 这些星是跟着一个品类一起来的,不是单跟着这个项目来的。Jev 于 2026-09-15 开放,据一篇第三方文章的记录,它的 Hacker News 帖超过 1,900 分、520 条评论;Laya 三天后以开源替代品的身份发布,一周内成为这批重写里最大的一个。另有一篇 2026-10-05 发布的文章记录它当时已过 19,000 星,其中一天涨了 5,000。这些都不是对模型本身的测量。 数字背后干的活比一般的涨星多。main上共有 2,213 次提交,第一次在2026-09-18T04:46:27Z,最后一次在2026-10-15T10:45:46Z,作者名有 159 个;贡献者接口返回 149 个账号,算上匿名的是 162 个。最多的几个是 NandhaKishorM 815 次、aashish254 425 次、keemsisi 207 次、Bruce-Yii 84 次、PerryLink 48 次,后面的名单长而不集中在头部。993 个 PR 提过、812 个合并,来自 188 个账号;194 条 issue 来自 109 个账号。按月算是九月 1,032 次、十月 1,181 次,最重的两天是 2026-09-24 的 204 次和 2026-10-01 的 180 次。标题里 534 次以fix开头,309 次docs、243 次feat、198 次test、59 次ci、27 次release。236 次提交带共同作者尾注,其中 175 次点名了某个模型或 agent,点名 Claude 的尾注行有 172 行;另有一个 Copilot 代码审查 workflow 挂在上面。 分发的形状一致,而且只在 Python 上。PyPI 上有 46 个laya版本,从 2026-09-18T04:38Z 的 0.1.0 到 2026-10-15T10:52Z 的 0.4.8,等于这 27 天里每十四个小时发一次。pypistats.org 记录最近一个月 272,233 次下载、最近一周 67,422 次、最近一天 10,603 次。GitHub 上有 41 个 release,每个都挂着 wheel 和 sdist,合计被下载 1,619 次。Hugging Face 上英文 checkpoint 被拉取 48,894 次、5,624 个赞,多语言 11,529 次、390 个赞,微调版 2,406 次、164 个赞;演示 Space 有 276 个赞,写这条记录时正跑在一块zero-a10g上。 持续集成不是摆设:注册在案的 workflow 有十四个,其中十二个在仓库里。光ci.yml就完成了 2,082 次运行。最近 500 次跨全部 workflow 的运行覆盖 2026-10-12 到 2026-10-15,其中成功 416 次、失败 42 次、被取消 30 次,还有 12 次停在等维护者批准 fork 的工作流。有两条通道一次都没跑过。release-ts.yml和release-java.yml各完成了 0 次,41 个 tag 全是v0.x,而 README 上写的 TypeScript 安装命令npm install laya-ts在 npm 上返回 404。 - 06
外部的核查,以及跑起来要花什么
这个项目有第三方做过的工作,这在本站的记录里并不常见。 一篇独立复现加预注册研究于 2026 年 9 月挂上 arXiv,编号 2609.33843,作者声明与 Convai Innovations、基准发布方和 TypeSafe 均无隶属关系。它在全部 400 个测试用例上重跑了发布出来的工作流 checkpoint,准确率 0.767 对卡片上的 0.766,ECE 0.2142 对 0.213,score MAE 0.2424 对 0.242。唯一复现不出来的是软准确率:实测 0.5086,卡片写 0.471,实测的置信区间不含卡片值。这篇论文还测了误校准的方向,结论与卡片的说法相反,是整体偏低:带符号差值是 −0.214;在留出的一半上拟合出的单个温度 T = 0.469 把留出 ECE 从 0.204 拉到 0.037,而随包发的那张按选项数的表把分布往平的方向推,正是反的。它冻结的那套上交闸门在两条赛道上都没达到自己定的 10% 错误率目标。 第二篇是 arXiv 2610.03387(Jiawen Lu 与 Tongtong Wu,2026-10-02),把 Laya 和 Jev 放在候选覆盖这个题上对比,每个模型 23,932 条预测。在五个 TREC 候选、用自然名字的情况下,Laya 能识别出 97.2% 的缺答样本,同时把 69.7% 的正常对照误判成缺答;Jev 在同样构造下是 24.8% 和 0.0%。只用校准得到的阈值来卡,这两组变成 33.9%/3.7% 和 45.0%/1.8%。 第三份在开跑之前就注册在 Open Science Framework 上,2026-10-11 以 Zenodo 记录 10.5281/zenodo.23293732 发布:七个决策模型回答同一批 799 条未公开的是非判断,内容是编程 agent 的工作和破坏性 shell 命令,每条问三遍。对着事先定好的 0.05 期望校准误差这条线,Laya 记到 0.051,摘要给出的判定是「无法定论」;唯一与自己的校准声明相符的是 Perplexity 的开源
pplx-decider,0.026,准确率 94.7%。 仓库里有三份数据来自外部账号:一份在 RTX PRO 5000、RTX PRO 6000 和 H100 NVL 上做的容量研究,含一段 24 小时回放,代码放在另一个仓库;一份 219 条样本、284 个问题的 zh-CN 与 zh-TW 评测;以及 64 条合成的中文职场场景,配对照的 Laya 与 Jev 应答。第四份是LOCAL_SETUP.md:在一台 2019 年的 Mac Pro 上做的完整安装与验证记录,在 CPU 和 Metal 上复现了项目自己公开的表,并找出两个后来被项目修掉的移植问题,一个是在 transformers 4 上把 mmBERT 的 RoPE 基数读错,一个是 MPS 上每次请求都会抛出的 autocast 调用。 跑起来是一行。Python 3.10 及以上,pip install laya只拉 torch、transformers、safetensors、huggingface_hub 和 numpy;serve、mcp、langchain、llamaindex、crewai、onnx、fast、structured都是可选附加。checkpoint 首次使用时从 Hub 下载,之后走缓存。CPU、CUDA、MPS 和 Intel XPU 都支持,仓库里公布了在 T4、RTX 4070 Ti SUPER、Intel Arc B390、AMD 的 Radeon Pro Vega II(走 Metal)、一颗 Ryzen 9 笔记本 CPU、一颗四核 EPYC 以及一块 NVIDIA GB10 上实测的延迟。在 T4 上问一个问题,英文 checkpoint 39.5 毫秒,多语言 32.8 毫秒。
他会告诉你什么
- 星数和训练预算要分开量,这一条里两者差着三个数量级。33,025 颗星在 27 天里到齐;挣来这些星的英文 checkpoint 训练了单机 1.96 小时、一个 epoch,多语言那个是 4.97 小时、四个 epoch。仓库没有藏这件事:它是
rl_agent_config.json里的字段,就在温度旁边。 - 主推的准确率属于一个在该基准自己训练集上微调出来的 checkpoint,README 在表格下一句就说了。零样本时,两个基座 checkpoint 在同一批决定上低于多数类基线。发布出来的是一个用来微调的基座,而真正要做决定的人,最该先读的是这个项目的微调文档。
- 多语言 checkpoint 没有拟合过任何温度,
temperature是[1, 1, 1],按选项数的表是空的,所以在有人拟合之前,它给的概率不能当概率用。英文 checkpoint 带了一张表,而一次独立复现发现,这张表把分布往平的方向推,与测量给出的方向相反。 - 在英文 checkpoint 上,置信度不是预警信号。高棉语准确率 0.000、置信度 0.952,而且平均置信度在任何准确率水平上都不低于 0.885——这正是路由必须发生在一次前向之前的原因。同一个问题在工作流基准上以相反的方向出现:一篇独立预注册研究测到这个 checkpoint 是整体偏低的。
- 第三方工作存在,而且方向并不一致。一篇预注册研究把主推准确率复现到一个点以内,同时发现软准确率这一项完全复现不出来;第二篇论文发现,面对一份构造良好的候选列表,这个模型有 69.7% 的正常对照被误判成缺答;第三篇在开跑前就注册在 OSF 上,对校准给出的判定是「无法定论」。
- README 上写的 TypeScript 那条线并不存在。
release-ts.yml和release-java.yml完成了 0 次运行,41 个 tag 全是v0.x的 Python 版本,npm install laya-ts在 registry 上返回 404。npm 上确实有以这个项目命名的第三方包,那些不是它。 - 体量是真的,成熟度不是同一回事。27 天里 2,213 次提交、159 个作者名,812 个 PR 由 188 个账号合并,46 个 PyPI 版本,单个 workflow 跑了 2,082 次,最近一个月 272,233 次 PyPI 下载——这不是一个被点了星就没人管的仓库的画像,而是一个品类同时公开、而项目跟上了它的画像。
相关档案
全部档案 →
第 067 号
book-to-skill
一个转换器:把一个文档(单文件、文件夹、glob 或一串路径,格式涵盖 PDF、EPUB、DOCX、HTML、RTF、MOBI 与纯文本)读成一份 agent 技能:一份讲心智模型、带章节索引的核心文件,每章一个只在问题碰到它时才加载的文件,旁边配术语表、模式库与决策速查。
第 058 号
LeanCTX
一层贴在编码 agent 旁边、决定什么内容能到模型眼前的本地软件:文件读取会被压缩并缓存,命令输出按每条命令各自的规则压缩,会话里的发现跨对话留存,本地代理重写每一个请求同时不弄坏服务商的 prompt cache——还有一本节省账、一份预算和一块仪表盘,报告它究竟量到了什么。
第 146 号
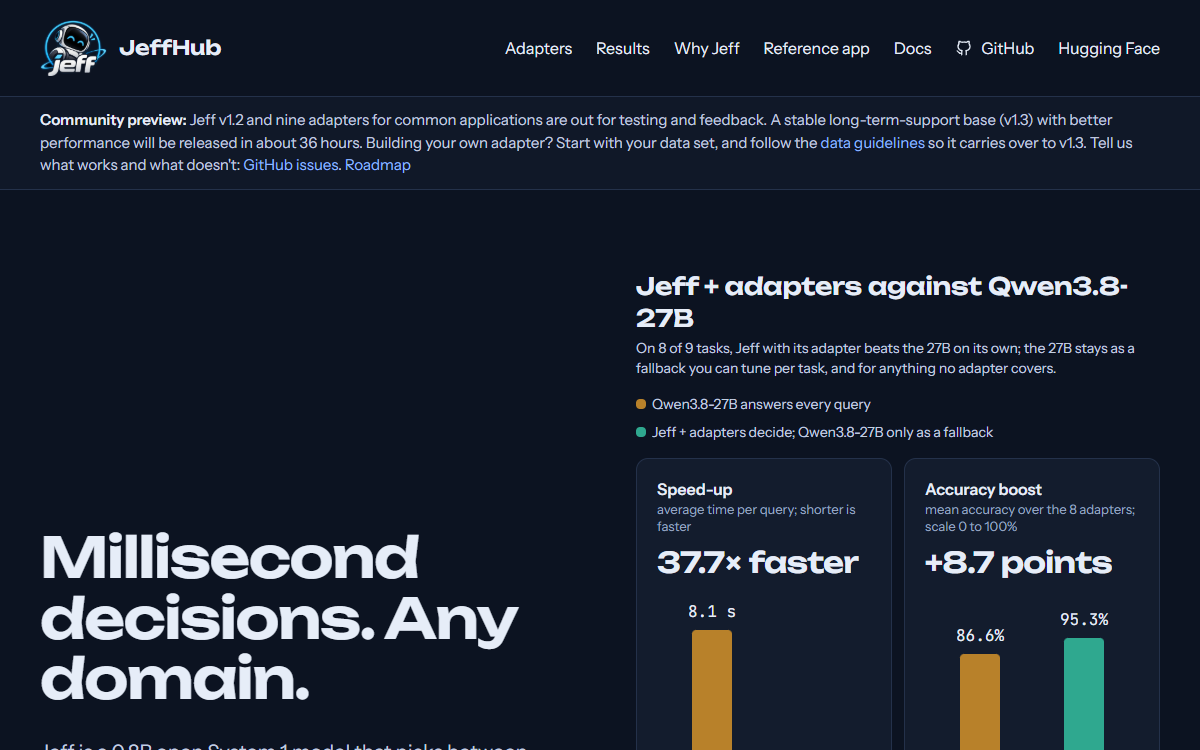
Jeff
一个 0.8B 的开源模型先回答,只有自己的置信度低于阈值时,才把问题交给大模型。