上线时间 2026年9月

这是什么
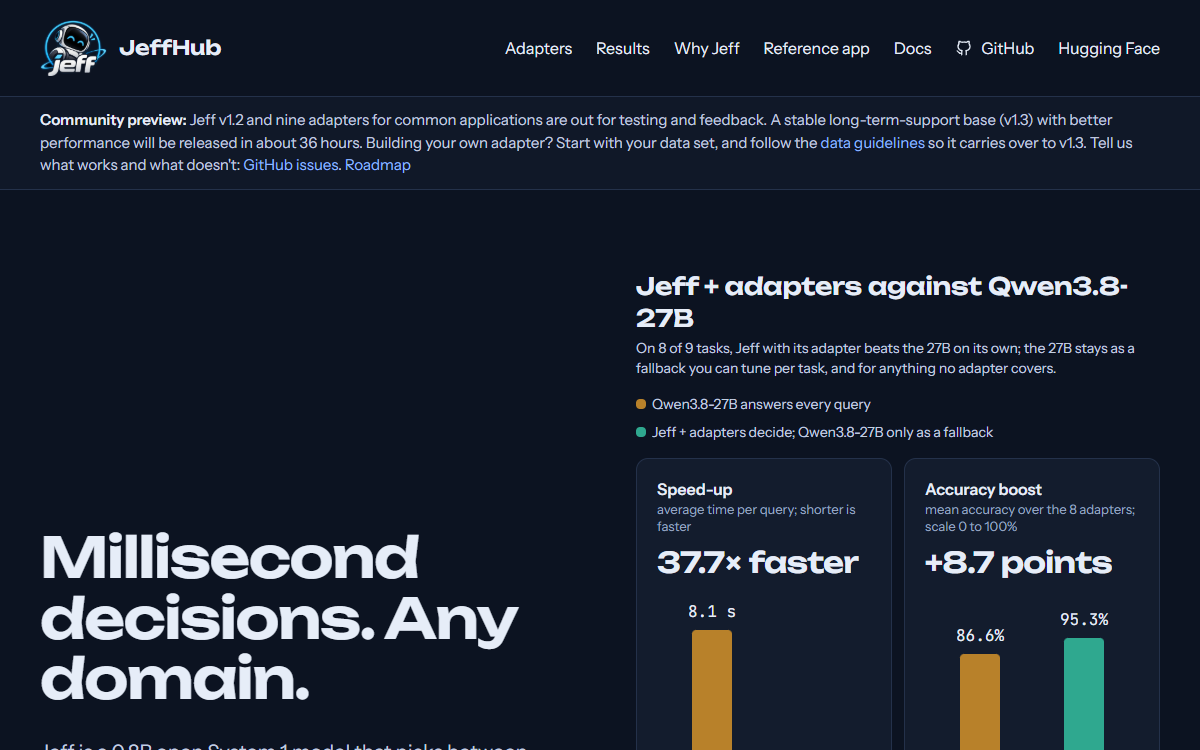
Jeff 是一个 0.8B 的开源模型,位置在大模型前面,负责把快的决定做掉。
它先回答;
当置信度低于某个任务自己的阈值时,问题继续交给 Qwen3.8-27B 这类模型,并采用后者的答案。
一个基座(Jeff-Qwen3.5-0.8B v1.2)配一组按任务替换的 LoRA adapter,于是同一套配置覆盖守卫、分诊、支持意图、工具选择、依据核对、导航、情绪、垃圾信息与合同条款。
README 自己的对比是在固定抽样的留出集上做的:级联方案 95.3%,全部由 27B 决定 86.6%,每次决定 0.25 秒而不是 8.1 秒。
这两个数字说的是那一套配置,不是「小模型普遍强过大模型」。
谁做的
仓库 14 次提交里有 13 次是他的,第 14 次来自另一位贡献者。14 次中有 9 次带共同作者尾注,且 9 次全部署名 Claude Opus 5.5(1M 上下文)。
它是怎么搭起来的
组成 · 5一个基座加可替换的 adapter,而路由决定由小模型自己的置信度做出,不靠另一个分类器。每个 adapter 有自己的阈值,并且在测试行被打分之前就固定下来:它是在该任务另一批校准行上、仍能比 27B 高出至少一个点的最快设置。低于阈值时 27B 也会作答,并且采用它的答案。常见的级联默认调用昂贵模型再过滤结果;这一条是按例外调用它,这也是 6.9% 的内存增加能换来 adapter 覆盖任务上 38 倍延迟下降的原因。
- v1.2 基座
- Jeff-Qwen3.5-0.8B,磁盘上 1,706,027,688 字节,2026-10-01 作为社区预览发布。v1.3 被宣布为长期支持基座,官方 adapter 会在其上重训。
- 九个 adapter
- 都挂在那一个基座上,每个约 41 MB:守卫(提示注入与越狱)、分诊(紧急程度与情绪)、支持意图(客户想要什么)、工具选择(agent 该调哪个工具)、依据核对(答案是否有来源支撑)、导航(语音指令对应屏幕元素)、情绪(27 种情绪中最强的一种或中性)、垃圾信息(垃圾短信与钓鱼)、合同条款(条款类型)。
- 路由规则
- Jeff 先回答,置信度低于该 adapter 阈值时把查询交下去。README 逐任务报告了交下去的比例:多数任务是 0.0%,依据核对是 1.7%。
- 对比测试台
- 两个模型都在一台 128 GB 的 Apple M4 Max 上以 MLX 运行、一次只跑一个,27B 用 8-bit。每个任务在留出测试集的固定随机抽样上打分,阈值在测试行被打分之前固定。
- docs/data-sources.md
- 7 KB,说明训练数据来自哪里;旁边是公布的数据规范。真正有用的是后者:它让别人自己做的数据集能活过基座更换。
取舍,以及另一种做法
让小模型在前面,按例外向下传 替代 每次都问大模型
README 的立场是让强的本地模型负责写作与规划、让 Jeff 在它前面做快决定;两张表就是论证:同一批数据 95.3% 对 86.6%,0.25 秒对 8.1 秒,而多数任务类型下 27B 被调用的比例是 0.0%。
在一个基座上保持 adapter 可替换 替代 每个任务一个微调模型
adapter 是每个约 41 MB 的 LoRA 增量,README 给出的九个全加载代价是 28.6 GB 配置之上的 1.96 GB。
先以社区预览发布,并写明下一个基座,而不是等它 替代 等 v1.3 稳定后再放 adapter
README 宣布 v1.2 与九个 adapter、请人提 issue,并说明 v1.3 大约 36 小时后到,同时提醒 adapter 过不了基座更换这一关而数据集可以。
依据firelex/jeff 的 README、结果表与仓库文件树,2026-10-03 读取。
制作过程
4 个阶段- 01
从空仓库到带九个 adapter 的预览,四天
仓库创建于 2026-09-28,共 14 次提交,九月 12 次、十月 2 次。它是作为社区预览而不是正式版发布的:README 宣布 Jeff v1.2 与九个 adapter,请读者把能用的部分提成 issue,并写明稳定的长期支持基座 v1.3 大约 36 小时后发布、官方 adapter 随后重训。它同时把由此带来的限制直说而不是埋起来:adapter 不能在基座版本之间沿用,必须重训;数据集可以沿用,前提是按公布的规范来做。
- 02
是谁写的:14 次提交里有 9 次署名模型
14 次提交里 13 次是作者的,1 次来自另一位贡献者。9 次带共同作者尾注,且 9 次全部署名 Claude Opus 5.5(1M 上下文),占全部历史的三分之二。这是本批里比例最高的一条,但要把它的意义和不意义分开:它是「模型写了那 9 次提交中相当一部分代码」的证据;它不是关于训练数据的证据,也不是关于下面这些基准数字如何得出的证据。
- 03
主张是一场对比,而且带着条件一起印了出来
README 并没有论证「小模型好」,而是把两种配置放在同一批数据行上并排。跨八个 adapter:全部由 27B 决定是 86.6%,由 Jeff 加 adapter 决定、其余交给 27B 是 95.3%。每次决定耗时从 8.1 秒降到 0.25 秒,错误率从 13.4% 降到 4.7%。测试方式是写出来的而不是断言的:一台 128 GB 的 Apple M4 Max,两个模型都在 MLX 上、一次只跑一个,27B 用 8-bit 并要求直接作答;每个任务在它留出测试集的固定随机抽样上打分,多数任务 300 行,情绪与合同条款 500 行。第二张表把同一组对比按任务拆开:守卫 84.0% 到 98.0%、分诊 81.3% 到 91.0%、支持意图 86.0% 到 95.3%、工具选择 90.3% 到 98.0%、垃圾信息 88.0% 到 98.7%。依据核对是唯一一项小模型没有赢的行,96.7% 对 96.3%,旁边那列说明了原因:1.7% 的查询被交了下去。
- 04
拿到的是什么,用来做什么
每个 adapter 是约 41 MB 的 LoRA 增量,在一块 GPU 上训一个 epoch,耗时半小时到四小时;基座是 1,706,027,688 字节。仓库同时带着「自己搭一套」需要的材料:
docs/data-sources.md说明训练数据来自哪里,以及那套数据规范——它让别人自己做的数据集能挺过基座版本更换。每个数字在 jeffhub.ai 上都有出处,这套对比可以用参考应用重跑一遍。
他会告诉你什么
- 情绪被有意排除在均值之外。在一条短评论里挑出 27 种情绪中最强的一种,对人也不容易,人工标注本身常常互相矛盾。把它算进去,增益是变小而不是变大:九个 adapter 全算,Jeff 加 adapter 是 91.4%,27B 是 80.9%。
- 依据核对是唯一一项 27B 很强的任务。Jeff 交出去的是自己最没把握的 1.7%,最终与它打平,96.3% 对 96.7%,速度仍是 20 倍。300 题里差一题,就是全部差距。
- adapter 不能在基座版本之间沿用,数据集可以,前提是按公布的规范做。这比听上去更有用:基座换代时,一份标注好的数据不会白扔。
- 两个头条数字是在不同硬件上测的。准确率来自一台 M4 Max、两个模型都跑 MLX;内存来自一块 RTX PRO 6000,九个 adapter 全加载、每次请求切换 adapter,每次决定中位数 30 毫秒。
修订记录
1这条记录保持最新,而不是被冻结:项目变了、某段不再成立时,就在原地更正那一段。每处更正过的段落都带标记,并在这里列出它原先的说法。
- 2026-10-03整条记录按「第一次听说这个项目的人想知道什么」重写:第九个 adapter 补上(emotion,README 把它排除在均值之外,而这条记录此前整个漏掉了它),基准数字补上 README 写明的测试条件,「不确定时」改成它真正描述的阈值机制,仓库清单收缩到读者用得上的部分。
相关档案
全部档案 →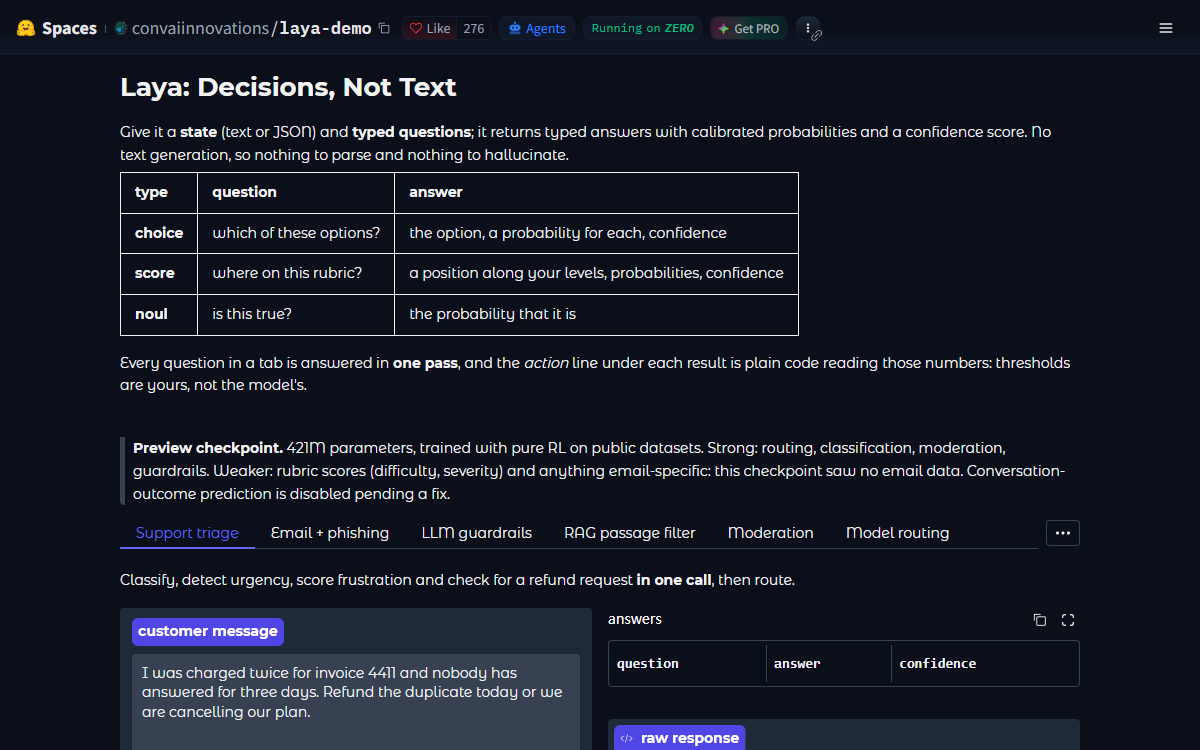
第 146 号
Laya
一族小型编码器模型:读一遍文档,为每个带类型问题的每个选项给出概率,不生成任何文本;路由器按输入文字的脚本挑选 checkpoint。
第 141 号
Forbric
一个 Minecraft 模组加载器,让 Fabric、Forge 与 NeoForge 的模组跑在同一个游戏里。
第 134 号
agent-memory
一个给 AI agent 用的长期记忆运行时:Markdown 文件是唯一真相,检索在本地排序、读的时候不调用任何模型,召回返回的是路径而不粘贴正文,写入发生在对话边界而不是等 agent 想起来,另外还有一个独立的睡眠期管理层——它可以自己新增和更新,但删除永远只能以提案的形式提交。Claude Code、Codex CLI 与 Hermes 共用同一份存储,不需要任何 API key。