上线时间 2026年9月

这是什么
应用其实反反复复在问同几个问题:这条该走哪个队列、急不急、要不要人来处理。
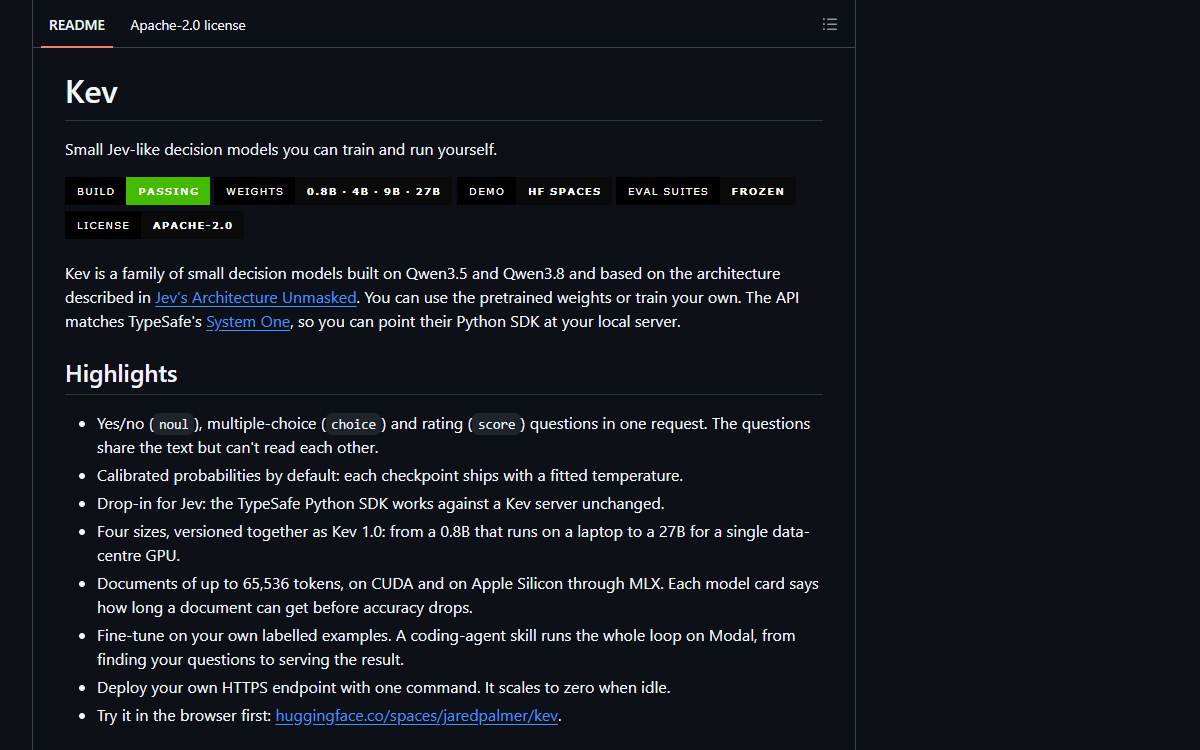
Kev 把每个问题变成一道带类型的题,配一组固定选项,一次前向就把每个选项的概率算出来,调用方拿到的是可以直接拿去做判断的数字,而不是一段还得先解析的文字。
四个规格以 Kev 1.0 一起发布,都建在 Qwen 之上:0.8B 能在笔记本上跑,往上是 4B、9B 和需要更大显存的 27B。
API 与 TypeSafe 的 System One 对齐,他们的 Python SDK 不改一行就能指向你本地的 Kev 服务器。
谁做的
这个仓库基本是一个人的:333 次提交里 312 次属于 Jared Palmer,另有八个账号各贡献一次,一个 Devin 集成机器人占十二次。README 把项目描述为 built with Devin。
它是怎么搭起来的
组成 · 6一个基座、一个适配器、一次前向。请求里带着一份文档(Kev 称之为 state)和一组带类型的问题,每个问题有一组固定选项。模型返回每个问题每个选项的概率,指针头从每个问题的一个 <decide> token 上把答案读出来,所以没有任何逐词生成。问题之间共享 state,但彼此看不见;Space 里用「Isolation probe」演示了写进某个问题的秘密对其他问题不可见。每个 checkpoint 自带一个拟合好的温度:在 Kev-4B 上,它把域外校准误差从 0.12 降到 0.05,而最高分选项不变。
- state
- 每次请求一份文档,最长 65,536 token。每个问题都能看到它;问题之间互相看不到。
- 带类型的问题
- 三种:
choice带具名选项,noul是或否,score是有序档位。每一种都以「每个选项一个概率」的形式返回。 - 读出
- 指针头把每个问题的
<decide>token 与各选项的区间打分。答案是从模型里读出来的,不是它写出来的。 - 适配器
- 在冻结的 Qwen 基座上,对注意力、MLP 与 Gated DeltaNet 投影做 r=16 的 LoRA,再以 fp32 合并进基座权重。Kev-27B 则是全量微调。
- 接口约定
- 请求与响应遵循 TypeSafe 的 System One,他们的 Python SDK 不改一行就能对着本地的 Kev 服务器工作。
- 评估集
- 每轮冻结,发布为
jaredpalmer/kev-suites,并带一个模板,把每次训练自己的问题放进同一种形式。
取舍,以及另一种做法
用概率分布回答 替代 生成一段文字再去解析
README 把它当作设计而不是偏好来写:一份文档加一组带类型的问题进去,每个选项一个概率出来,一次前向,不生成文本。
四个规格按同一个版本发布 替代 各自单独发
四个模型以 Kev 1.0 一起发布,每个 Hub 仓库都带
v1.0标签,写死标签就一定加载到同一份权重。较小的三个规格共用一套训练配方 替代 每个规格一套
README 写明 0.8B、4B、9B 共用一套:在冻结基座上训练一个小适配器。27B 是文档里写明的例外,做全量微调。
依据jaredpalmer/kev 的 README、space/README.md、模型表与仓库文件树,2026-10-03 读取。
制作过程
3 个阶段- 01
四个规格一次性发布为 Kev 1.0
仓库创建于 2026-09-17,四个模型同时发布:0.8B、4B、9B 与 27B。每个 Hugging Face 仓库都带
v1.0标签,写死版本号就一定加载到同一份权重;较小的三个 checkpoint 还随 GitHub release 附了 SHA-256 校验值。27B 是这一族里的例外:0.8B、4B、9B 是在冻结的 Qwen 基座上训练一个小适配器,而 27B 从 Qwen 的后训练版本出发做全量微调,所以它是 51 GB 的完整权重,而不是一个适配器。 - 02
每一轮评估都留着
仓库有 3,049 个文件,占重量的是结果而不是代码:
evals/round514.6 MB、evals/devtools-v112 MB,后面还有runs/r5-combined。每一轮保留自己的数据与测量值,而不是覆盖上一轮,于是一次配方改动事后仍能对着上一轮比较。研究笔记就放在它产出的产物旁边:docs/autoresearch.md,22 KB。评估集另外发布为jaredpalmer/kev-suites,一个结果因此可以回到它出自的那批数据上重读。 - 03
Devin 写了多少
仓库有 333 次提交,其中 312 次属于 Jared Palmer。145 次提交带共同作者尾注,134 次署名 Devin:127 次写作
Devin、6 次Devin AI、1 次是集成机器人;其余 11 次署名的是人或某个 Claude 模型。README 用五个词说了同一件事:「Built with Devin」。尾注能支持的是:Devin 参与了大部分开发过程。它自己独立完成了哪些改动,尾注答不了,这条记录也不假装知道。
他会告诉你什么
- Kev-0.8B 是个不足 1B 的模型,域外表现明显更弱。Space 不用人问就写明了这一点,并补上真正要紧的一句:在你自己的输入上测。
- 「校准过」不等于「正确」。Kev-4B 在域外的校准误差是原始 0.12、套用拟合温度后 0.05,两种情况下最高分选项都不变。
- 在你有过的问题上训出来的模型,不等于能回答你还没想到的问题。没有训练样本可对应的产品型问题,是没有保证的。
- README 拿 Kev-27B 与托管的 Jev 做比较,然后自己说明了这个比较值多少:在新来源上差一个点以内,但 TypeSafe 之外没人知道 Jev 是在什么数据上训的,所以这不是两种架构的受控对比。
修订记录
1这条记录保持最新,而不是被冻结:项目变了、某段不再成立时,就在原地更正那一段。每处更正过的段落都带标记,并在这里列出它原先的说法。
- 2026-10-03整条记录按「第一次听说这个项目的人想知道什么」重写:机制在前、提交历史在后,标题不再带提交数,把「一个人指挥自主 agent」的推断换回尾注能支持的说法。用到的工具从 Claude 更正为 Devin:145 条共同作者尾注里 134 条署名 Devin。