
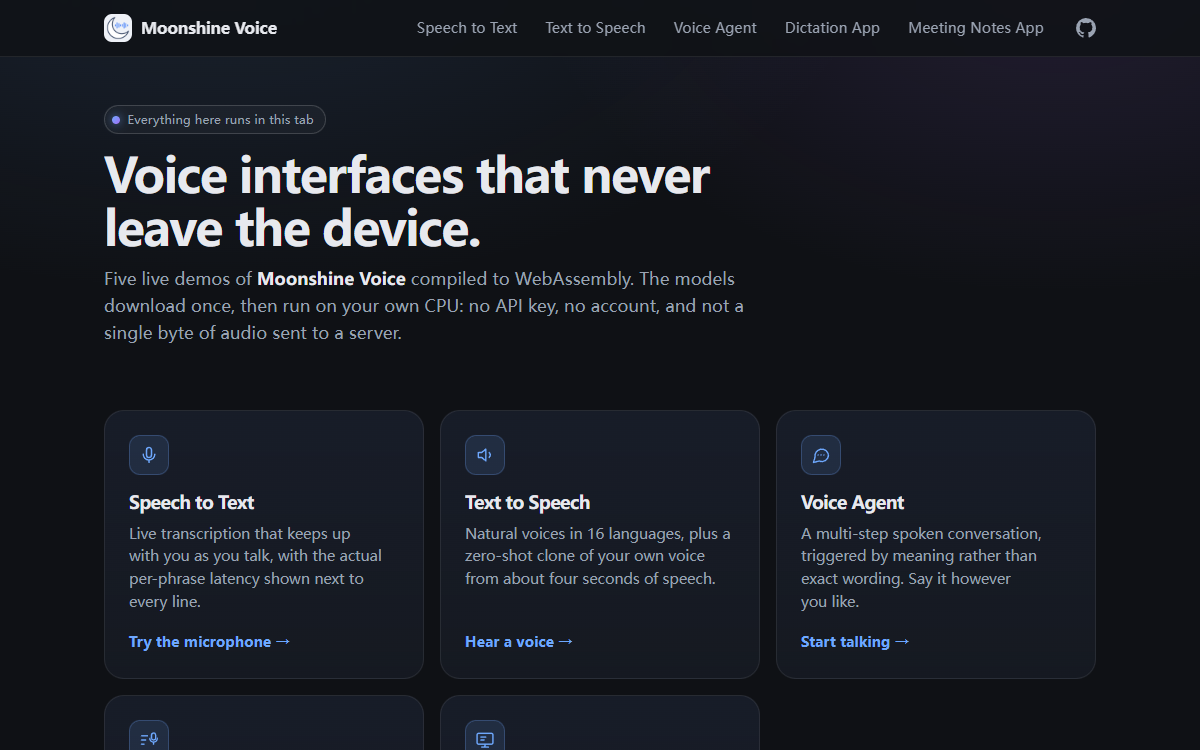
这是什么
Moonshine Voice 是一套用来构建语音 agent 与语音界面的语音栈:极低延迟的语音转写、意图识别与语音合成。它以 C++ 核心加各平台构建的形式发布,另有一个存放小模型的 micro/ 目录;文档不只是解释 API,而是表明立场——词级时间戳、执行后端、说话人分离,以及一页与 Whisper 的对比。
谁做的仓库 666 次提交里 594 次是他的,其后是 Kyle Howells 26 次、Evan King 17 次、Giovannini Barbosa 9 次,以及一长串一到两次的贡献。75 次提交带共同作者尾注:其中 74 次署名 Cursor,1 次署名某个 Claude 模型。
它是怎么搭起来的
组成 · 4一个自带依赖树的 C++ 核心,加上一棵单独存放小模型的目录,于是整套栈不需要包管理器、也不需要一次网络往返就能构建与运行。三项能力——转写、意图识别、合成——被呈现为给语音界面用的一套栈,而不是三个产品;文档把周边问题(时间戳、执行后端、说话人分离,以及它和 Whisper 比怎么样)也当作产品的一部分来写。
- core/
- C++ 引擎:转写、意图识别与合成,内含 341 个文件、63.4 MB 的第三方依赖树,因此无需另外安装任何东西。
- micro/models
- 十六个文件、30.6 MB 的小模型随仓库发布——这正是让设备可以本地运行这套栈、而不必外呼的原因。
- docs/moonshine-vs-whisper.md
- 一个 8 KB 的对比页,对象是读者最可能已经在用的那个模型——把文档当作立场而不是说明。
- 按主题分册的文档
- 词级时间戳 12 KB、示例与快速上手 8 KB 与 7 KB、发布流程 6 KB、大文件存储清理说明 5 KB,以及执行后端与说话人分离各一页。
取舍,以及它替代了什么
把依赖树 vendored 进核心 替代 在构建时依赖包管理器
341 个文件、63.4 MB 的
core/third-party,是不需要安装步骤就能构建的 C++ 栈所付的代价——而这正是设备上的语音界面所需要的。把小模型放进仓库一起发 替代 第一次使用时下载
micro/models下十六个文件、30.6 MB 被提交进仓库,于是首次运行的延迟与没有网络都不再是失败模式。把与 Whisper 的对比作为文档的一部分来维护 替代 把这个比较留给读者
docs/moonshine-vs-whisper.md有 8 KB,明确点出现任者的名字,而不是把这个问题暗示过去。
依据moonshine-ai/moonshine 的 README、docs/ 与仓库文件树,2026-10-02 读取。
制作过程
3 个阶段- 01
一位作者、594 次提交,以及一个署名 Cursor 的尾注
仓库创建于 2024-10-04,此后持续推送;按月统计的提交量从 2025 年 12 月的 28 次一直到 2026 年 7 月的 143 次。共 666 次提交,其中 594 次属于 Pete Warden,其后是 Kyle Howells 26 次、Evan King 17 次、Giovannini Barbosa 9 次,以及一串各一次的贡献。75 次提交带共同作者尾注,其中 74 次署名 Cursor——除那些由 agent 维护的项目外,这是本批里 AI 署名计数最高的一条,也是关于近期代码如何写成的一句直白说明。
- 02
文档是在论证,而不是在描述
docs/不是 API 参考。它从 12 KB 的word-level-timestamps.md开始,接着是 8 KB 的moonshine-vs-whisper.md——一个项目自己维护的、与大多数读者本来就在用的那个模型的对比页——然后是examples.md与quickstart.md(8 KB 与 7 KB)、release-process.md6 KB、lfs-purge.md5 KB,以及各自 4 KB 的execution-providers.md与diarization-models.md。一个把发布流程、以及如何清理大文件存储历史都写进文档的仓库,是作者预期别人会在它上面接着做的那种。 - 03
重量在哪里
目录树共 2,384 个文件,两个沉重的目录是 341 个文件、63.4 MB 的
core/third-party,以及十六个文件、30.6 MB 的micro/models。这个分布用一句话说清了设计:C++ 核心自带一整棵依赖树,因此没有任何东西需要安装;小模型是随仓库发的,而不是第一次使用时下载——这正是让一套低延迟语音栈成为「设备能拿得住的东西」而不是「设备要调用的服务」的原因。
相关档案
全部档案 →第 137 号
Agents Universe
一套开源智能体平台,让同一个项目里的人共用一份上下文。项目选中时智能体把全部知识读进上下文,干活过程中再把学到的东西写回同一批文件;知识是磁盘上的 Markdown,数据库只做索引,没有嵌入模型,也没有向量检索。
第 075 号
Colibrì
一个纯 C、不带任何引擎依赖的推理引擎:把存储、内存与显存当作同一套层级,让 744B 到 2.8T 参数的 MoE 模型跑在人手已有的机器上。
第 068 号
GSD Core
「Git. Ship. Done.」——一个元提示、上下文工程与规格驱动开发的框架,每个里程碑都重复同一条五步回路:讨论、计划、执行、验证、发版。重活被推给上下文全新的子 agent,主会话因此保持轻量;每一项决定都写进规划目录下的 Markdown 与 JSON,而不是留在对话里。