上线时间 2026年4月

这是什么
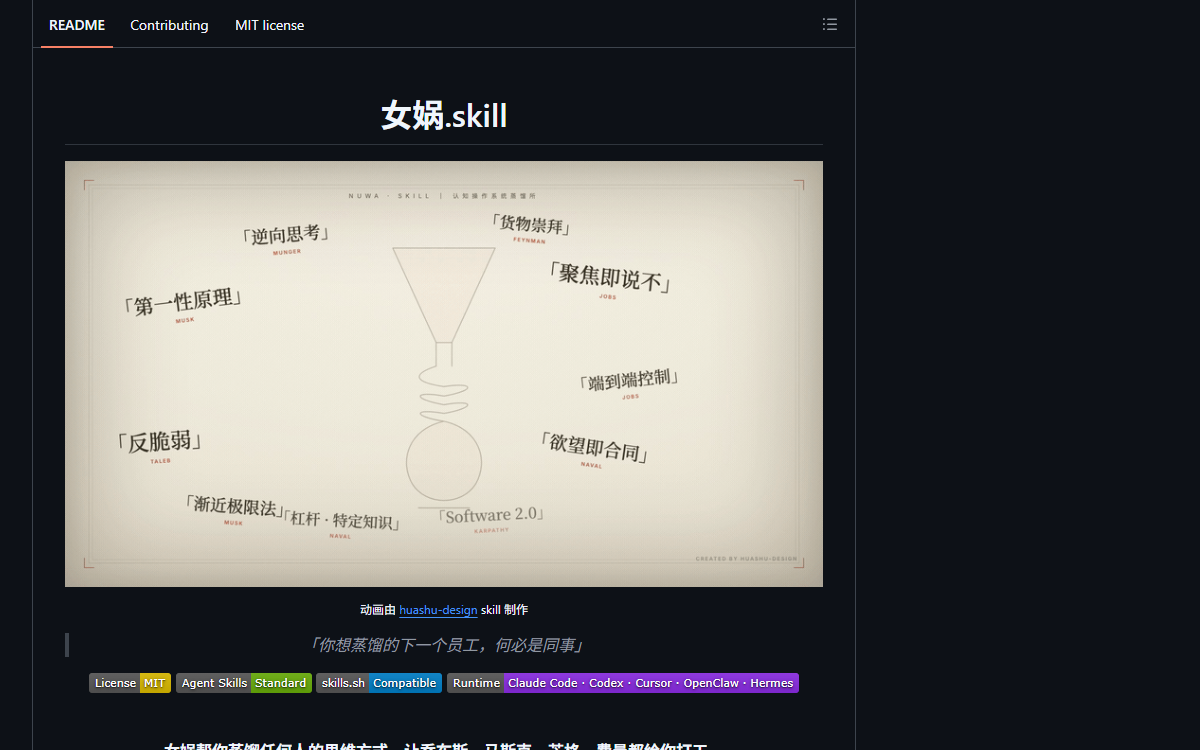
这是一个建立在 Agent Skills 协议上的技能:给它一个名字,它跑六维度调研,产出七份文档再写出人格技能。
给它一个名字,它会跑一套六维度调研(此人写过什么、长对话里怎么说话、表达习惯、别人对他的批评、他的决策记录、他的时间线)产出七份可溯源的调研文档,然后写出一个人格技能:心智模型、决策启发式、表达 DNA、对自己局限的明确声明,以及一套防漂移机制。
它建立在开放的 Agent Skills 协议之上,宣称可在五十余个兼容工具里运行。
一个社区索引收集别人蒸馏出的人格,每一份都带一张保真度评分卡。
谁做的
58 次提交里 56 次出自他,也是社区索引的维护者。他还维护着自己另一个技能 huashu-design,而本项目 README 顶部那段动画横幅正是它做出来的——他名下的一件作品在替另一件打广告。
制作过程
8 个阶段- 01
三万三千个星,给一份三十八 KB 的指令文件
仓库是 38.6 MB、159 个文件,而它真正交付的东西是 38,280 字节的
SKILL.md。其余是调研参考、示例、推广素材与动画。历史是五个月 58 次提交,每一次都挂在已关联账号上,来自三位贡献者,其中 56 次出自作者。没有 release,也没有 tag。它拥有的是这个体量的项目大多没有的东西:五份并行 README(中文 17 KB、日文 16 KB、韩文 15 KB、西班牙文 15 KB、英文 14 KB)这既是关于读者被预期在哪里的声明,也提醒我们:本档案以英文为先的读法,并不是唯一可得的一种。 - 02
它做什么
给它一个名字,它就去调研这个人,并写出一份别的 agent 可以加载的技能。README 对这份野心异常直白:前一个项目证明了蒸馏一个同事是可行的,那么(按它的论证)何必蒸馏同事?去蒸馏乔布斯、芒格、费曼、马斯克。名字取自中国的创世女神,这正是那个玩笑:她造人,而这个东西用文本造人。README 里的示例对话中,一个被蒸馏出来的投资人回答一位说「我想同时做自媒体、写书、做独立开发」的人,给出的答案是:这三个都是你跟不快乐签的合同,问题在于哪一个做起来你会忘记时间。无论怎么看待这个品类,那都是一个可辨认的声音而不是对某个声音的概括——而从一堆语料里造出一个可辨认的声音,正是这项技术主张的全部。
- 03
最有意思的地方,是它承认人格会出错
这个仓库里最不寻常的文件是保真度评分卡。一个被蒸馏出的人格要经过独立的两阶段测试:一个 agent 出题作答,另一个独立的 agent 打分,产出分维度结果、总评等级与测试日期;社区条目必须达到一百分里的七十分(B 级)才能通过自动闸门。每一份技能还必须带一节明确的「诚实边界」和一章「反模式」。这个组合是正确的直觉,而且少见:交付物不是一个自称是某名人的提示词,而是一个自带误差棒、并写明自己会在哪些地方出错的提示词。打分者和被评分的东西是同一类模型,所以评分卡衡量内部一致性的能力,远好于它衡量「这次蒸馏对不对」的能力。
- 04
贡献闸门是个机器人,而这个机器人很具体
要把一个人格加进社区索引,得过一道自动检查,它会逐条分列报告:这个 pull request 是否只改了索引文件;被链接的仓库是否存在;里面是否有
SKILL.md;技能里是否有「诚实边界」那一节;是否有 references 目录、且其中还有 research 目录;保真度是否至少七十分;以及评分卡的关键字段里有没有占位值或估算值。全部通过之后,机器人才说检查通过,并补上一句:合并前维护者仍会人工确认伦理红线和抽查内容。最后那个条件(去核实调研痕迹是否存在,而不是相信对它的总结;拒绝数字是估算的文档)比那些触达量是本仓库一百倍的项目用在任何事情上的标准都严。 - 05
六个维度、七份文档,而且要留痕
流程中调研的那一半是被规定的:六个维度的考察,产出七份文档,覆盖此人发表过什么、在长对话里怎么说话、表达习惯、别人对他的批评、他的决策记录,以及一条时间线。这些文档必须自包含、可溯源,而至少有一条社区条目特意写明,它的证据里包含一份由提交者本人提供的一手视频逐字稿。坚持留痕的理由很简单,也正是本档案保留「来源」一行的同一个理由:否则一个被蒸馏出的人格是不可证伪的。关于某人如何思考的每一句断言,都只能依赖于那份蒸馏物「看起来对」——而那恰恰是读者在没有原始材料时无法做出的判断。
- 06
一个协议,五十个运行时
这里的分发方式与本档案里另一个人格合集不同。本项目声明自己建立在开放的 Agent Skills 协议之上,可在五十余个兼容工具中运行(Claude Code、Codex、Cursor、OpenClaw、Hermes Agent、CodeBuddy、Workbuddy、Gemini CLI、OpenCode 等)并挂着一个技能注册表的兼容徽章。另一个人格名单是把 agent 转换成十三种目标格式、用自己的管线去做,并为此付出了一条曾静默损坏一百三十一个文件的转换步骤的代价;而这个是因为标准存在而可移植,不是因为写了一个转换器。这个差别最终体现为:这一整类 bug,这个仓库没有。
- 07
一个被蒸馏者组成的社区,以及一条写下来的红线
索引收集别人做出来的东西:一位短视频平台的财经创作者;一组心理学人物(弗洛伊德、荣格、阿德勒,外加一位被用谐音梗并进来的中文互联网人物);以及更多还在到来。每一条都带自己的保真度等级,那组心理学四个全是 A 级。财经那条带着「不构成投资建议、不能替代专业人士」的免责声明,而贡献指南为这个仓库写下了一条伦理红线。蒸馏一个活人的思维方式(或者一个逝者的)会带出关于同意、准确与伤害的问题,这个领域里多数项目干脆不碰,而这个项目把它写成规则、放进清单,而不是留给各人品味。
- 08
仓库无法告诉你的事
58 次提交、零 release、零 tag,最后一次提交在本记录写作前五周,而社区 pull request 仍在到来、十个 issue 开着。仓库有 38.6 MB,其中指令文件占 38 KB:重量都在动画、示例与推广素材上,而这恰恰是对一个三万三千星项目「把字节花在哪」的公道描述。保真度分数来自与蒸馏同一族的模型,所以它是一致性测量,不是准确性测量。而 README 顶部那段动画横幅,出自同一位作者维护的另一个技能。这既是对生态的一次可爱演示,也是一小段自我推销,而且诚实地说,两者都是。
相关档案
全部档案 →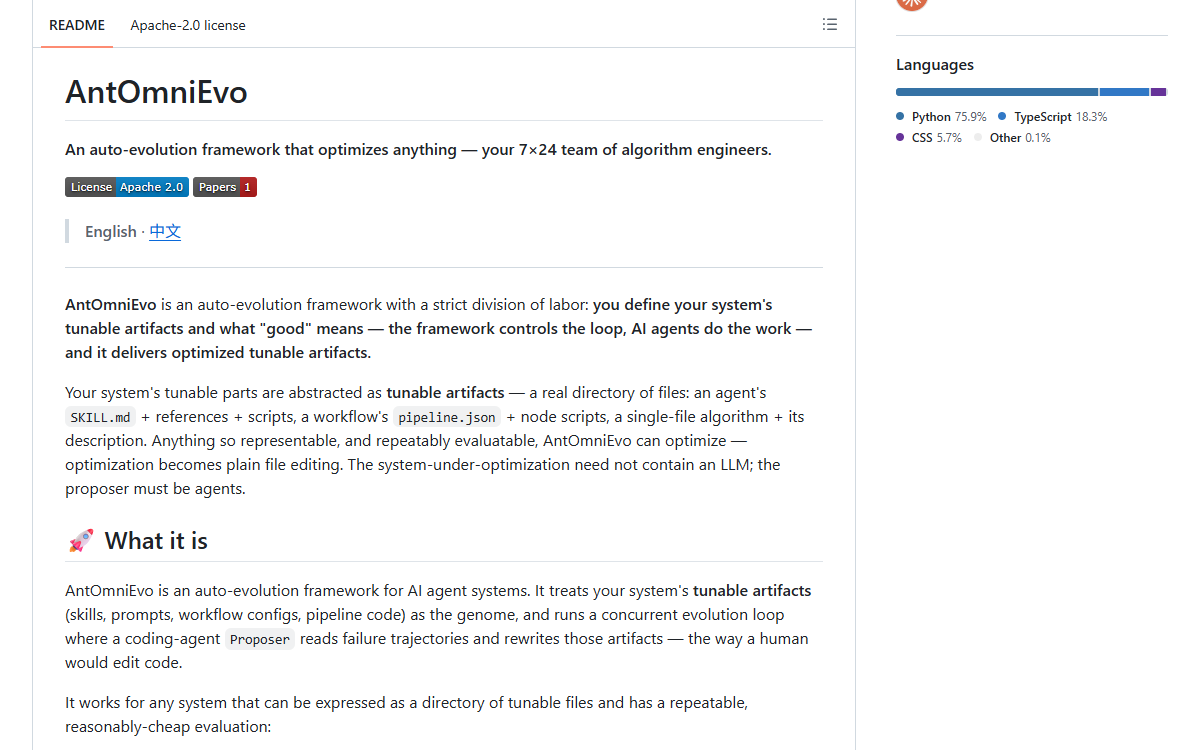
第 143 号
AntOmniEvo
把系统里可调的那部分抽象成一个文件目录,然后让 coding agent 反复改写它。框架负责调度、预算、选择与淘汰:父子候选跑在同一条训练批次上打分,只有越过阈值的改进才会拿到验证集上复评并留下。
第 140 号
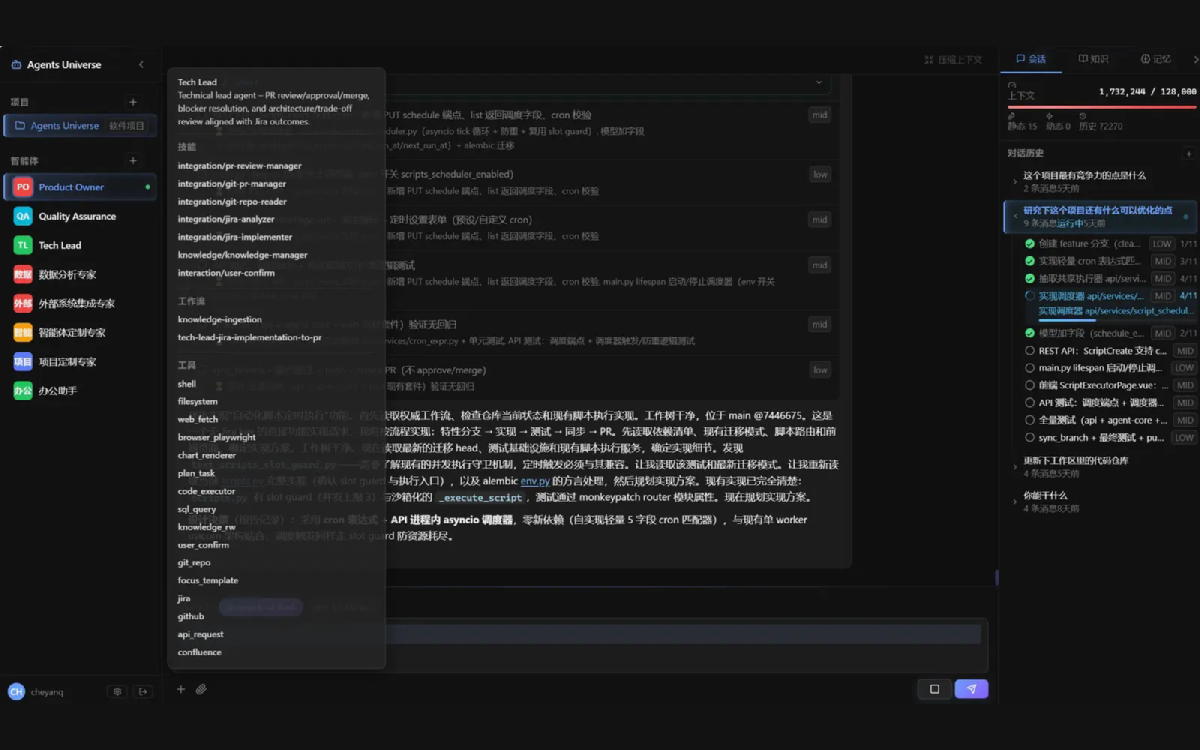
Agents Universe
一套开源智能体平台,让同一个项目里的人共用一份上下文。项目选中时智能体把全部知识读进上下文,干活过程中再把学到的东西写回同一批文件;知识是磁盘上的 Markdown,数据库只做索引,没有嵌入模型,也没有向量检索。
第 130 号
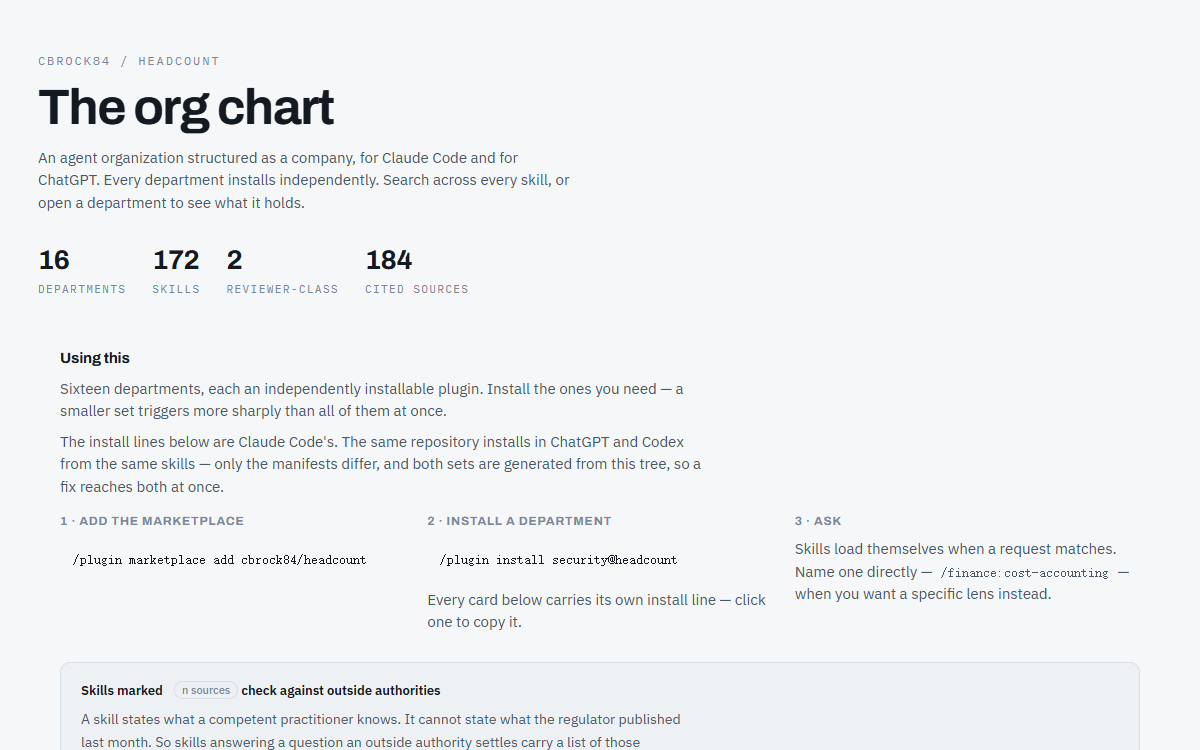
headcount
一个按公司组织的 agent 组织(一位首席执行官之下是十六个可独立安装的部门和 172 个技能:每个技能是一个 Markdown 目录,请求与它的描述匹配时自己加载;同一棵树既能装进 Claude Code,也能装进 ChatGPT,因为两边只有清单不同;而那 184 份真正裁决问题、而不是给答案做装饰的外部权威)监管机构、标准组织、成文法——就放在它们所服务的技能旁边,每一条都标着 agent 拿它可以做什么。