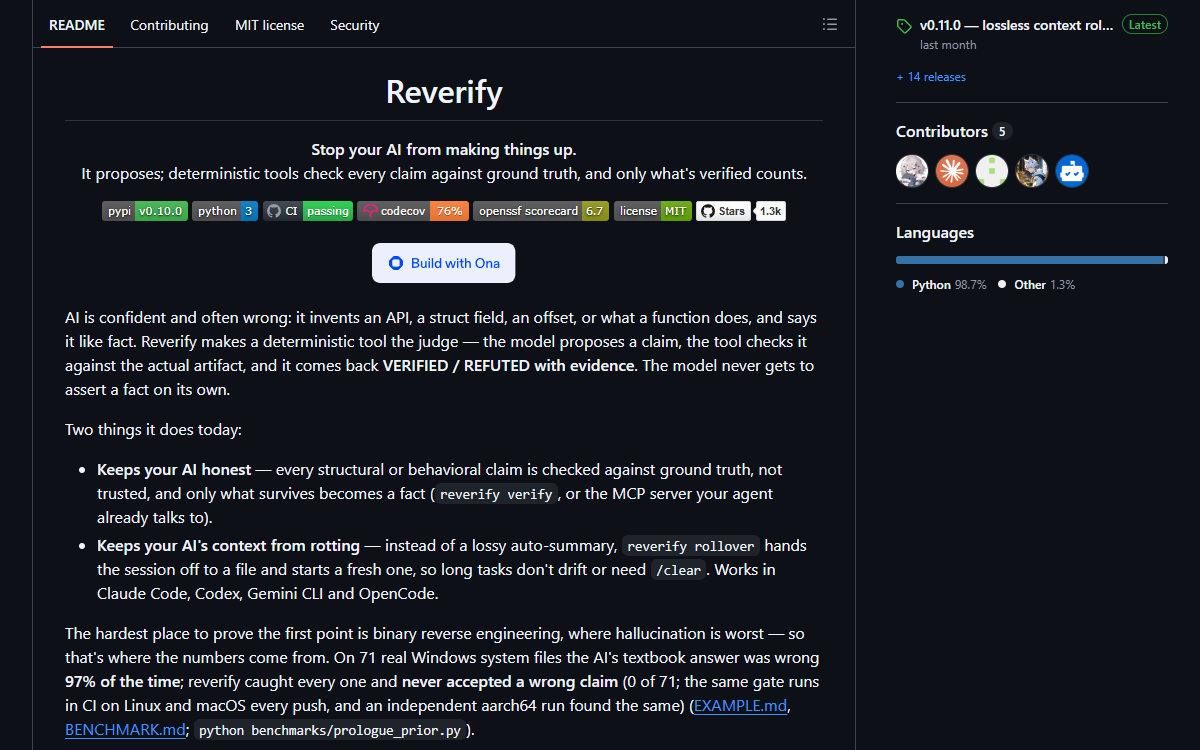
这是什么
给处理二进制文件的编码 agent 用的一层校验,形式是一个 Python 包,有 CLI 与 MCP server 两个入口。它自己那句描述最准确:「it proposes, deterministic tools decide, every claim checked against ground truth with evidence」。模型提出一条关于目标的 claim(某个偏移处的指令序列、一个导入、一个节、一次模拟执行的结果、一条调用边),工具对着真实字节去查,然后连它实际观察到的东西一起返回 VERIFIED、REFUTED 或 INCONCLUSIVE。仓库里「确定性」的那一半是代码而不是模型:verifier.py 装 claim 种类与判决,binary.py 与 pe_parser.py 解析 PE / ELF / Mach-O,disasm.py 反汇编,emulator.py 做 CPU 微模拟,behavior.py 把重建实现与原函数放在同一批输入上跑,semantic.py 站在 angr 上给函数边界与交叉引用,backends.py 报告当前有哪些引擎在判。安装:纯 Python 内核用 pip install reverify,加 capstone / unicorn / lief / Z3 用 pip install "reverify[full]",angr 语义层用 pip install "reverify[angr]";之后用 reverify verify 校验一条 claim,用 reverify auto sample.bin --json 做快速分诊,或者跑 python reverify/mcp_server.py 把同一套工具交给 agent。
谁做的仓库所有者那个账号写了 83 次提交里的 74 次,占 89%;外部贡献者 IMGillusion 写了 5 次,dependabot 3 次,另有 1 次没有关联账号。74 次提交带共同作者尾注,其中 71 条指向某个 Claude 模型——Fable 5.1 占 47、Opus 4.8 占 21、Sonnet 5 占 3。
它是怎么搭起来的
组成 · 6一条「claim 与判决」的切分线,判决者是一套确定性工具;由此推出三件事,整个仓库的形状都是它们的后果。第一是信任落在哪里:模型可以提任何东西,但事实只能是工具报出来的,所以每条判决都附上它实际观察到的字节和一份回执(二进制的 SHA-256、版本、参与判决的引擎),而 claim 种类是按「可判定」挑的——定宽读、模式、助记符、模拟执行、差分执行、Z3 证明、angr 导出的调用边。第二是强度分档而不是一个词:proven 高于 tested 高于 observed,来自分析引擎的语义判决记在 VERIFIED 之下的 DERIVED 档,能力不在时答案是 INCONCLUSIVE——从不猜。第三是状态由判决派生而不是由文字派生:按二进制存放的账本保存已验证、已观察、已证明与已否定的结果,并且按内容取键,于是新会话或新进程都从同一个有根据的位置继续,而模型自己的笔记只有标了「未验证」才被带过去。可靠性不是断言而是测量:基准与逐种类的混淆矩阵在三个平台的 CI 里跑,只要有一条错误断言被判为 VERIFIED 就让构建失败,每次运行都留下每个文件哈希与每条判决的记录。
- reverify/
- 包本体:23 个文件、436 KB。
verifier.py(60 KB)装 claim 种类与判决;cli.py(39 KB)是命令面;agent.py(28 KB)跑「提出—校验」循环;rollover.py(27 KB)与rollover_harness.py(97 KB)负责会话交接;ledger.py(27 KB)保存按二进制的状态;mcp_server.py(21 KB)把同一套工具经 MCP 暴露出去。behavior.py、emulator.py、disasm.py、binary.py、pe_parser.py、semantic.py、exebench.py、protocol_parser.py是读取器与判决者,sandbox.py给原生执行划边界,boundary_auditor.py与frida_bridge.py是两个边缘工具,backends.py报告装了哪些引擎,plugins/opencode/reverify-rollover.js(6.6 KB)是唯一的插件,随包数据发布。 - reverify/tests/
- 29 个文件、244 KB——按体积约占包内 Python 的 36%。最大的是
test_rollover_harness.py(42 KB);真正承担论证的是test_differential.py与test_oracle.py,它们拿 lief、capstone、objdump 与人工核过的向量去核读取器,而不是对着自己写下的预期,旁边还有test_verifier.py、test_probes.py、test_hardening.py、test_mcp.py。跑法:python -m unittest discover -s reverify/tests -p "test_*.py"。 - benchmarks/ 与 benchmarks/results/
- 9 个基准文件(65 KB),下面是 5 个文件的语料(19 KB)和 15 份提交进仓库的运行记录(605 KB——全仓最大的目录)。
prologue_prior.py、hallucination_probes.py、verifier_matrix.py是三道带闸门的测量;reconstructions.py与reexec_dataset.py是「可重新执行」那一侧;model_loop.py让真实模型走一遍 OpenAI 兼容端点;语料里是两个 C 库加上reconstructions.jsonl与reexec_sample.jsonl;results 里是每份都带文件 SHA-256、每条判决与工具版本的 JSON 记录。 - .github/
- 7 个工作流(14 KB)加一个 4.6 KB 的评审脚本。
ci.yml(6 KB)在三个平台上跑测试套件与两道带闸门的基准,只要有一条错误断言被判为 VERIFIED 就失败;release.yml负责发到 PyPI;其余是angr.yml、model-eval.yml、fuzz.yml(每晚两万个畸形输入)与scorecard.yml。三份 issue 模板里有专门的 false-VERIFIED 报告表,codex_review.py由codex-review.yml驱动。 - 仓库根目录
- 13 个文件、95 KB——设计就在这里,而不在一份设计文档里。
README.md(26,462 字符)讲校验循环、账本与语义层;BENCHMARK.md(15 KB)是测量本身以及如何老实读它;ROADMAP.md(4.8 KB)写明两条它想守的护城河并给工作排序;CONTRIBUTING.md(2.6 KB)写下整个项目围绕的那一条规矩;CHANGELOG.md39 KB;pyproject.toml声明零个必需依赖和两个入口,reverify与reverify-mcp。 - docs/
- 只有一个文件:
docs/demo.svg,2.2 KB,就是嵌在 README 里的那段终端录像。整个仓库没有任何架构文档——设计在 README、路线图与贡献指南里——所以上面这份结构是读自文件树与那几份文档,而不是读自一份规格说明。
取舍,以及它替代了什么
纯 Python 的确定性内核,成熟引擎只作可选件 替代 一开始就依赖 capstone、unicorn、lief、Z3 或 Ghidra
README 与打包方式里都写着:「Pure Python out of the box; installs clean with no Ghidra」,
pip install "reverify[full]"会原地升级这套工具,引擎不在时退回内核——「Not installed? It falls back to the pure-Python core.」CONTRIBUTING 把这一点当作承重结构:「The pure-Python fallback must keep working with no compiled dependencies; CI checks that too.」pyproject.toml的必需依赖是空的。函数与交叉引用站在 angr 上,自己那一层保持很薄 替代 自己写函数边界与控制流分析,或者让模型去猜
README:「Reverify does not build one. It stands on angr ... and keeps its own part thin」,只保留一个与引擎无关的视图。附在它上面的诚实条款是:CFGFast「是启发式的,可能漏掉或切错函数」,所以语义判决会写明引擎,并且记在 VERIFIED 之下的
DERIVED档;没有引擎时,纯 Python 回退只回答它独立确定的东西,其余一律 INCONCLUSIVE——「never a guess」。原生执行默认关闭,需要环境变量才开 替代 只要被问就编译并运行调用方给的 C 源码
维护者在 pull request 11 里给的理由:「behavior_equiv 在 Unicorn 里跑代码;这一条会在宿主机上编译并运行它,而一条 claim 的 c_source 是任意代码——任何 agent 都能经 MCP server 触达。现在除非设了 REVERIFY_ALLOW_NATIVE_EXEC=1,它返回带提示的 INCONCLUSIVE(对一个暴露给不可信 agent、又没有沙箱的 MCP server 来说,永远不该开)。」
换一个会话,而不是给会话做摘要;交接缺失时失败要「关门」 替代 由模型写一份压缩摘要
README:「instead of a lossy auto-summary, reverify rollover hands the session off to a file and starts a fresh one」。交接文件是「在模型还握着完整上下文时写下的、形状固定的文件,与已验证事实(记忆文件、账本)分开——而产生它的那段对话是被丢掉,不是被改写。零依赖;钩子失败时放行,rollover 失败时关门。」随后写出的回执带转写文本的 SHA-256 与用户第一条、最新一条消息的原文。
用二进制本身给一条已通过的断言打分 替代 数通过了几条断言,把「全部通过」当目标
README:「Every claim verified is trivially reachable: assert that the file starts with MZ and that .text exists.」所以权重是「对只是复述模型看过的事实清单、重复、……的一律为零,其余从二进制本身量出来——预期内容在这个文件里出现得多频繁、熵有多高」,而只有在没有任何东西被否定、且通过项的信息量达到
--min-information(默认 1.0)时,一次重建才算 grounded——README 说这一条沿用了 FActScore 的 CORE 改法。
依据仓库里没有设计文档:docs/ 下只有一个文件 docs/demo.svg,109 个文件里也没有任何一个是以架构或设计命名的。所以这份描述读自文件树及其各目录体积、pyproject.toml,以及确实存在的那些散文——README(26,462 字符:「What Reverify does」「The verification loop」「The ledger」「The semantic layer」与工具表)、ROADMAP.md、CONTRIBUTING.md、BENCHMARK.md、benchmarks/README.md、EXAMPLE.md,以及各 pull request 的正文。
制作过程
6 个阶段- 01
六天、83 次提交、15 个 release
仓库建于 2026-08-31。第一次提交是 2026-09-02 的「Reverify v0.0.0 - verified reverse-engineering toolkit」,最后一次是 2026-09-07——一次给 CI 依赖锁版本号的改动,走的是 pull request 18。83 次提交全部落在 2026 年 9 月,15 个 release 全部落在三天里:从 2026-09-02 14:15 的
v0.1.0(副题「verification core」)到 2026-09-04 18:13 的v0.11.0(「lossless context rollover across Claude Code, Codex, Gemini CLI, OpenCode」);另有一个v0.0.0标签,背后没有 release。值得读的是提交签名:所有者那个账号写了83 次里的 74 次,外部贡献者 IMGillusion 写了 5 次,dependabot 3 次,还有 1 次没有关联账号;74 次提交带共同作者尾注,其中 71 条指向某个 Claude 模型——Fable 5.1 占 47、Opus 4.8 占 21、Sonnet 5 占 3。2026-09-07 之后没有新的推送,仓库当前是 1,252 个星、237 个 fork。 - 02
工作单位是 claim,判决者是工具
reverify verify接收一条关于二进制的 claim,返回 VERIFIED、REFUTED 或 INCONCLUSIVE,并附上工具真正读到的字节。claim 是 JSON,--claims-file可以批量喂,一条 claim 能用depends_on声明依赖,于是根被否定时建在它上面的断言一起失效;只要有东西被否定,命令就以非零码退出,CI 因此可以拿它当闸门。claim 种类对应那套确定性内核:定宽读(u16_at、u32_at、u64_at)、pattern_present、string_present、instructions、emulate_result、behavior_equiv(把原函数与候选实现放在同一批输入上跑)、prove_equiv(Z3,对所有输入成立)、protobuf_field、import_present、export_present、section_present,以及站在 angr 上的function_at、calls、references与reachable_from_entry。「全部通过」不算成功——README 说这个条件唾手可得:断言文件以MZ开头、断言.text存在就够了——所以每条结果都带一个从二进制本身量出来的权重,复述已知事实、重复、回显工具自己输出的一律为零;只有在没有任何东西被否定、且通过项的信息量达到--min-information时,一次重建才算 grounded。reverify reconstruct --samples N每轮多提几个候选,由校验器而不是模型的自信来挑。 - 03
作者自选的验证场:逆向工程
这些数字来自哪里,是作者自己的说法,不是外人的判断:README 写的是二进制逆向「最难证明第一件事」,所以「数字从这里来」;仓库那句一句话简介则以「Reverse engineering is the proving ground」收尾。探针把一个固定的模型先验盲着用上去——按 BENCHMARK.md 的说法,语言模型被问到函数入口序言时倾向于回答教科书式的帧指针序言
push rbp ; mov rbp, rsp——判决的只有校验器。在 71 个真实的 Windows 系统文件上,这个先验错了 69 次,97%,而校验器没有把任何一条错误断言标成 VERIFIED。同一道闸门在每次推送时于 Linux、Windows、macOS 上跑,「只要有一条错误断言被标为 VERIFIED 就让构建失败」;三个 runner 上分别是 40/40、77/77、68/68 全错、零误收,与参考运行以及一位贡献者在 aarch64 上的运行合起来是275 个二进制、4 种格式、0 次错误 VERIFIED。这份文档也把话说清楚了:0/71意味着「比率低于约 5%(95% 置信)」,而不是零;而且这个先验只是入口点上的一个探针,不是一次普查。 - 04
连校验器自己也被校验
这个项目的主张是「确定性工具能判定这类问题」,所以测试怎么排也是论证的一部分。文件树里 109 个文件,其中 29 个是测试——244 KB 对它所覆盖的包 436 KB,按体积约占 Python 代码的 36%;最大的测试文件
test_rollover_harness.py有 42 KB,对着仓库里最大的源文件rollover_harness.py(97 KB);判决者本身verifier.py是最大的单个模块,60 KB。测试不是唯一的检查:CONTRIBUTING 要求「改了行为就带一个不修就会失败的测试」,凡涉及读取器(解析器、反汇编器、模拟器)都更希望用差分测试或已知答案而不是手写的预期;README 说这些读取器是「由独立的裁判、而不是它自己的测试」对着 lief、capstone、binutils 的 objdump、Unicorn 与导出表核过的,CI 会在有和没有可选引擎两种情况下、在 Python 3.9 与 3.13 上各跑一遍,另有一个每晚对两万个畸形输入做模糊测试的任务。已发布的测试数不是最新的:README 的 Status 一节还写着v0.9.0与「Tested with 208 unit tests」,而pyproject.toml与最新 release 都是0.11.0;2026-09-11 开的一个 pull request 里写的是「377 tests pass locally」,另有 62 个因缺可选引擎而跳过。 - 05
另一半:能熬过上下文重置的状态
第二件事是让 agent 的上下文不说谎,这一半的设计更特别。
v0.8.0起,循环的状态在发生时就写盘:.reverify/ledger/<sha256>.json,一个二进制一份账本,按内容取键,所以改过名的副本共用同一份账本,每一轮之后都记一次检查点;被否定过的结果以 KNOWN FALSE 保留,于是新上下文不会再把同一个错误先验重新提一遍——而且写进去的只有工具验证、观察、证明或否定过的东西,模型自己的笔记是刻意排除在外的。reverify rollover把同一条规则用到交互式会话上,覆盖 Claude Code、Codex、Gemini CLI 与 OpenCode:内置的自动压缩被关掉,模型必须写一份固定分节的交接文件,挂在 harness 停止钩子上的守卫会拦下一次停止来催它;只有在守卫确认那份交接文件确实被重写、格式也没问题之后,才会写回执,回执里带转写文本的 SHA-256 和用户第一条与最新一条消息的原文。install会接入四个 harness,每个都留备份并且有对应的uninstall;doctor报告那些没有任何启动器消费过的回执——文档点名了这个失败:绕过启动器自己开的会话「没有上限(有一次实测会话涨到 909k tokens 才被主人发现)」。 - 06
issue 列表对这套设计做了什么
这份记录里最好的一回合是 2026-09-05 提的 issue 14。当目标写得开放式时,模型会从结构化 claim 种类上漂走:在
/usr/bin/ls上问「find the dynamic import list」,它给出 14 条通过校验的import_present;在/usr/bin/cat上问「the binary dynamically imports the close function from libc」,它一条 import 断言都没提,始终没有完成,账本里塞满原始字节读取。原因是agent.py里的 RULES 块只推荐了那些原始种类;修法是追加一行,而且同一个帖子里带着前后对照——未修 0/2 条结构化断言,加上那句提示后 100%——还为它提交了一个基准脚本。pull request 11 展示的是维护者另一面的标准:他没有把一个贡献者的适配器退回去,而是直接把两处必须的改动推到对方分支上,其中一处把原生执行改成需要环境变量才开启。与此相对,三条关于校验器本身的报告在这份记录取样时仍没有维护者的回复:issue 22(什么都不主张的断言——空字符串、全通配的模式、零字节——也会 VERIFIED 并计入分数)、pull request 21(针对它的修复,2026-09-11 开着,评论只有机器人),以及 issue 23:当 symbol 字段写错名字时,import_present会静默退化成「这个 DLL 到底有没有被导入」,然后返回 VERIFIED——报告人次日通过 MCP server 拿notepad.exe复现了它。按这个项目自己写下的规矩,这是它能收到的最有价值的报告;而 README 里那个「零误收」的数字,正是靠它站着的。
相关档案
全部档案 →第 081 号
pgbot
一个静态 Go 二进制,只读地连上 PostgreSQL,读服务器自己的统计视图,打出一份以 finding 为先的体检报告——因为每次运行都会在本地存一份基线,它还能说出「与上次相比变了什么」;同一批确定性 finding 通过 MCP 交给 AI agent,而可选的 AI 层只被允许解释它们。
第 080 号
HarnessRouter
HarnessRouter 的自托管、Apache-2.0 版本:把十六种现成的 agent CLI——Codex、Claude Code、Hermes、DeepSeek Harness 以及另外十二种——放到同一个兼容 OpenAI Responses 的 API 后面,会话、流式进度、文件、取消与结构化失败都在里面;它实现的那套 Unified Harness Protocol,以及用来度量它的 conformance 套件,也一并放在这个仓库里。
第 070 号
OpenChatCut
一个本地优先的视频剪辑器,剪辑方式是跟它说话:内置 agent 与外部 Codex、Claude Code 会话调用的是界面自己在用的同一套剪辑工具,于是每一处改动都落在一条真实的多轨时间线上——是片段、转场、字幕、特效或音频,仍然能拖、能撤销、能导出。工程与素材留在本机,预览与最终渲染都出自 Remotion。