上线时间 2024年4月

这是什么
这是一个研究 agent 工具接口的项目:给一个 GitHub issue 就尝试自动修复,主张模型做不好软件工程是工具造成的。
它真正的贡献是一个概念,而不是一个产品:Agent-Computer Interface(ACI),主张模型做不好软件工程,部分原因是给它的工具是为人设计的。
团队围绕模型重新设计了命令和反馈格式,报告在 SWE-bench 上解决了 12.29% 的 issue,是当时的最优结果。
谁做的
SWE-agent 出自普林斯顿大学的一个研究组,而不是一个产品团队:NeurIPS 2024 论文列了七位作者——John Yang、Carlos E. Jimenez、Alexander Wettig、Kilian Lieret、Shunyu Yao、Karthik R. Narasimhan、Ofir Press,仓库的第一次提交由 Jimenez 完成。七人中有六人同时是 SWE-bench 的作者,本档案里 12.29% 这个数字就是在那一套基准上测出来的,基准由同一个组在 2023 年 10 月发表(arXiv:2310.06770)。仓库此后累计 101 位贡献者;这个组的后续项目 EnIGMA 把这套界面思路搬到 CTF 安全题目上,合作方是特拉维夫大学与纽约大学的研究者。
制作过程
3 个阶段- 01
把问题重新定义成界面问题
研究问题不是「哪个模型最强」,而是「模型该看到什么」。团队设计了专门的命令和输出格式,让语言模型能浏览仓库、查看、编辑、执行代码,而不必去啃那些为人眼设计的终端输出。他们把这套东西命名为 Agent-Computer Interface。
- 02
一个有日期的数字
在 SWE-bench 测试集上解决 12.29% 的 issue,2024 年 4 月的最优结果。写这份档案时这个数字已经过去了两年,引用时必须带上日期:一个没有日期的基准分数会被读成当下的水平。
- 03
研究者自己推荐了后继项目
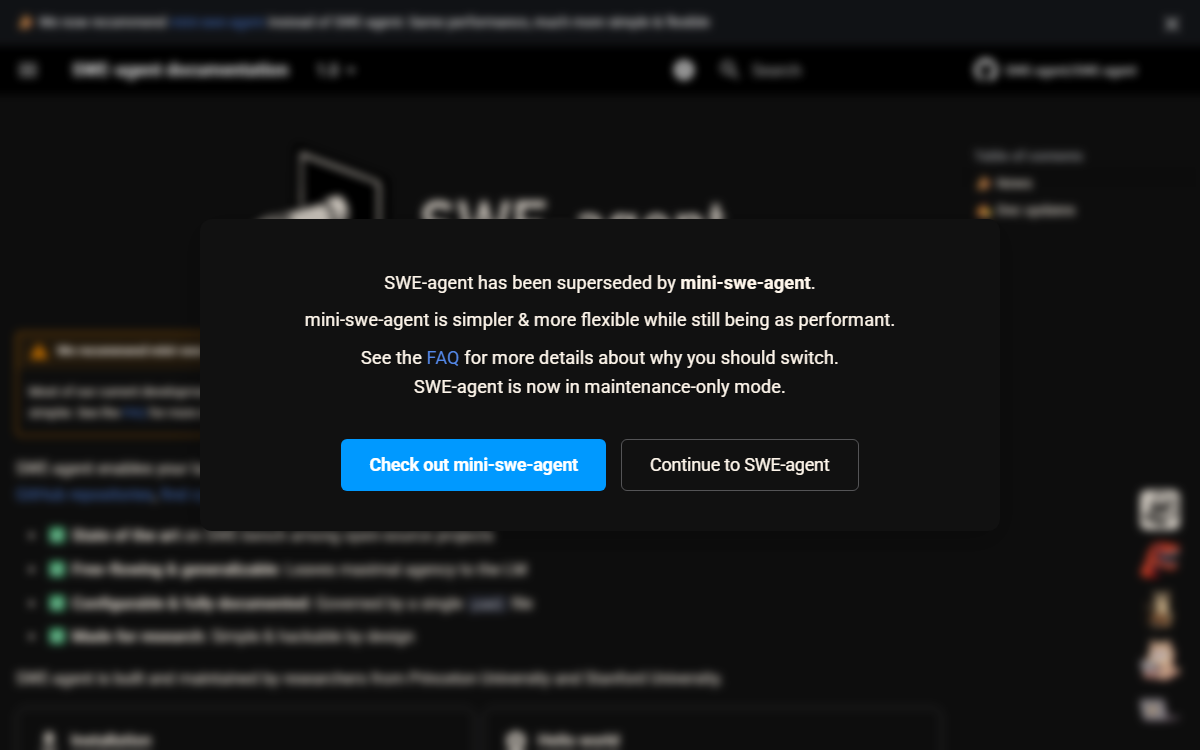
SWE-agent 的文档顶部挂着一条横幅,推荐改用 mini-swe-agent,称其「性能相同,但简单和灵活得多」。原项目仍在维护,但写它的人建议新用户去别处。
他会告诉你什么
- 进展停滞时,模型与工作之间的界面是一个正当的着手点——不只是模型本身。
- 基准成绩是一种带保质期的声明,发布时就应该带上日期。
- 一个会推荐自己替代品的研究项目是在尽职,不是失败。
相关档案
全部档案 →
第 128 号
sepia
一个可移植的去 AI 味写作技能:一套规则文件配四个操作,小说先修叙事结构再谈用词,专业文稿按场合套一份薄薄的规则文件,而每条规则都标着它是被测出来的、被咨询过的,还是这个项目自己的推断。
第 127 号
Lemmalog
一个用 Rust 写的 Datalog 引擎,它把 agent 记忆当成演绎数据库,而不是一个更大的向量库。事实在抽取边界断言,分层规则推导闭包与时态视图,每条派生事实都带着回到来源 episode 的溯源,派生视图按 epoch 增量维护,并以十二个 MCP 工具的形式交给 Claude Code 与 Kimi CLI 使用。
第 143 号
AntOmniEvo
把系统里可调的那部分抽象成一个文件目录,然后让 coding agent 反复改写它。框架负责调度、预算、选择与淘汰:父子候选跑在同一条训练批次上打分,只有越过阈值的改进才会拿到验证集上复评并留下。